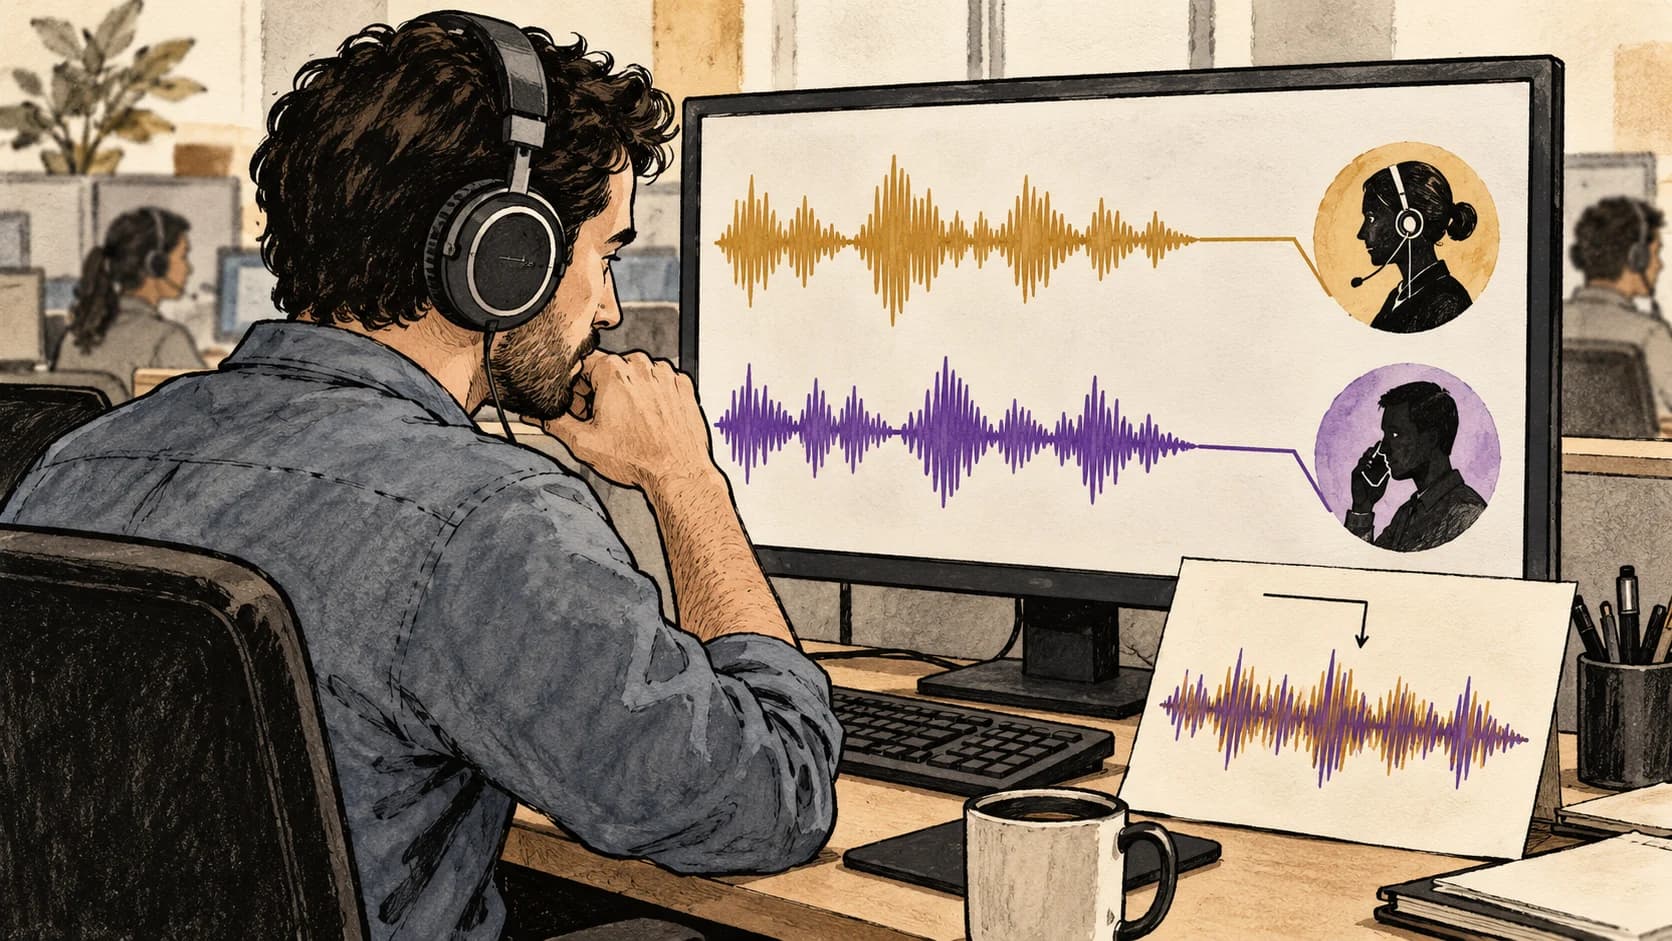
*Концептуальная иллюстрация сценария; не снимок продукта, клиентского проекта или выполненного теста.*
Если в расшифровке звонка перепутаны оператор и клиент, сначала разделите три сущности: аудиоканал, голос и бизнес-роль. Канал — часть записи, диаризация группирует речь по говорящим, а роль связывает группу с участником процесса. Замена распознающей модели не исправит ошибку, если приложение неверно подписывает уже правильно разделённые реплики.
Материал предназначен владельцам речевой аналитики и разработчикам телефонии. Разбираем предзаписанные звонки и документированные возможности Yandex SpeechKit API v3. Документация проверена 27 октября 2026 года. Для технических ссылок использован доступный русскоязычный раздел документации региона Казахстан; это не обещание одинаковых endpoint, тарифов или доступности во всех регионах. Запросы в SpeechKit, прослушивание реальных звонков и замеры качества здесь не выполнялись.
Короткий ответ: если голоса сохранены раздельно, используйте эту информацию до смешивания записи. Если доступно только моно, рассматривайте определение дикторов в пределах документированных ограничений. Номер группы не назначает человеку роль «оператор» автоматически.
Содержание
- Почему правильно распознанные слова получают чужую роль
- Что находится в исходной записи
- Когда использовать каналы
- Когда нужна диаризация
- Как связать метку с оператором
- Почему реплики дублируются
- Как найти причину по симптомам
Почему правильно распознанные слова получают чужую роль
В предложении «Я оформлю возврат» слова могут быть распознаны верно, а подпись — ошибочно. Для сотрудника это выглядит как ошибка ИИ вообще. Для исправления нужно выяснить, на каком уровне она появилась: звук неверно разделили, голосу присвоили другую группу или правильную группу связали с неправильной ролью.
Диаризация отвечает на вопрос «какие фрагменты принадлежат одному говорящему». Ролевая разметка отвечает на другой вопрос: «кто этот говорящий в процессе обслуживания». Голосовая группа не содержит по определению должность человека или его идентификатор в CRM.
Предлагаемый пример: в одном звонке первой начинает сотрудница, а в другом — клиент. Правило «первая реплика всегда операторская» даст ошибку во втором случае даже при безошибочном разделении голосов. Причина находится в правиле приложения, а не в расшифровке слов.
Поэтому качество следует оценивать отдельно для текста и для принадлежности реплик. Общую архитектуру процесса мы рассматриваем в статье о речевой аналитике звонков. Здесь сосредоточимся на узкой проблеме: сохранении правильного участника разговора.
Что находится в исходной записи
Расширение файла не говорит, разделены ли голоса. В стереозаписи могут быть разные участники по каналам, а могут — две копии уже смешанного разговора. Во втором случае наличие двух каналов не возвращает утраченное разделение.
Для диагностики предлагаем получить исходный файл до конвертации, описание экспорта телефонии и сведения о числе каналов. Затем отдельно прослушать каждый канал в аудиоредакторе. Это предлагаемый порядок проверки ваших данных, а не выполненный нами эксперимент.
| Что обнаружено | Что это означает для выбора подхода |
|---|---|
| В каждом канале преимущественно свой участник | Можно опереться на канал и подтверждённую схему записи |
| В обоих каналах один и тот же разговор | Нужна работа со смешанной речью; формальный стереоформат не помогает |
| Только моно с двумя участниками | Рассмотреть определение дикторов для совместимого режима |
| В разговоре появляется третий участник | Ограничение конкретной функции становится существенным |
Не уничтожайте исходник при подготовке файлов. Преобразование стерео в моно объединяет каналы; после этого восстановить исходную принадлежность простым чтением метаданных уже нельзя. Если предыдущая система сохранила связь с каналами отдельно, используйте и её.
Когда использовать каналы
Для предзаписанных многоканальных файлов в SpeechKit предусмотрен асинхронный режим. В общей таблице документации для него указаны два распознаваемых канала, тогда как для потокового режима — один. Способы распознавания SpeechKit.
Отсюда следует выбор по задаче. Если анализируется уже состоявшийся разговор с раздельными дорожками, нет необходимости превращать его в онлайн-диалог только потому, что в SDK есть потоковый пример. Нужно сохранить свойства файла и выбрать совместимый маршрут обработки.
Канал полезен как техническая опора, если известно, что телефония в него записывает. Но утверждение «левый — всегда оператор» должно подтверждаться форматом экспорта вашей системы. Само слово «стерео» такого соглашения не устанавливает.
Для передачи сырого аудио также существенны параметры кодирования. Документация SpeechKit описывает LPCM как данные без WAV-заголовка и задаёт требования к представлению отсчётов. Не выдавайте контейнерный WAV за сырой LPCM только из-за сходства звука при воспроизведении. Поддерживаемые форматы.
В API v3 описание формата аудио отделено от содержимого записи. Конкретные поля и типы проверяйте в справочнике AsyncRecognizer, а не переносите названия параметров из старого примера API v2.
Когда нужна диаризация
В специальной документации SpeechKit определение дикторов описано для API v3, режима FULL_DATA и монозаписей, не более чем с двумя дикторами. В примере включено SPEAKER_LABELING_ENABLED; ответы получают метки channel_tag. Определение дикторов.
Это существенная граница применимости. Функция для моно не является способом автоматически получить роли участников любой конференции. Если на линии оказались клиент, оператор и переводчик, такой разговор уже выходит за описанное ограничение по числу дикторов.
Обратите внимание и на модель в официальном примере: там используется general:rc. На странице моделей rc обозначена как версия-кандидат, а не универсальное имя для всех производственных запросов. Перепроверьте текущую совместимость нужной функции и выбранной версии. Модели и теги версий.
Не следует объединять все найденные в документации возможности в один вымышленный режим. Наличие потокового распознавания и отдельного определения дикторов не доказывает поддержку этой комбинации для любой конфигурации. Для уже записанного файла выбирайте описанный файловый сценарий.
Как связать метку с оператором
Не зашивайте правило channel_tag = 0 → оператор. В документации определения дикторов значения меток описаны как 0 или 1, а фиксированная нумерация прямо не гарантируется. Метка помогает разделить результаты; роль требует дополнительного основания. Описание меток в ответе.
Для разделённых каналов таким основанием может быть подтверждённая схема записи телефонии: какой leg и какой участник попадают в канал. При переводе звонка нужно учитывать, не изменилось ли соответствие. Это предлагаемые вопросы к интеграции, не заявление о поведении каждой АТС.
Для моно с диаризацией возможна отдельная процедура определения роли: по известному контексту звонка, проверенному приветствию или подтверждению сотрудником. Уверенная фраза модели «это оператор» сама по себе не заменяет фактическое основание. В неоднозначном случае полезнее оставить «Говорящий A», чем приписать обещание не тому человеку.
Предлагаемый внутренний формат записи, не объект ответа API:
{
  "speaker_group": "A",
  "business_role": "unknown",
  "role_basis": "not_confirmed",
  "text": "Я уточню условия возврата"
}
Раздельные поля помогают исправить роль, не переписывая распознанный текст. Они также позволяют исключить неопределённые реплики из автоматической оценки сотрудника до уточнения.
Почему реплики дублируются
Иногда проблема выглядит как «клиент и оператор сказали одно и то же», хотя приложение дважды добавило одну фразу. В SpeechKit есть промежуточные partial, окончательные final и нормализованные окончательные final_refinement. При включённой нормализации могут приходить и final, и final_refinement. Типы результатов распознавания.
Если обработчик считает каждый вариант новой репликой, стенограмма разрастается дублями. Это отличается от ошибки определения говорящего. Для устранения нужно понять жизненный цикл результата и выбранный способ обновления текста, а не менять подписи участников.
Предлагаем на уровне приложения заранее решить, какой результат становится окончательной отображаемой версией и как он заменяет предыдущую. Ключ для связи событий выбирается по фактическому контракту используемого API и вашим данным; здесь мы не предлагаем непроверенную универсальную формулу такого ключа.
Как найти причину по симптомам
| Симптом | Вероятное место ошибки | Что исследовать первым |
|---|---|---|
| Все роли зеркально поменялись | Привязка каналов или групп к ролям | Схему экспорта и таблицу соответствия |
| Путаются отдельные короткие реплики | Разделение смешанной речи или правило роли | Исходный звук и фактическую метку фрагмента |
| Обе дорожки содержат обоих участников | Запись либо ранняя конвертация | Исходник до объединения каналов |
| Каждая фраза появилась дважды | Обработка событий результата | Не добавляются ли final и refinement независимо |
| После перевода звонка подписи стали неверны | Изменение состава участников | События телефонии и соответствие участников |
Это диагностические гипотезы, а не установленные причины конкретного инцидента. Чтобы различить их, полезно взять один разрешённый к анализу звонок, сохранить исходный звук и посмотреть данные до назначения ролей. Если группа говорящего верна, а подпись уже нет, исправлять следует следующий уровень обработки.
Для сценария с моно предлагаем отдельно проверить смену первого говорящего и появление третьего участника. Для каналов — контролируемый пример, где известно, кто записан в каждом. Успешный результат проверки означает, что вы можете объяснить происхождение подписи; он не доказывает качество на всём архиве. Эти проверки читателю ещё предстоит выполнить.
Частые вопросы
Два канала гарантируют два разных голоса?
Нет. Каналы могут содержать одинаковую смесь. Требуется проверить фактическую запись и условия её получения.
Диаризация узнаёт имя клиента?
В описанной функции речь идёт о разделении фраз по дикторам. Имя, учётная запись и роль — дополнительные сведения приложения; статья не рассматривает биометрическую идентификацию.
Поможет ли другая модель распознавания?
Она может изменить текст и разделение речи, но не исправит неверное правило «нулевая метка — оператор». Сначала найдите уровень, на котором возникла ошибка.
Как AIrassvet помогает сохранить роли в речевой аналитике
Направления AIrassvet по мультимодальным интеграциям, обработке данных и тестированию относятся и к этому процессу. Предметом работы могут стать разбор формата записи, передача результатов распознавания в аналитику и проверка назначения ролей перед использованием в бизнес-системе. Это не обещание безошибочной идентификации участников.
Первый шаг — показать один доступный для анализа пример записи, текущую расшифровку и место, где система присваивает роли. Такое описание позволит отделить проблему аудио от ошибки интеграции. Обсудить задачу.
Итог
Правильная подпись реплики требует цепочки: запись сохранила нужные различия, распознавание вернуло корректные группы, приложение обоснованно связало их с ролями. Для раздельных голосов используйте подтверждённые каналы; для моно учитывайте ограничения определения дикторов. Если роль пока неизвестна, сохраните неопределённость — это полезнее для аналитики, чем уверенная неправильная подпись.