Strata — открытый движок инференса под лицензией MIT, который запускает большие MoE-модели на обычном компьютере: самые востребованные эксперты держит в видеопамяти, все остальные — в оперативной памяти и считает их на процессоре, а вспомогательную таблицу читает с SSD. Основная модель — Qwen3.8-Flash-Next; для неё нужно от 37,6 до 54,8 ГБ памяти RAM и VRAM вместе в зависимости от квантования. Strata ориентирована на одного пользователя и локальных агентов для программирования. Для многопользовательского сервера компании она не замена vLLM или SGLang.
Обзор подготовила AI студия Владимира Ломтева 17 ноября 2026 года по репозиторию Strata, его документации и независимому тесту AkitaOnRails. Мы не запускали Strata сами. Цифры скорости принадлежат авторам проекта или автору теста и относятся к их железу.
Содержание
- Что такое Strata
- Как Strata размещает модель
- Черновики и длинные тексты
- Сколько нужно памяти
- Поддерживаемое железо
- Установка и подключение
- Что показал независимый тест
- Strata, llama.cpp и vLLM
- Где Strata уместна в компании, а где нет
- Как оценить Strata на своих задачах
- Частые вопросы
Что такое Strata
Репозиторий Niko1221/Strata создан 24 сентября 2026 года и быстро обновляется: последний выпуск на момент подготовки — 0.2.15 от 16 ноября 2026 года. Проект распространяется под лицензией MIT, а модели — под собственными лицензиями их авторов. Движок построен с использованием частей llama.cpp и ggml и работает с файлами GGUF.
По README поддерживаются две модели:
- Qwen3.8-Flash-Next — основная модель проекта; рекомендуемые сжатые варианты от ISTA-DASLab, а также файлы Unsloth и других поставщиков;
- Qwen3.6-35B-A3B — меньшая модель для компьютеров со скромной памятью.
Автор независимого теста описывает Qwen3.8-Flash-Next как MoE-модель на 125 млрд параметров, из которых на каждый токен активны около 6 млрд.
Как Strata размещает модель
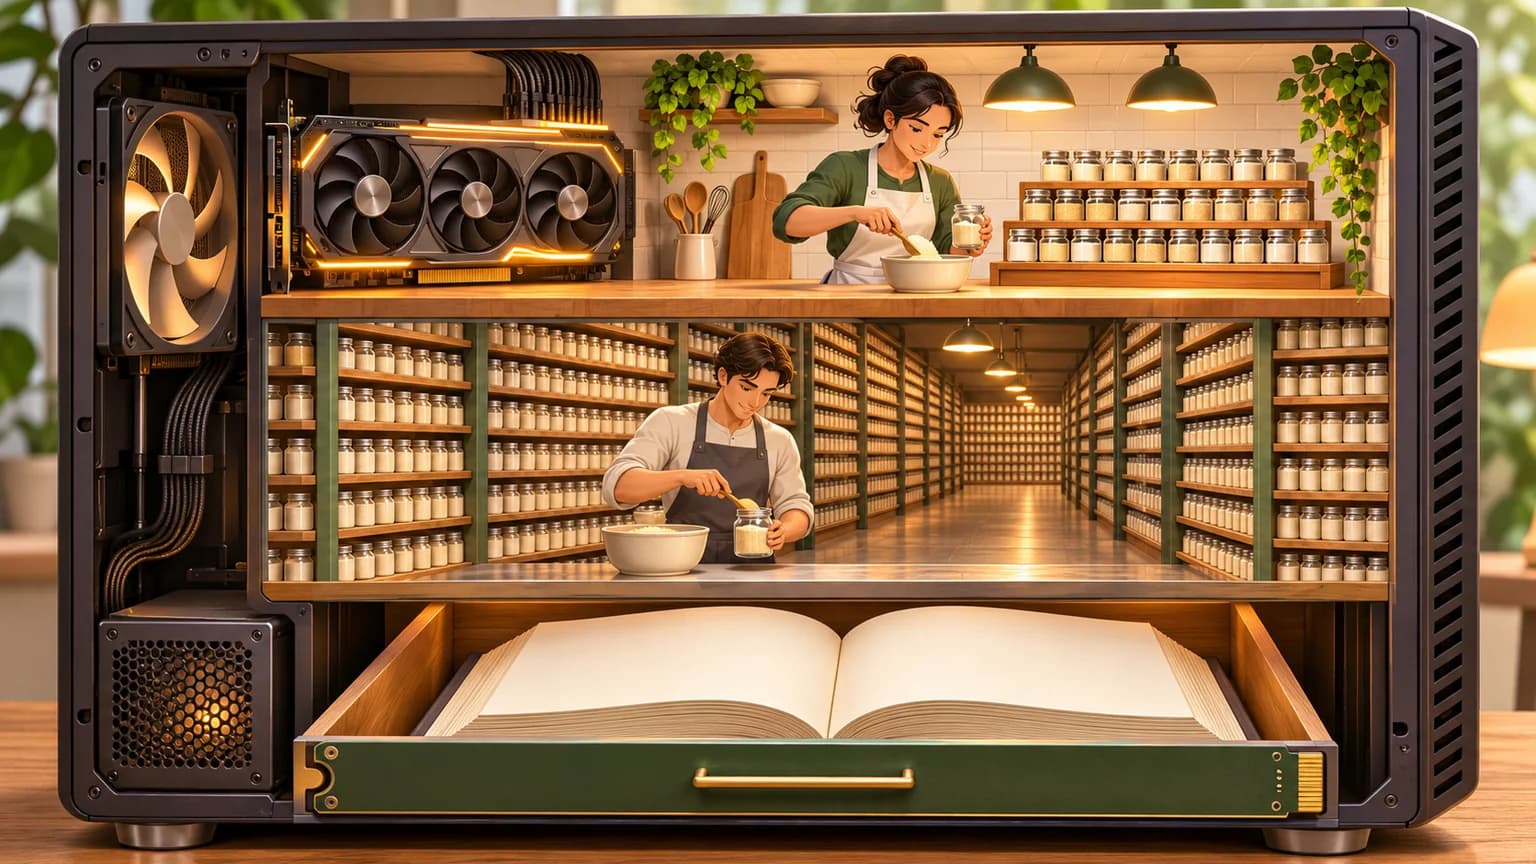
Документ «Как работает Strata» объясняет схему через три уровня памяти:
| Где | Что лежит | Кто считает |
|---|---|---|
| Видеопамять | Внимание и общие слои, роутеры, общие эксперты, выходной слой, слой MTP для черновиков, горячая часть KV-кэша и кэш самых востребованных экспертов | GPU |
| Оперативная память | Все 24 576 экспертов модели, закреплённые в памяти | CPU считает экспертов, которых нет на GPU, параллельно с видеокартой |
| SSD | Таблица n-грамм на 28,8 ГБ, из которой на каждый токен читается несколько строк | Через кэш операционной системы |
На каждое слово модели нужно только 10 экспертов из 24 576, поэтому держать их все в видеопамяти не обязательно. Кэш экспертов на GPU подстраивается под разговор. По словам авторов, каждый дополнительный гигабайт видеопамяти вмещает около 700 экспертов, поэтому объём VRAM важнее скорости самой видеокарты.
Похожие идеи появились и в больших проектах: в llama.cpp 1.0.0 добавлен кэш экспертов MoE в оперативной памяти с долей вычислений на CPU, а в SGLang 0.5.23 — опциональный режим Paged Experts для MoE-моделей, которые больше видеопамяти. Подробнее — в обзоре новостей локального инференса за ноябрь.
Черновики и длинные тексты
Strata использует встроенный в модель слой MTP для спекулятивного декодирования: он предлагает до трёх токенов, а основная модель проверяет их за один проход. По документации проекта это даёт 2,4–3,2 токена за проход и ответ в 1,6–1,8 раза быстрее при том же качестве. Когда ответ повторяет контекст, например при правке кода, дополнительно работает поиск по промпту. Как устроено спекулятивное декодирование, разобрано в статье «Спекулятивное декодирование: EAGLE, MTP и DFlash».
Длинные тексты читаются блоками до 8192 токенов, а экспертов следующего слоя движок подгружает на GPU по PCIe, пока считается внимание текущего. После первого сообщения Strata сохраняет состояние разговора и обрабатывает только новое.
Сколько нужно памяти
По таблице моделей для Qwen3.8-Flash-Next:
| Вариант | RAM + VRAM под модель | Качество по оценке авторов |
|---|---|---|
| Q2_0 | 37,6 ГБ | хорошее |
| IQ2_XS | 39,2 ГБ | лучше |
| IQ3_XXS | 47,0 ГБ | отличное |
| IQ3_S | 54,8 ГБ | лучшее, по их тестам совпадает с полной моделью |
Документация уточняет, что модель помещается, когда оперативной памяти не меньше, чем занимают эксперты, плюс около 10 ГБ для системы и программ; с 64 ГБ RAM подходят все варианты, с 48 ГБ — Q2_0 и IQ2_XS. Отдельный вариант Coder для программирования работает примерно с 32 ГБ RAM при подходящей видеокарте. Скачивание занимает 66–76 ГБ для трёх меньших вариантов, а при первом запуске загружается слой MTP примерно на 6 ГБ. Если оперативной памяти мало, экспертов можно читать с SSD, но это намного медленнее.
Как считать память для обычных моделей, разобрано в статье «Сколько VRAM нужно для LLM».
Поддерживаемое железо
По README: видеокарты NVIDIA GeForce RTX 20/30/40/50, AMD Radeon RX 7700–7900, RX 9060/9070 и AI PRO R9700 (RX 6800/6900 — экспериментально), Intel Arc на Linux, Apple Silicon M1 и новее, AMD Ryzen AI Max (Strix Halo) и NVIDIA DGX Spark на Linux.
Установка и подключение
Есть настольное приложение для Windows, Linux и macOS и терминальный вариант. Терминальная установка скачивает скрипт со страницы выпусков проекта:
curl -fsSL --connect-timeout 15 --max-time 120 \
  https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh
less install.sh   # прочитайте скрипт перед запуском
sh install.sh
strata launch
Мы добавили шаг просмотра скрипта: запускать скачанный из интернета установщик без чтения не стоит, особенно на рабочей машине. После запуска модели Strata поднимает на localhost API, совместимые с OpenAI и Anthropic, а команда strata connect показывает, как подключить Claude Code, Codex CLI, OpenCode и другие инструменты. Есть также сборка из исходников и Docker.
Что показал независимый тест
Автор блога AkitaOnRails опубликовал 22 октября 2026 года тест на своём компьютере: Ryzen 9 7950X3D, 96 ГБ RAM, RTX 5090 с 32 ГБ видеопамяти на восьми линиях PCIe. Он использовал вариант IQ3_S с контекстом 256 тысяч токенов и KV-кэшем в int8. Его наблюдения:
- генерация — около 159 токенов в секунду в типичной работе, по логам около 190 токенов в секунду на контексте 128K и около 175 на 256K;
- чтение примерно 100 тысяч токенов промпта занимало 16–20 секунд;
- в его собственном тесте на программирование конфигурация набрала 91 балл и прошла все семь этапов в OpenCode без подсказок;
- оперативная память заполнялась до 88 из 92 ГБ, и система начинала использовать своп; для освобождения видеопамяти под рабочий стол помог режим
--vram-elastic; - по умолчанию Strata обрабатывает один запрос за раз, и параллельные субагенты встают в очередь; холодный старт занимал 35–40 секунд.
Вывод автора: его железо — минимум для серьёзной локальной работы с кодом. Это тест одного человека на одной машине, а не независимый бенчмарк, но он хорошо показывает реальные ограничения.
Strata, llama.cpp и vLLM
| Strata | llama.cpp / llama-server | vLLM | |
|---|---|---|---|
| Цель | Крупная MoE-модель на одном ПК | Любые GGUF-модели на любом железе | Много пользователей на GPU-сервере |
| Модели | Qwen3.8-Flash-Next, Qwen3.6-35B-A3B | Широкий набор | Широкий набор |
| Параллельность | По умолчанию один запрос | Слоты | Высокая |
| Работа с памятью | Эксперты по GPU, RAM и SSD | Слои по GPU и CPU, кэш экспертов MoE в 1.0 | В основном видеопамять |
| Зрелость | Проекту около двух месяцев | Стабильный выпуск 1.0.0 | Зрелый проект |
Как запускать llama-server и чем движки отличаются в целом, разобрано в отдельных статьях.
Где Strata уместна в компании, а где нет
Уместна:
- на рабочей станции разработчика, когда код нельзя отправлять во внешний API, а нужна модель сильнее тех, что помещаются в видеокарту целиком;
- для пилота: проверить, справится ли крупная открытая модель с задачами команды, до покупки серверного оборудования;
- в закрытом контуре для одного-двух пользователей, если установку и модели перенести заранее.
Не подходит:
- как общий сервер для отдела: один запрос за раз и высокая нагрузка на RAM и CPU;
- там, где нужна стабильность и долгая поддержка: проект молодой, выпуски выходят каждые несколько дней;
- для моделей, которых нет в списке поддерживаемых.
Перед использованием в компании проверьте лицензии конкретных файлов модели и политику обработки данных на рабочих станциях. Как оформить запуск модели без доступа в интернет, описано в статье «LLM без интернета».
Как оценить Strata на своих задачах
- Проверьте объём RAM и VRAM по таблице моделей и оставьте запас для системы.
- Установите выбранный вариант модели и зафиксируйте версию Strata.
- Подготовьте 20–50 реальных задач команды: правки кода, разбор документов, ответы по внутренним материалам.
- Измерьте время чтения промпта, скорость генерации и использование памяти на этих задачах.
- Сравните качество с моделью, которую вы используете сейчас, на том же наборе.
- Решите, где модель будет работать: на рабочих станциях или на сервере с другим движком.
Частые вопросы
Strata — это форк llama.cpp? Нет, это собственный движок, который использует части llama.cpp и ggml и файлы GGUF. Сама Strata поддерживает ограниченный набор моделей.
Можно ли запустить в Strata любую GGUF-модель? Нет. По заметкам к выпуску 0.2.15 приложение загружает модели только своим движком, а он рассчитан на модели из списка поддерживаемых. Локальный файл GGUF можно подключить, если это совместимый вариант поддерживаемой модели.
Подойдёт ли компьютер с 32 ГБ RAM? По документации — для варианта Coder или в режиме с малым объёмом RAM при видеокарте на 24 ГБ. С маленькой видеокартой большинство экспертов будет читаться с SSD, и работа станет намного медленнее.
Есть ли форки под другие модели? Да, на GitHub появились форки сообщества, например Strata-DS для DeepSeek и Strata-GLM для GLM. Это отдельные проекты со своими заявлениями о скорости, которые мы не проверяли.
Как AI студия Владимира Ломтева помогает с локальными моделями
AI студия Владимира Ломтева разворачивает LLM на собственном оборудовании компаний, в том числе в закрытом контуре. Для оценки Strata и похожих движков это означает:
- подобрать модель и движок под имеющиеся рабочие станции и серверы;
- провести пилот на реальных задачах команды с замерами скорости и качества;
- сравнить вариант на рабочих станциях с общим сервером на vLLM или SGLang;
- подготовить установку, обновления и правила работы с данными.
Первый шаг — выбрать одну задачу, для которой нужна локальная модель, записать характеристики доступного компьютера и критерий, по которому результат будет считаться достаточным. Обсудить задачу.
Итог: большая MoE-модель на одном ПК стала реальной
Strata показывает, как разнести большую MoE-модель по видеопамяти, оперативной памяти и SSD и получить рабочую скорость на домашнем компьютере с 48–64 ГБ RAM. Это сильный вариант для локальной работы одного разработчика, но не для общего сервера компании. Оценивайте его пилотом на своих задачах и учитывайте молодость проекта.