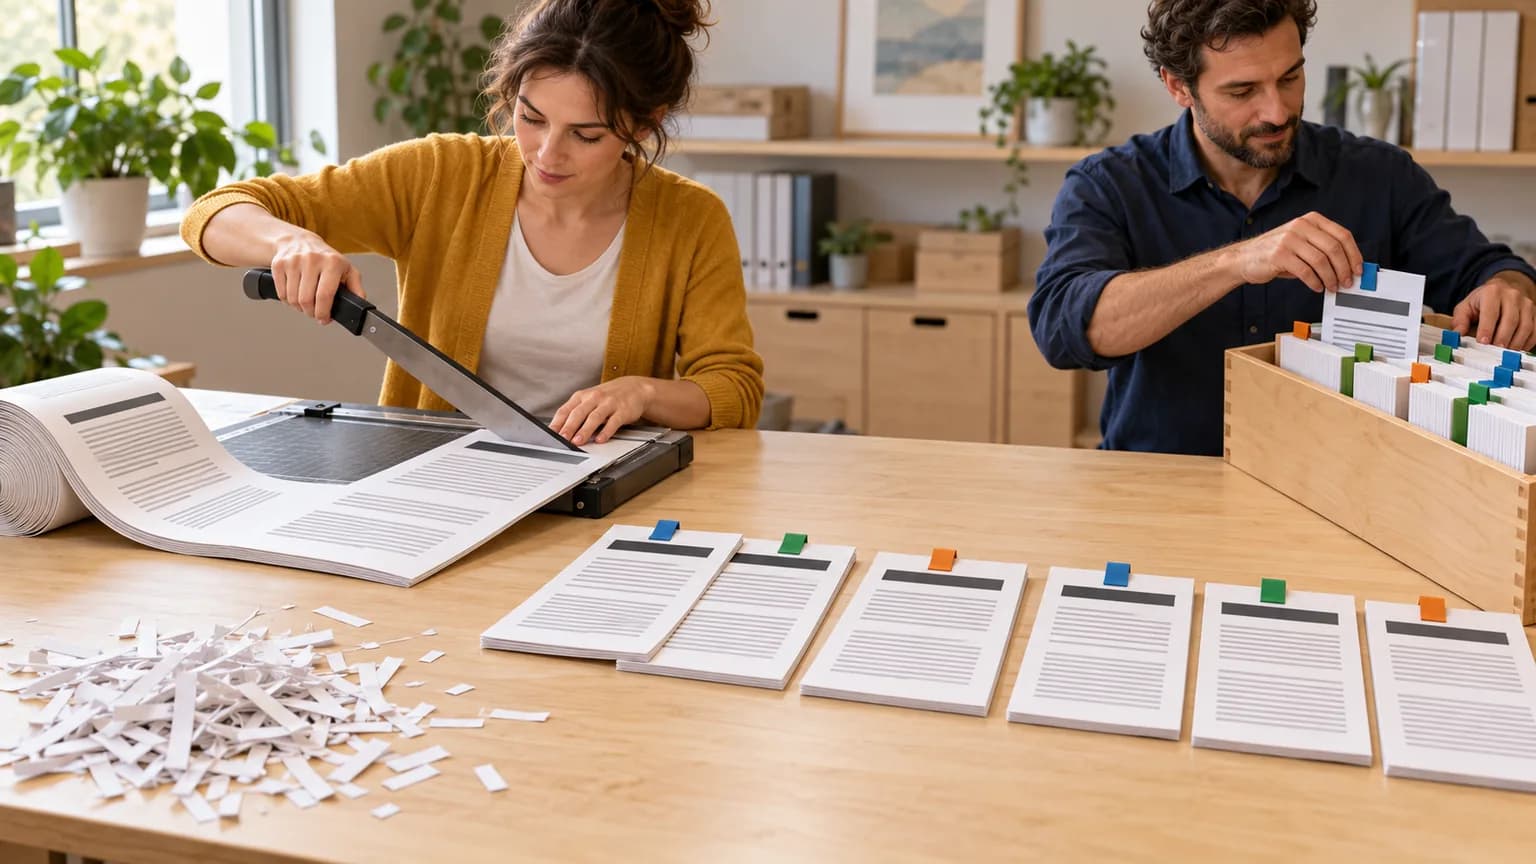
Чанкинг (chunking) — это разбиение документов на фрагменты, которые RAG-система индексирует и находит по вопросу пользователя. Настраивают его так: переводят документы в текст со структурой, режут по заголовкам и абзацам с лимитом в токенах (стартовая точка — 512–1 024 токена с перекрытием 10–25%), добавляют к каждому фрагменту название документа и раздела, а затем сравнивают 2–3 варианта на наборе реальных вопросов. Универсального размера нет: в исследованиях Chroma и NVIDIA лучший вариант менялся от корпуса к корпусу.
Материал подготовлен AIrassvet 22 октября 2026 года для ИТ-руководителей, аналитиков и разработчиков, которые запускают корпоративного ассистента или поиск по базе знаний и хотят, чтобы он находил нужный пункт регламента, а не соседний. Инструкция опирается на исследования Chroma, NVIDIA и Anthropic, документацию Microsoft и LangChain. Собственных замеров для статьи мы не проводили: цифры принадлежат авторам источников.
Содержание
- Кратко
- Что входит и не входит в инструкцию
- Почему от чанкинга зависит качество ответов
- Что понадобится до старта
- Пошаговая настройка чанкинга
- Особые типы документов
- Типовые ошибки
- Копируемый шаблон конфигурации и протокола теста
- Частые вопросы
- Первоисточники и метод
Кратко
- Режьте по структуре, а не по числу символов. Сначала заголовки и пункты, затем абзацы, затем предложения. Так работает рекурсивное разбиение, которое LangChain рекомендует для обычного текста.
- Начните с проверенной точки. Microsoft советует стартовать с 512 токенов и перекрытия 25%; в тестах NVIDIA лучше всего в среднем сработало разбиение по страницам, а для фактических вопросов — фрагменты по 256–512 токенов.
- Добавьте контекст к каждому фрагменту. Название документа, путь по разделам, дата и права доступа. Anthropic сообщает, что короткая контекстная справка перед фрагментом сократила долю неудачных поисков на 35%, а вместе с BM25 — на 49%.
- Проверяйте на своих вопросах. Нужен набор из нескольких десятков реальных вопросов с известным местом ответа и метрика «нашёлся ли нужный фрагмент в первых k результатах».
- Фиксируйте конфигурацию. Размер, перекрытие, разделители и версия парсера должны храниться вместе с индексом, чтобы переиндексация давала тот же результат.
Что входит и не входит в инструкцию
В инструкции: подготовка текста к разбиению, выбор стратегии, размера и перекрытия, метаданные и контекст фрагмента, работа с таблицами и договорами, проверка качества и типовые ошибки.
Вне инструкции: распознавание сканов и выбор парсера PDF (мы разбирали их в сравнении парсеров PDF для RAG), выбор векторной базы и модели эмбеддингов, реранкинг и генерация ответа. Общую архитектуру смотрите в материале «RAG-система для бизнеса».
Почему от чанкинга зависит качество ответов
RAG-система не читает документы целиком в момент вопроса. Она заранее режет их на фрагменты, превращает каждый в вектор (эмбеддинг) и при запросе подбирает несколько самых похожих фрагментов. Языковая модель отвечает только по тому, что нашлось. Если условие и исключение из него оказались в разных фрагментах, модель увидит одно без другого.
Отсюда два противоположных риска:
- Слишком крупный фрагмент смешивает несколько тем. Его вектор усредняет всё содержимое, поиск хуже отличает нужное, а в окно модели попадает лишний текст.
- Слишком мелкий фрагмент теряет контекст: строка «срок — 10 рабочих дней» без заголовка «Возврат товара надлежащего качества» бесполезна.
Влияние измеримо. В техническом отчёте Chroma «Evaluating Chunking Strategies for Retrieval» от 3 июля 2024 года выбор стратегии менял полноту поиска (recall) до 9%. В исследовании NVIDIA от 18 июня 2025 года крайние размеры — 128 и 2 048 токенов — в целом проигрывали средним. О том, как ошибки поиска превращаются в галлюцинации, мы писали в статье о точности RAG.
Что понадобится до старта
| Что подготовить | Зачем | Кто обычно отвечает |
|---|---|---|
| Выборка документов каждого типа (регламенты, договоры, инструкции, таблицы, FAQ) | Стратегия зависит от структуры документа | Владелец базы знаний |
| 30–50 реальных вопросов пользователей с указанием документа и раздела, где лежит ответ | Это эталон для сравнения вариантов | Эксперты подразделения |
| Парсер, который сохраняет заголовки, списки и таблицы (например, в Markdown) | Без структуры резать по смыслу нечем | Разработчик |
| Модель эмбеддингов и её токенизатор, максимальная длина входа | Размер фрагмента меряют в токенах этой модели | Разработчик |
| Векторное хранилище с поддержкой метаданных и фильтров | Для прав доступа, дат и версий | Разработчик или администратор |
| Скрипт оценки: поиск по каждому вопросу и проверка, попал ли нужный фрагмент в результаты | Чтобы сравнивать варианты цифрами, а не на глаз | Разработчик или аналитик |
Количество вопросов — ориентир, а не норма: важно, чтобы набор покрывал все типы документов и формулировки, которыми реально пользуются сотрудники.
Пошаговая настройка чанкинга
Шаг 1. Разделите документы по типам
Регламент с пронумерованными пунктами, договор, таблица прайса и база вопросов-ответов требуют разных правил. Составьте список типов и для каждого запишите естественную единицу смысла: пункт регламента, статья договора, строка таблицы, пара «вопрос — ответ».
Шаг 2. Переведите документы в текст со структурой
Перед разбиением документ должен стать текстом, где заголовки размечены как заголовки, списки — как списки, а таблицы сохранили строки и столбцы. Удобный формат — Markdown. Проверьте вручную 5–10 документов каждого типа: если парсер склеил колонки или потерял нумерацию пунктов, никакой чанкинг это не исправит.
Шаг 3. Выберите базовую стратегию
Для большинства корпоративных текстов начинайте со структурного рекурсивного разбиения. Сначала документ делится по заголовкам, затем раздел, который не помещается в лимит, — по абзацам, затем по предложениям. Так устроен RecursiveCharacterTextSplitter в LangChain: по умолчанию он пробует разделители "\n\n", "\n", пробел и пустую строку, чтобы как можно дольше держать вместе абзацы и предложения. В отчёте Chroma такой эвристический метод при правильных параметрах показал себя хорошо на фоне более сложных подходов.
| Стратегия | Как режет | Когда подходит | Цена |
|---|---|---|---|
| Фиксированный размер с перекрытием | Каждые N токенов | Однородный текст без структуры | Низкая |
| Рекурсивная по структуре | Заголовки → абзацы → предложения | Регламенты, инструкции, статьи | Низкая |
| По страницам | Одна страница — один фрагмент | Отчёты и презентации, где страница — смысловой блок | Низкая |
| Семантическая | По смене темы между предложениями, по эмбеддингам | Длинные тексты без заголовков | Средняя: нужны вызовы модели эмбеддингов |
| С помощью LLM | Модель сама решает, где граница | Сложные документы, малый корпус | Высокая и медленная |
В руководстве Microsoft к этому выбору добавлена экономика: у каждой стратегии есть стоимость разработки и стоимость обработки каждого документа, которые растут вместе с корпусом.
Шаг 4. Задайте размер и перекрытие в токенах
Размер считайте в токенах той модели эмбеддингов, которую используете, а не в символах: для русского текста соотношение символов и токенов отличается от английского и зависит от токенизатора. Подробнее — в статье о токенизации русского текста. Проверьте, что фрагмент вместе с контекстным заголовком не превышает максимальную длину входа модели, иначе конец будет обрезан.
Стартовые значения из первоисточников:
| Источник | Рекомендация или результат |
|---|---|
| Microsoft, Azure AI Search | Начать с 512 токенов и перекрытия 25%, то есть 128 токенов; для структурированных данных перекрытия может требоваться меньше |
| NVIDIA, 2025 | Разбиение по страницам дало лучшую среднюю точность 0,648 и наименьший разброс; фактические вопросы лучше работали с фрагментами 256–512 токенов, аналитические — с крупными; перекрытие 15% оказалось лучшим из 10, 15 и 20% на одном наборе |
| Chroma, 2024 | Настройка 800 токенов с перекрытием 400 дала чуть ниже средней полноты; рекурсивное разбиение по 400 токенов без перекрытия — 89,5% полноты против 85,4% у варианта 800/400 при пяти найденных фрагментах |
Практичный план: возьмите две-три конфигурации вокруг 512 токенов (например, 256, 512 и 1 024 с перекрытием около 15%) и сравните их на шаге 7. Перекрытие помогает, когда факт попадает на границу фрагментов, но большое перекрытие создаёт почти одинаковые фрагменты, которые занимают места в выдаче.
Шаг 5. Добавьте метаданные и контекст фрагмента
Каждый фрагмент храните вместе с полями: идентификатор и название документа, путь по разделам («Регламент возвратов → 3. Сроки → 3.2»), дата действия или версия, подразделение, уровень доступа, ссылка на оригинал. Метаданные нужны для фильтров (искать только в действующих версиях, только в документах, доступных этому сотруднику) и для ссылок в ответе.
Второй приём — контекстная справка внутри самого текста. Anthropic в публикации Contextual Retrieval от 19 сентября 2024 года описывает метод: языковая модель пишет для каждого фрагмента 50–100 токенов о его месте в документе, и этот текст добавляется перед фрагментом до построения эмбеддинга и индекса BM25. В их экспериментах доля неудачных поисков в первых 20 результатах снизилась с 5,7% до 3,7% только за счёт контекстных эмбеддингов, до 2,9% вместе с контекстным BM25 и до 1,9% при добавлении реранкинга. Стоимость генерации справок авторы оценили в 1,02 доллара за миллион токенов документов при своих допущениях и с кэшированием промпта.
Если бюджет на вызовы LLM ограничен, начните с бесплатного варианта: добавьте в начало фрагмента название документа и путь по разделам.
Шаг 6. Настройте исключения для особых типов
Таблицы, договоры, FAQ и код плохо переносят общее правило. Конкретные приёмы описаны в разделе «Особые типы документов» ниже. Задайте их как отдельные правила в конфигурации, а не как ручную правку отдельных файлов.
Шаг 7. Соберите тест и сравните варианты
Для каждой конфигурации постройте отдельный индекс и прогоните по нему все вопросы эталонного набора. Основная метрика — полнота поиска recall@k: в какой доле вопросов фрагмент с ответом оказался среди первых k найденных (k равно числу фрагментов, которые вы передаёте модели, например 5). Дополнительно посмотрите:
- сколько найденных фрагментов не относятся к вопросу — это шум в окне модели;
- сколько всего фрагментов и токенов в индексе — это стоимость хранения и эмбеддингов;
- качество итоговых ответов на 10–20 вопросах, оценённое экспертом.
Меняйте одну настройку за раз и держите неизменными модель эмбеддингов, число k и набор вопросов, иначе разницу не с чем будет связать.
Шаг 8. Разберите провалы вручную и зафиксируйте версию
По каждому вопросу, где нужный фрагмент не нашёлся, откройте результаты и определите причину: ответ разрезан между фрагментами, утонул в большом фрагменте, потерялся при парсинге или вопрос сформулирован словами, которых нет в документе. Последний случай чанкингом не лечится — помогают гибридный поиск и реранкер.
Выбранную конфигурацию сохраните в репозитории вместе с версией парсера и модели эмбеддингов. При изменении любой из них переиндексируйте корпус и повторите тест.
Особые типы документов
- Таблицы. Не режьте таблицу посередине без заголовка: повторяйте строку заголовков в каждом фрагменте или превращайте строку таблицы в отдельный фрагмент вида «Товар: …; Цена: …; Срок поставки: …».
- Договоры и регламенты. Единица — пункт или статья с номером. Номер и название раздела должны быть в тексте фрагмента, иначе вопрос «что сказано в пункте 5.3» не найдёт ответ.
- FAQ и базы вопросов-ответов. Одна пара «вопрос — ответ» — один фрагмент, без перекрытия с соседними.
- Длинные документы без заголовков (стенограммы, переписка). Здесь уместна семантическая нарезка или метод позднего разбиения (late chunking): длинный текст сначала целиком пропускают через модель эмбеддингов с длинным контекстом, а векторы фрагментов получают уже после этого, сохраняя в них контекст всего документа.
- Сканы и презентации. Если страница — законченный смысловой блок, начните с разбиения по страницам, как в тестах NVIDIA.
Типовые ошибки
- Резать сырой текст из PDF. Колонтитулы, номера страниц и склеенные колонки попадают во фрагменты и портят поиск.
- Считать размер в символах для модели, которая работает с токенами. Фрагмент может оказаться длиннее входа модели и обрезаться без предупреждения.
- Ставить большое перекрытие «для надёжности». Половинное перекрытие удваивает объём индекса и заполняет выдачу почти одинаковыми фрагментами.
- Терять заголовки. Фрагмент без названия документа и раздела не находится по вопросам с этими словами и не даёт корректной ссылки в ответе.
- Выбирать размер по чужому бенчмарку. В исследовании NVIDIA даже похожие финансовые документы лучше работали с разными настройками: 1 024 токена, 512 токенов или целые страницы.
- Проверять на трёх вопросах. Разница между вариантами видна только на наборе, который покрывает все типы документов.
- Не хранить конфигурацию. Через полгода никто не помнит, как был построен индекс, и переиндексация меняет качество.
Копируемый шаблон конфигурации и протокола теста
Конфигурация чанкинга (храните рядом с индексом):
chunking_config:
  version: "2026-10-22-v1"
  parser: "название и версия парсера"
  embedding_model: "название модели эмбеддингов"
  length_unit: "tokens"            # токены модели эмбеддингов
  default_strategy: "recursive_by_structure"
  separators: ["# ", "## ", "### ", "\n\n", "\n", ". "]
  chunk_size: 512
  chunk_overlap: 77                # около 15%
  context_header: "{doc_title} > {section_path}"
  metadata: [doc_id, doc_title, section_path, version_date, department, access_level, source_url]
  rules:
    tables: "строка таблицы + строка заголовков"
    contracts: "один пункт договора с номером"
    faq: "одна пара вопрос-ответ, без перекрытия"
    slides: "одна страница"
Протокол сравнения вариантов:
Набор вопросов: ___ шт., типы документов: ___
Модель эмбеддингов: ___      k (фрагментов в ответ): ___

| Вариант | Размер | Перекрытие | Фрагментов в индексе | recall@k | Шум в топ-k | Комментарий |
|---------|--------|------------|----------------------|----------|-------------|-------------|
| A       |        |            |                      |          |             |             |
| B       |        |            |                      |          |             |             |
| C       |        |            |                      |          |             |             |

Вопросы без нужного фрагмента в топ-k: ___ (причина по каждому)
Решение и дата: ___   Ответственный: ___
Частые вопросы
Какой размер чанка выбрать для RAG?
Начните с 512 токенов модели эмбеддингов и перекрытия 10–25% — это стартовая точка из рекомендаций Microsoft и тестов NVIDIA. Затем сравните 2–3 размера, например 256, 512 и 1 024, на своих вопросах. Для коротких фактических вопросов чаще выигрывают меньшие фрагменты, для аналитических — более крупные.
Нужно ли перекрытие между чанками?
Небольшое перекрытие полезно при разбиении фиксированными окнами: оно спасает факты, попавшие на границу. При структурном разбиении по пунктам и для FAQ оно часто не нужно. В отчёте Chroma рекурсивное разбиение по 400 токенов без перекрытия показало более высокую полноту, чем 800 токенов с перекрытием 400.
Чем семантический чанкинг лучше обычного?
Семантический чанкинг ищет границы по смене темы, поэтому полезен для длинных текстов без заголовков. Но он требует вызовов модели эмбеддингов при индексации и не всегда выигрывает: в отчёте Chroma простое рекурсивное разбиение с подобранными параметрами показало себя хорошо на фоне сложных методов. Для документов с заголовками начинайте со структурного разбиения.
Как понять, что чанкинг настроен плохо?
Признаки — ассистент отвечает по соседнему пункту, теряет исключения из правил, не может назвать источник или находит несколько почти одинаковых фрагментов. Проверка: возьмите вопросы, на которые ответ неверный, и посмотрите, какие фрагменты были найдены. Если нужный текст разрезан или не попал в результаты, проблема в чанкинге или поиске.
Первоисточники и метод
- Smith, Troynikov. Evaluating Chunking Strategies for Retrieval, Chroma Technical Report, 3 июля 2024 — сравнение стратегий, полнота и точность поиска.
- Steve Han. Finding the Best Chunking Strategy for Accurate AI Responses, NVIDIA Technical Blog, 18 июня 2025 — размеры от 128 до 2 048 токенов, разбиение по страницам, перекрытие.
- Anthropic. Introducing Contextual Retrieval, 19 сентября 2024 — контекстные эмбеддинги и BM25.
- Microsoft Learn. Chunk large documents for vector search solutions и RAG chunking phase — стартовые параметры и экономика чанкинга.
- LangChain. Recursive text splitter — разделители по умолчанию.
- Günther и соавторы. Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models, arXiv:2409.04701.
Мы проверили источники 22 октября 2026 года. Цифры получены авторами на их корпусах и моделях, в основном англоязычных; на русскоязычных документах компании их нужно перепроверять по протоколу из шага 7.
Как AIrassvet помогает настроить чанкинг корпоративной базы знаний
Настройка чанкинга — часть построения RAG-системы, и её результат зависит от документов конкретной компании. На сайте AIrassvet указаны направления, которые закрывают эту работу:
- RAG и корпоративные базы знаний: разбор типов документов, правила разбиения, метаданные и права доступа;
- подготовка данных: перевод регламентов, договоров и таблиц в текст со структурой и сбор эталонного набора вопросов;
- тестирование и запуск: сравнение конфигураций на ваших вопросах и фиксация выбранной версии индекса.
Первый шаг — выбрать один процесс, где сотрудники ищут ответы в документах, и зафиксировать текущий результат, источники данных, ограничения и критерий приёмки.
Итог: чанкинг настраивают по тесту, а не по чужой цифре
Хороший чанкинг сохраняет смысловые единицы документа: пункт регламента, статью договора, строку таблицы с заголовками. Начните со структурного рекурсивного разбиения около 512 токенов с небольшим перекрытием и добавьте к каждому фрагменту название документа и раздела.
Дальше решает тест: соберите 30–50 реальных вопросов, сравните две-три конфигурации по полноте поиска, разберите провалы и зафиксируйте версию. Так вы получите настройку, подобранную под свои документы, а не под чужой бенчмарк.