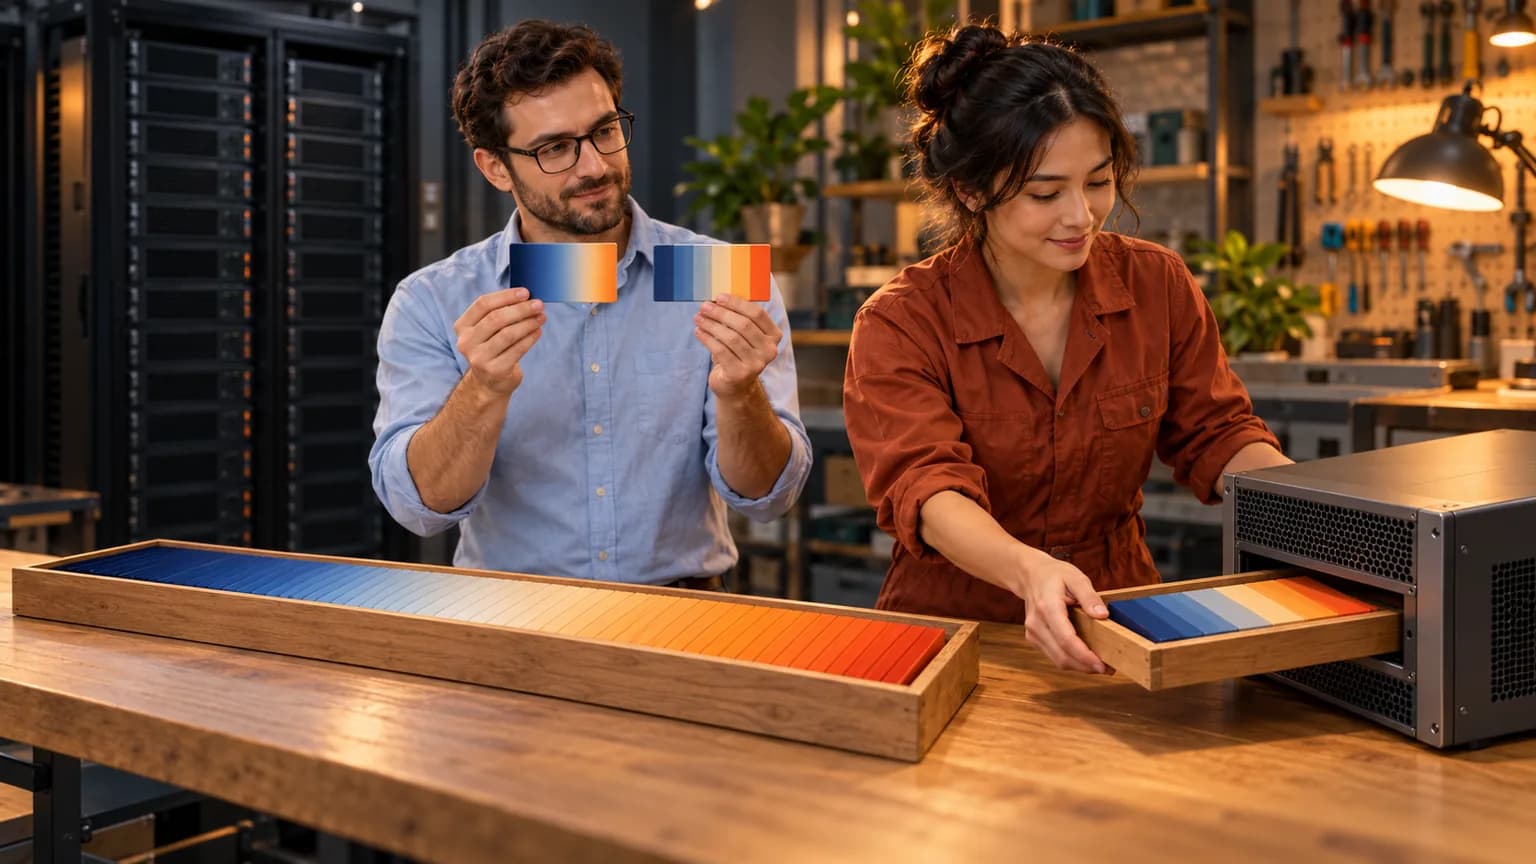
Квантизация LLM — это хранение весов языковой модели в числах меньшей точности, например в 8 или 4 битах вместо 16, чтобы модель занимала меньше видеопамяти и запускалась на более дешёвом железе. При переходе с 16 на 4 бита веса занимают примерно в 4 раза меньше места: модель на 8 млрд параметров — около 4 ГБ вместо 16 ГБ. Цена — возможная потеря качества, которая растёт при сильном сжатии и зависит от метода и задачи.
Материал подготовлен AIrassvet 21 октября 2026 года для руководителей и ИТ-директоров, которые планируют запускать открытые языковые модели на своих серверах и хотят понимать, от чего зависит стоимость железа. Объяснение опирается на научные статьи о методах LLM.int8(), GPTQ, AWQ, SmoothQuant, QLoRA и FP8, документацию llama.cpp и vLLM и карточки моделей Qwen и Gemma. Собственных замеров качества для статьи мы не проводили: все измерения принадлежат авторам источников, расчёты помечены.
Содержание
- Кратко
- Что входит и не входит в эту статью
- Что такое квантизация простыми словами
- Как устроена квантизация модели
- Сколько памяти экономит квантизация
- Основные методы и форматы
- Где квантизация применяется в бизнесе
- Ограничения и риски
- Как выбрать уровень квантизации
- Глоссарий
- Частые вопросы
- Первоисточники и метод
Кратко
- Квантизация уменьшает память под веса пропорционально числу бит: 16 → 8 бит — вдвое, 16 → 4 бита — примерно вчетверо.
- 8 бит обычно почти без потерь. Авторы LLM.int8() (2022) показали инференс моделей до 175 млрд параметров в 8 битах без ухудшения качества.
- 4 бита — рабочий компромисс. GPTQ (2022) сжимает веса до 3–4 бит с пренебрежимо малой, по оценке авторов, потерей точности.
- 2–3 бита — зона риска. Исследование квантизации LLaMA3 (2024) фиксирует заметную деградацию при сверхнизкой разрядности.
- Проверять нужно на своих задачах: средние бенчмарки не гарантируют качество на русскоязычных документах компании.
Что входит и не входит в эту статью
Мы объясняем квантизацию весов и кэша текстовых языковых моделей для инференса — то есть для работы уже обученной модели. Не разбираем квантизацию при обучении с нуля, прунинг и дистилляцию как отдельные методы сжатия, а также пошаговую настройку конкретных серверов. Подбор моделей и железа целиком описан в обзоре локальных LLM 2026, а сравнение затрат на облако и свои серверы — в статье «Облачная или локальная LLM: TCO».
Что такое квантизация простыми словами
Языковая модель — это миллиарды чисел-весов. Обычно каждое хранится в 16-битном формате (FP16 или BF16), то есть занимает 2 байта. Квантизация заменяет эти числа приближёнными значениями из небольшого набора уровней: 256 уровней в 8 битах или 16 уровней в 4 битах. Похоже на то, как фотографию сохраняют с меньшим числом цветов: картинка узнаваема, файл меньше, но мелкие оттенки теряются.
Модель при этом не переобучают с нуля. В большинстве методов квантизация выполняется после обучения (post-training quantization, PTQ): готовые веса пересчитывают за минуты или часы. Например, авторы GPTQ сообщают о квантизации модели на 175 млрд параметров примерно за 4 GPU-часа. Есть и вариант, при котором модель дообучают с учётом будущего округления, — quantization-aware training (QAT); его, например, Google использует для версий Gemma 4.
Как устроена квантизация модели
Простейший способ — найти для группы весов масштаб и округлить каждое значение до ближайшего уровня. На практике всё сложнее, потому что в больших языковых моделях есть выбросы: небольшое число очень больших значений, от которых сильно зависит качество. Поэтому методы различаются тем, как они защищают важные значения:
- LLM.int8() выносит признаки-выбросы в отдельное 16-битное умножение, а более 99,9% значений умножает в 8 битах (Dettmers и соавторы, 2022).
- GPTQ округляет веса последовательно и компенсирует ошибку соседними весами, используя приближённую информацию второго порядка (Frantar и соавторы, 2022).
- AWQ ищет важные каналы по активациям, а не по самим весам: по данным авторов, защита всего 1% значимых весов сильно снижает ошибку квантизации (Lin и соавторы, 2023).
- SmoothQuant переносит «сложность» квантизации с активаций на веса математически эквивалентным преобразованием и позволяет держать в 8 битах и веса, и активации (Xiao и соавторы, 2022).
Веса делят на небольшие группы со своим масштабом, поэтому реальная разрядность получается чуть выше номинальной. В таблицах llama.cpp формат Q4_K_M для Llama 3.1 8B — это 4,89 бита на вес, а Q8_0 — 8,50 бита.
Сколько памяти экономит квантизация
Память под веса считается просто: число параметров × бит на вес / 8 = байты. Расчёт ниже выполнен AIrassvet по этой формуле и не учитывает кэш контекста (KV-cache), активации и служебные расходы фреймворка — на практике к весам нужно добавлять запас.
| Модель | 16 бит (FP16/BF16) | 8 бит | 4 бита |
|---|---|---|---|
| 8 млрд параметров | 16 ГБ | 8 ГБ | 4 ГБ |
| 32 млрд параметров | 64 ГБ | 32 ГБ | 16 ГБ |
| 70 млрд параметров | 140 ГБ | 70 ГБ | 35 ГБ |
Реальные файлы немного больше из-за масштабов групп. Разработчики llama.cpp приводят для Llama 3.1 8B такие размеры: 14,96 ГиБ в F16 (около 16 ГБ), 7,95 ГиБ в Q8_0 и 4,58 ГиБ в Q4_K_M. Для Llama 3.1 70B — 280,9 ГБ исходного файла и 43,1 ГБ после Q4_K_M; судя по размеру — около 4 байт на параметр, — исходный файл в этой таблице 32-битный.
Квантизация может ускорить и генерацию текста: она упирается в скорость чтения весов из памяти, а меньшие веса читаются быстрее. В тех же таблицах llama.cpp Llama 3.1 8B генерирует 29,17 токена в секунду в F16, 50,93 — в Q8_0 и 71,93 — в Q4_K_M. Это замеры разработчиков llama.cpp на их оборудовании, а не гарантия для любого сервера.
Основные методы и форматы
| Метод или формат | Разрядность | Что квантуется | Где встречается |
|---|---|---|---|
| LLM.int8() | 8 бит | веса, выбросы в 16 битах | библиотека bitsandbytes |
| GPTQ | 3–4 бита | веса | готовые модели на Hugging Face, vLLM |
| AWQ | 4 бита | веса | Qwen3-8B-AWQ от команды Qwen, vLLM |
| SmoothQuant | 8 бит | веса и активации (W8A8) | серверный инференс |
| FP8 | 8 бит | веса, активации, KV-cache | Qwen3-8B-FP8, vLLM |
| GGUF (k-quants) | 2–8 бит | веса | llama.cpp, локальный запуск на CPU и GPU |
| NF4 (QLoRA) | 4 бита | веса при дообучении | дообучение на одной GPU |
| QAT | обычно 4 бита | веса, обучение с учётом округления | Gemma 4 QAT Q4_0 |
FP8 — 8-битный формат с плавающей точкой; Micikevicius и соавторы (2022) описали две его кодировки: E4M3 (4 бита порядка и 3 бита мантиссы) и E5M2 (5 и 2 бита). Документация vLLM описывает поддержку AWQ, GPTQ, GGUF, bitsandbytes и FP8, а также FP8-квантизацию кэша контекста. NF4 — 4-битный формат из работы QLoRA (Dettmers и соавторы, 2023): он позволил дообучать модель на 65 млрд параметров на одной GPU с 48 ГБ памяти.
Где квантизация применяется в бизнесе
- Своя модель на одном сервере. Квантизация переводит модель на 70 млрд параметров из класса «несколько GPU» в класс одной-двух карт, если хватает памяти под веса и кэш контекста.
- Дешевле инференс в облаке. Меньше памяти — можно арендовать менее дорогой GPU или обслуживать больше одновременных запросов на том же. Как устроен инференс открытых моделей в облаке, мы разбирали в статье об инференсе open-source LLM в российском облаке.
- Локальный запуск на рабочих станциях для пилотов и закрытых контуров, где данные нельзя отправлять наружу: форматы GGUF рассчитаны в том числе на CPU.
- Дообучение на ограниченном железе через QLoRA: веса базовой модели хранятся в 4 битах, обучаются только адаптеры.
- Длинный контекст. Квантизация кэша контекста уменьшает память, которую съедают длинные документы и много параллельных сессий.
Ограничения и риски
- Качество падает нелинейно. Исследование квантизации LLaMA3 (Huang и соавторы, 2024) оценило 10 методов на 1–8 битах и зафиксировало заметную деградацию, особенно при сверхнизкой разрядности.
- Средний бенчмарк скрывает слабые места. Потери могут распределяться неравномерно между задачами, а публикации о методах в основном измеряют качество на англоязычных наборах. Поэтому длинные рассуждения, код, русский язык и узкую терминологию нужно проверять на своих задачах.
- Не всё железо ускоряет все форматы. Выгода в скорости зависит от того, поддерживают ли GPU и фреймворк конкретный формат; иначе экономится память, но не время.
- Квантованная копия — не оригинал. Версии от сторонних авторов могут отличаться настройками и калибровочными данными; предпочтительны официальные версии разработчика модели, а лицензия наследуется от исходной модели.
- Экономия памяти не равна экономии бюджета. Итоговую стоимость определяют нагрузка, требования к задержке и эксплуатация, а не только объём видеопамяти.
Как выбрать уровень квантизации
Мы рекомендуем идти от задачи и проверочного набора, а не от минимального размера файла:
- Начните с 8 бит (FP8 или INT8), если память позволяет: по данным LLM.int8() и SmoothQuant, потери на этом уровне малы.
- Переходите на 4 бита (AWQ, GPTQ, GGUF Q4_K_M или QAT-версии), когда 8 бит не помещаются или нужна большая модель на том же железе. Большая модель в 4 битах может оказаться полезнее маленькой в 16 битах при том же объёме памяти, но это нужно подтвердить тестом.
- Не используйте 2–3 бита в продакшне без отдельной проверки качества на ваших задачах.
- Сравнивайте варианты на одном наборе реальных запросов: исходная модель, 8 бит и 4 бита. Как собрать такой набор, мы описали в статье «Свой бенчмарк для выбора LLM».
Мы выбираем порядок «сначала 8 бит, потом 4» потому, что он ограничивает риск: каждое следующее сжатие проверяется относительно уже работающего варианта, а не относительно ожиданий.
Глоссарий
- Вес (параметр) — число внутри модели, которое определяет её поведение; у моделей их миллиарды.
- FP16 / BF16 — 16-битные форматы с плавающей точкой, стандартные для хранения LLM.
- INT8 / INT4 — целочисленные форматы на 8 и 4 бита.
- FP8 — 8-битный формат с плавающей точкой.
- PTQ — квантизация после обучения, без переобучения модели.
- QAT — обучение с учётом квантизации, чтобы модель привыкла к округлению.
- Калибровочные данные — небольшой набор текстов, по которому метод оценивает распределение значений.
- KV-cache — кэш промежуточных значений внимания, который растёт с длиной контекста.
- GGUF — формат файлов моделей проекта llama.cpp.
- Перплексия — метрика того, насколько хорошо модель предсказывает текст; llama.cpp использует её и KL-дивергенцию для оценки потерь от квантизации.
Частые вопросы
Квантизация и сжатие модели — одно и то же?
Квантизация — один из способов сжатия, наряду с прунингом и дистилляцией. Она не убирает веса и не обучает новую модель, а хранит те же веса с меньшей точностью. Поэтому архитектура и возможности модели сохраняются, а меняется объём памяти, иногда скорость и, в разной степени, качество ответов.
Сколько видеопамяти нужно для модели на 70 млрд параметров?
Для весов в 4 битах — около 35 ГБ по формуле «параметры × бит / 8», в 8 битах — около 70 ГБ, в 16 битах — около 140 ГБ. К этому нужно добавить память под кэш контекста и служебные расходы, которые зависят от длины запросов и числа одновременных пользователей. Поэтому окончательный объём определяют нагрузочным тестом.
Можно ли квантовать модель самостоятельно?
Да, для популярных форматов есть открытые инструменты: llama.cpp для GGUF, библиотеки для AWQ и GPTQ, LLM Compressor для форматов vLLM. Но для многих моделей разработчики уже публикуют официальные квантованные версии, например Qwen3-8B-AWQ и Qwen3-8B-FP8 или QAT-версии Gemma 4. Начинать разумно с них, а собственную квантизацию проверять на калибровочных данных, близких к вашим задачам.
Ухудшится ли работа модели на русском языке?
Может, и это нужно проверять отдельно. Публикации о методах квантизации в основном оценивают качество на англоязычных бенчмарках, поэтому их выводы не гарантируют такого же результата на русскоязычных документах и терминологии компании. Сравните исходную и квантованную модель на наборе реальных запросов на русском до запуска.
Первоисточники и метод
- Dettmers и соавторы. LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale, 2022.
- Frantar и соавторы. GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, 2022.
- Lin и соавторы. AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, 2023.
- Xiao и соавторы. SmoothQuant, 2022.
- Dettmers и соавторы. QLoRA: Efficient Finetuning of Quantized LLMs, 2023.
- Micikevicius и соавторы. FP8 Formats for Deep Learning, 2022.
- Huang и соавторы. An empirical study of LLaMA3 quantization, 2024.
- llama.cpp: документация llama-quantize — размеры и скорость форматов для Llama 3.1.
- vLLM: квантизация и квантизация KV-cache.
- Карточки Qwen3-8B-AWQ, Qwen3-8B-FP8 и Gemma 4 12B QAT Q4_0.
Мы проверили источники 21 октября 2026 года. Цифры о качестве и скорости принадлежат авторам и получены в их условиях; таблица памяти — расчёт по формуле без учёта кэша контекста.
Как AIrassvet помогает запустить квантованную модель на своих серверах
Квантизация — это решение о компромиссе между железом и качеством, и его стоит принимать по измерениям. На сайте AIrassvet указаны направления, которые закрывают эту задачу:
- внедрение LLM, в том числе развёртывание модели на серверах заказчика: подбор модели и уровня квантизации под имеющееся железо;
- аудит процесса и подготовка данных: сбор набора реальных запросов, на котором сравнивают исходную и квантованную версии;
- тестирование и запуск: проверка качества и нагрузки перед переводом квантованной модели в работу.
Первый шаг — выбрать один процесс, для которого нужна своя модель, и зафиксировать текущий результат, источники данных, ограничения по железу и критерий приёмки.
Итог: квантизация экономит память, качество проверяют тестом
Квантизация LLM — основной способ уместить большую модель в доступную видеопамять: 8 бит вдвое сокращают память под веса, 4 бита — примерно вчетверо. Методы вроде GPTQ, AWQ и QAT держат потери на 4 битах небольшими, но при более сильном сжатии качество падает заметно.
Поэтому выбирайте уровень квантизации от задачи: начните с 8 бит, переходите на 4 бита при нехватке памяти и сравнивайте варианты на своих запросах. Тогда экономия на железе не превратится в незаметную потерю качества ответов.