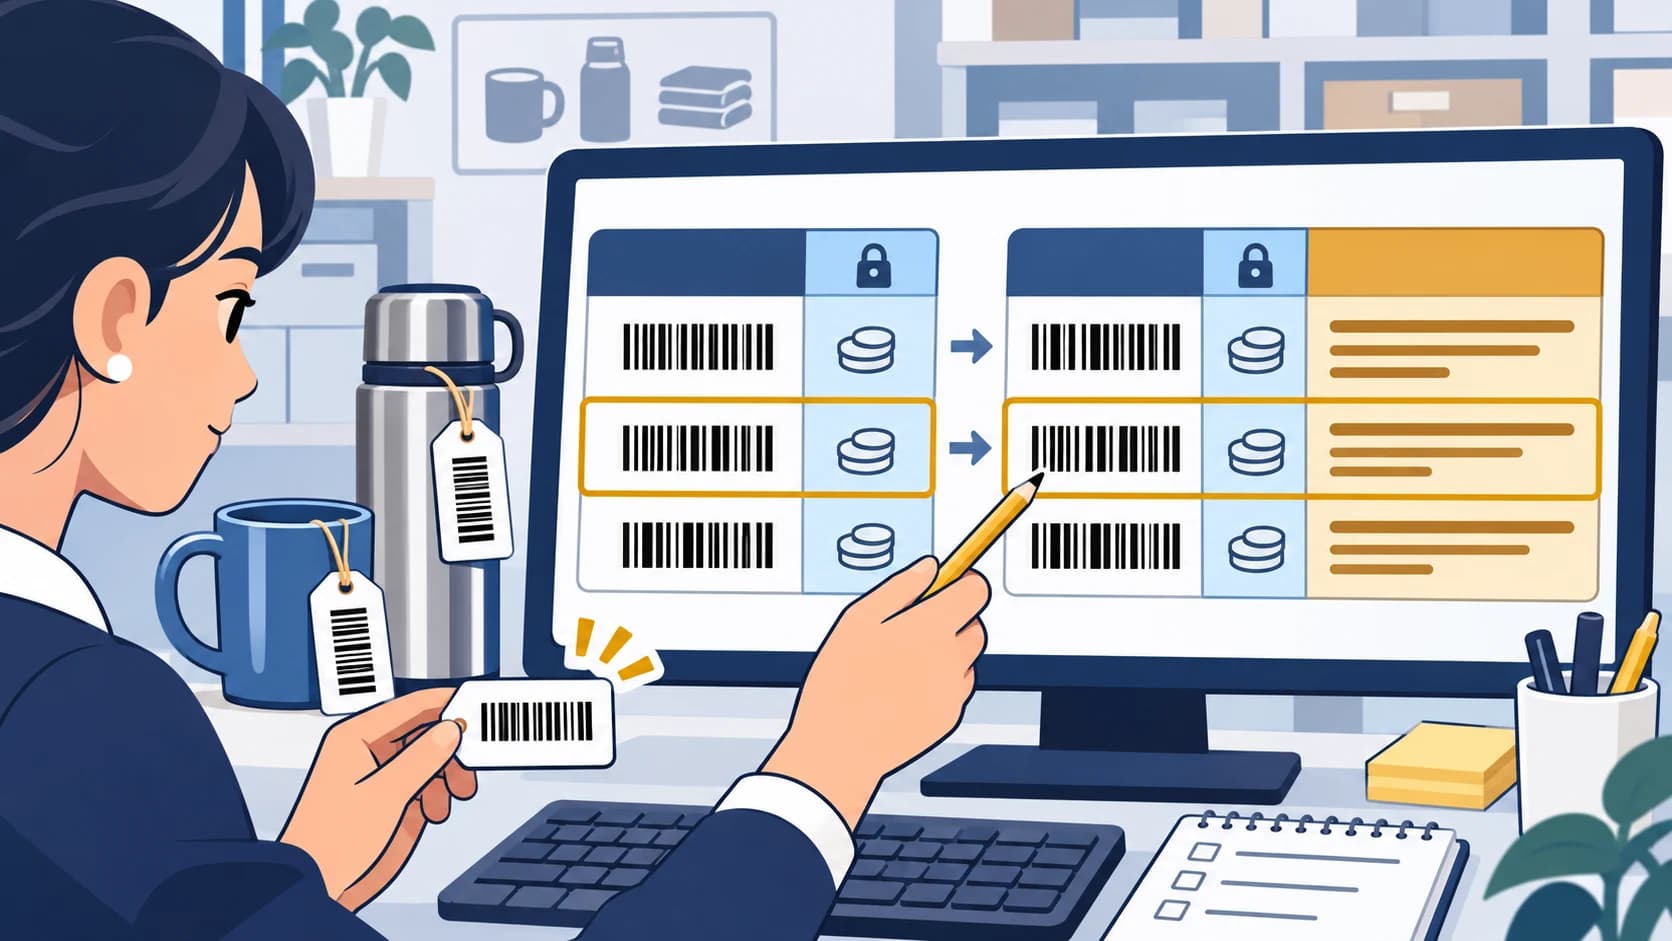
Если после обработки прайс-листа с ИИ артикул 00123 превратился в 123, сначала сравните исходный файл, данные на входе модели и итоговую выгрузку. Изменение могло произойти при открытии в Excel, чтении CSV или сборке ответа. Сохраните идентификаторы строками, задайте формат цены явно и передавайте эти поля в результат напрямую из источника. Модели поручите только ту часть работы, где нужен текст или смысл.
Разбор предназначен для специалиста по товарному каталогу и разработчика ИИ-автоматизации. Он помогает подготовить CSV одного поставщика и найти ошибки передачи данных. Сопоставление разных товаров и выбор соответствия каталогу 1С — отдельная задача; ей посвящён материал о сопоставлении номенклатуры с ИИ.
Документация проверена 2 ноября 2026 года. Приведённый Python-скрипт запускался локально на учебных файлах; результаты и границы проверки описаны ниже. Excel и ИИ-сервис при подготовке статьи не запускались. Учебные названия и цены не взяты из клиентского прайса.
Содержание:
- Где именно изменились данные
- Как импортировать артикулы в Excel без потери нулей
- Как задать понятный формат прайса для ИИ-конвейера
- Как преобразовать CSV в JSON с явными проверками
- Что делать, если проверка остановилась
- Как передать модели только нужную работу
Где именно изменились данные
CSV — текстовый файл с записями и полями, разделёнными выбранным символом. Само расширение не задаёт вашей программе бизнес-типы колонок. Один и тот же набор цифр может означать цену или идентификатор. Разделитель, кавычки и правила чтения нужно согласовать явно; различия между CSV разных приложений описаны в документации Python.
Сделайте копию исходной выгрузки и откройте её в текстовом редакторе без сохранения изменений. Найдите проблемный SKU — артикул, которым система обозначает товар. Затем посмотрите это же поле после импорта в вашу автоматизацию и после получения ответа модели. Сравнивайте сами значения, а не только отображение ячеек.
| Симптом | Что сравнить | Следующее действие |
|---|---|---|
В исходном тексте 00123, после импорта 123 |
Тип колонки в импортёре | Читать SKU как строку и заново импортировать оригинал |
В исходном файле уже 123, хотя нужен 00123 |
Выгрузку из учётной системы и более раннюю копию | Получить корректный источник; длину кода не угадывать |
Вместо длинного ID появилась запись с E |
Исходное значение и значение в строке формул | Проверить, изменилось только отображение или сами цифры |
| Название разъехалось на две колонки | Разделитель и кавычки в записи | Использовать CSV-парсер с нужным диалектом |
| На входе модели код верный, в ответе изменён | Тело запроса и правило сборки результата | Убрать переписывание кода моделью |
Не дополняйте все коды нулями до одинаковой длины без правила поставщика. 00123 и 123 могут быть двумя разными товарами. Если оригинал утрачен, корректный результат этого этапа — список неразрешённых строк для владельца каталога, а не автоматически «исправленный» прайс.
Как импортировать артикулы в Excel без потери нулей
Microsoft предупреждает, что Excel может удалять начальные нули, преобразовывать длинные числа и ограничивать их числовую точность 15 значащими цифрами. Для идентификаторов компания рекомендует текстовое представление. Настройки автоматических преобразований доступны в Microsoft 365 и Excel 2024; наличие их в более старой версии предполагать нельзя. Источник: Microsoft Support.
Документированный маршрут через Power Query:
- Выберите «Данные» → «Из текста/CSV» и укажите исходный файл.
- Откройте преобразование данных в редакторе запросов. Названия кнопок зависят от версии и языка интерфейса.
- Проверьте шаги запроса: преобразование SKU в число не должно выполняться до назначения текстового типа. Удалите или исправьте автоматический шаг изменения типа, если он уже числовой.
- Задайте колонке артикула тип «Текст» и загрузите данные.
- Найдите известные
00123и длинный ID. Сверьте их с исходным текстом до следующего экспорта.
Базовый порядок импорта и назначения типа подтверждён инструкцией Microsoft; проверка последовательности шагов нужна, чтобы работать с исходными значениями. Этот интерфейсный маршрут здесь не проверялся в установленном Excel.
Пользовательский формат вида 00000 решает задачу отображения. Для обмена с ИИ-конвейером нужен сохранённый идентификатор, поэтому контролируйте экспортированный файл отдельно. Изменение формата уже повреждённой ячейки не даёт основания считать потерянные цифры восстановленными.
Как задать понятный формат прайса для ИИ-конвейера
Для учебного примера договоримся о трёх полях: sku, name, price_rub. Вход — UTF-8, допустим UTF-8 с BOM; разделитель — точка с запятой. BOM — служебная метка в начале файла: Python-кодек utf-8-sig пропускает её при чтении, если она присутствует. Он не распознаёт произвольную кодировку автоматически. Источник: документация codecs.
| Поле | Правило примера | Почему оно нужно |
|---|---|---|
sku |
Непустая строка, без пробелов по краям, уникальная в файле | Не потерять нули и не соединить ответ с другим товаром |
name |
Непустой текст | Дать модели исходное название |
price_rub |
Неотрицательная цена в рублях: цифры, запятая, две цифры | Исключить догадки о валюте и дробной части |
Это выбранный контракт примера, а не универсальный стандарт прайсов. Он намеренно отклоняет 1 299,90, 1299.90, по запросу, отрицательные значения и пустую цену. Если такие значения нужны бизнесу, сначала определите их смысл, затем измените проверку. Пустая цена и нулевая цена должны оставаться разными состояниями.
Сохраните следующий текст как price.csv в отдельной рабочей папке:
sku;name;price_rub
00123;Кружка синяя;1299,90
123;"Кружка; дорожная";0,00
000123456789012345;Термос стальной;2500,50
Во второй записи точка с запятой входит в название, поэтому поле заключено в кавычки. Не разбивайте строки через split(';'): такой способ примет часть названия за новую колонку. Не исправляйте проблему глобальной заменой разделителей — они могут быть частью самого текста.
Как преобразовать CSV в JSON с явными проверками
Скрипт ниже читает согласованный формат, проверяет записи и создаёт JSON — текстовое представление структурированных данных. SKU остаётся строкой. Цена тоже записывается строкой, но с точкой: так выбранный контракт сохраняет две десятичные позиции без промежуточного float. Для расчётов приложению понадобится отдельно преобразовать её в согласованный денежный тип. Python Decimal создаётся непосредственно из строки; документация объясняет отличие от создания десятичного числа из уже округлённого двоичного float. Источник: decimal.
Нужен установленный Python 3; сторонние пакеты не требуются. Сохраните код как prepare_price.py рядом с учебным CSV. Запускать его следует на копии файла, без клиентских данных и без подключения к учётной системе.
import csv
import json
import re
import sys
from decimal import Decimal

source, target = sys.argv[1:3]
records = []
seen = set()

with open(source, encoding="utf-8-sig", newline="") as f:
    reader = csv.DictReader(f, delimiter=";", strict=True)
    if reader.fieldnames != ["sku", "name", "price_rub"]:
        raise ValueError("Нужны колонки sku;name;price_rub в этом порядке")
    for number, row in enumerate(reader, start=1):
        if None in row or any(value is None for value in row.values()):
            raise ValueError(f"Запись {number}: неверное число полей")
        sku, name, price = row["sku"], row["name"], row["price_rub"]
        if not sku or sku != sku.strip() or not name.strip():
            raise ValueError(f"Запись {number}: пустое поле или пробелы вокруг SKU")
        if sku in seen:
            raise ValueError(f"Запись {number}: повтор SKU {sku!r}")
        if not re.fullmatch(r"[0-9]+,[0-9]{2}", price):
            raise ValueError(f"Запись {number}: цена должна иметь вид 1299,90")
        seen.add(sku)
        records.append({
            "sku": sku,
            "name": name,
            "price_rub": format(Decimal(price.replace(",", ".")), "f"),
        })

if not records:
    raise ValueError("Прайс пуст")

# Режим x запрещает перезапись существующего результата.
with open(target, "x", encoding="utf-8") as f:
    json.dump(records, f, ensure_ascii=False, indent=2)
print(f"Готово: {len(records)} записей")
Чтение через DictReader и открытие с newline="" следуют документации csv. Полное соответствие цены шаблону проверяется функцией re.fullmatch. Заголовки должны совпадать с образцом, включая порядок и регистр. Повторяющиеся SKU здесь считаются ошибкой: несколько предложений одного товара с разными складами требуют другого ключа и другой схемы.
Запустите из рабочей папки:
python3 prepare_price.py price.csv price.jsonНа Windows команда может называться py вместо python3. При успешном выполнении учебного примера программа выводит Готово: 3 записей и создаёт price.json. Результат первой записи:
{
  "sku": "00123",
  "name": "Кружка синяя",
  "price_rub": "1299.90"
}
Весь файл содержит массив трёх объектов. ensure_ascii=False оставляет русские буквы читаемыми; правила сериализации описаны в документации json. Откройте результат текстовым редактором: первая и вторая записи должны иметь разные SKU, а длинный код — сохранить все символы.
Что делать, если проверка остановилась
При неверном заголовке, количестве полей, повторном SKU или неподходящей цене скрипт завершится с ошибкой. Если выходного файла раньше не было, до успешной проверки всех записей он не создаётся. Существующий price.json программа не перезаписывает: для нового запуска задайте другое имя и явно укажите downstream-процессу нужный результат. После неуспешного запуска нельзя считать старый файл свежей выгрузкой.
| Сообщение или ситуация | Причина | Исправление |
|---|---|---|
| Нужны колонки в указанном порядке | Другой шаблон или разделитель | Сверить заголовок и настройки экспорта |
| Неверное число полей | Лишняя колонка или недостающее значение | Исправить запись в источнике и экспортировать заново |
| Повтор SKU | Повторная строка либо ключ недостаточно точный | Уточнить правило уникальности, не удалять строку вслепую |
Цена должна иметь вид 1299,90 |
Формат не соответствует контракту | Уточнить валюту, точность и допустимые состояния |
UnicodeDecodeError |
Файл не удалось прочитать как UTF-8 | Узнать кодировку у источника и выполнить явное преобразование |
Проверка при подготовке статьи ограничена локальным Python-запуском: учебный файл преобразован; отдельно проверены сохранение нулей, длинного кода, кавычек и разделителя внутри названия. Повтор SKU, неправильная цена, лишнее и недостающее поле, неверный заголовок и пустой прайс вызывали остановку. Проверено и отсутствие перезаписи существующего результата. Это не тест качества нейросети, производительности на большом прайсе или импорта в Excel.
Строгий парсер не обнаружит все содержательные ошибки. Формально корректная цена может относиться к упаковке вместо штуки; артикул может принадлежать другому поставщику. При объединении нескольких прайсов добавьте контекст поставщика и согласуйте составной ключ. Не применяйте правила этого короткого примера к XLSX, PDF или произвольному CSV без адаптации.
Как передать модели только нужную работу
После подготовки данных задайте границу генерации. Например, приложению нужен черновик описания по названию и утверждённым характеристикам. Сохраните SKU и цену в программе, отправьте модели разрешённые текстовые поля, затем присоедините её ответ к исходной записи. В последовательном цикле соответствие хранит сама программа; для параллельных запросов нужен собственный идентификатор задания, который не извлекается из сгенерированного текста.
Не просите нейросеть восстановить SKU по названию или заново перепечатать весь прайс ради одной новой колонки. Даже синтаксически правильный JSON требует проверки соответствия исходным данным. Названия товаров считайте входными данными, а не командами: текст поставщика не должен менять правила приложения или давать модели право записывать цены в рабочую систему.
Для маршрута без программирования есть отдельная инструкция по описаниям товаров из CSV в Dify. Здесь результатом работы служит подготовленный файл с сохранёнными полями; вызов модели и обратная загрузка в каталог остаются следующими, отдельно проверяемыми этапами.
Как AI студия Владимира Ломтева помогает наладить передачу прайсов
В этой задаче подготовка данных связана с генерацией контента и интеграцией бизнес-систем. AI студия Владимира Ломтева может помочь согласовать схему товарных полей, собрать передачу данных между источником и ИИ-процессом, настроить тестирование сохранности идентификаторов и цен. Эти действия относятся к подготовке данных, генеративным процессам, интеграции и тестированию.
Первый шаг — выбрать один прайс, его источник и владельца, описать допустимые изменения и критерий результата: какие поля должны сохраняться посимвольно, а какие разрешено генерировать. Обсудить задачу.
С чего начать исправление
Возьмите одну повреждённую запись и найдите первое расхождение с источником. Если исходные цифры уже потеряны, получите новую выгрузку. Если повреждение возникает при чтении, задайте строковый тип SKU и явные правила цены. После локального преобразования сравните результат с оригиналом и только затем подключайте генерацию текстов. Рабочая граница проста: приложение сохраняет идентификаторы и денежные поля, модель выполняет согласованную текстовую задачу.