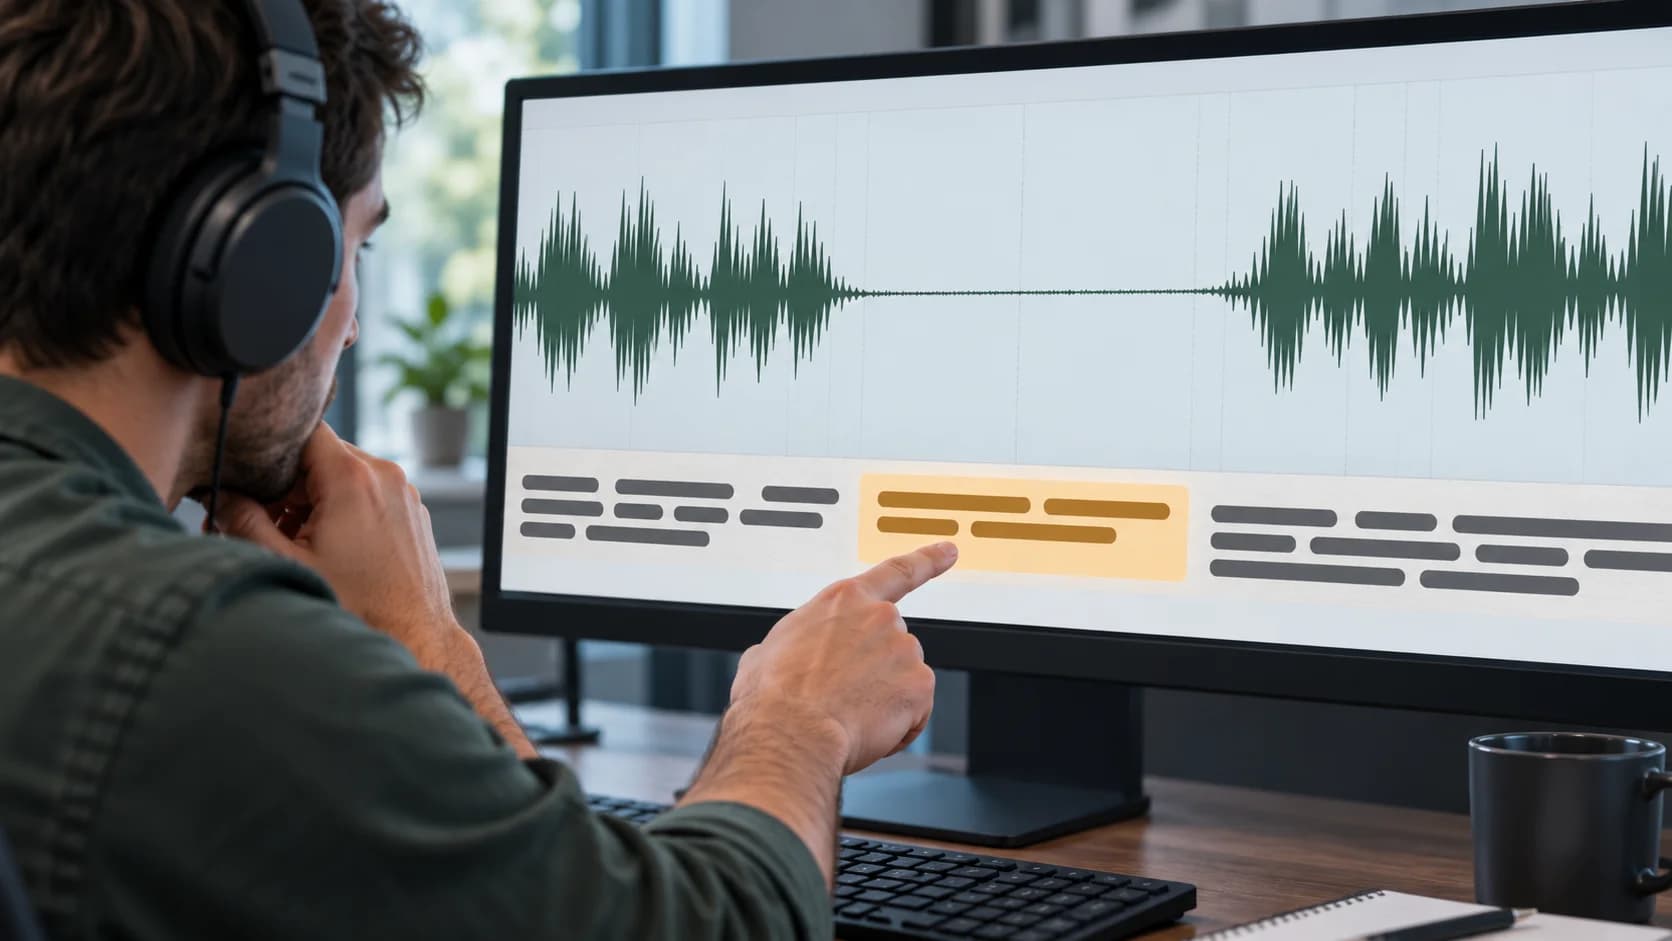
Если faster-whisper добавляет фразы в паузах или зацикливает одну реплику, сначала прослушайте соответствующий участок исходного аудио. Затем отдельно проверьте фильтрацию участков без речи и использование предыдущего текста как контекста. Не удаляйте все повторяющиеся строки автоматически: в звонке действительно могут несколько раз прозвучать «да» или название компании.
Разбор предназначен для команды, которая транскрибирует записи встреч, интервью или клиентских разговоров через библиотеку SYSTRAN faster-whisper. Здесь описаны документированные механизмы и предлагаемый порядок диагностики. Распознавание аудио редакцией не запускалось, приведённые настройки не являются проверенным рецептом для вашего потока. Источники сверены 31 октября 2026 года.
Содержание: Как отличить выдуманную фразу от дубля в интеграции · Причина 1. Участки без речи попадают в распознавание · Причина 2. Ошибка переносится через предыдущий текст · Как выбрать исправление на своих записях
Как отличить выдуманную фразу от дубля в интеграции
Сопоставьте текст, начало и конец подозрительного сегмента с исходной записью. Если на этом интервале нет речи, а распознанное предложение есть, это признак ошибки распознавания. Если одна и та же строка с теми же отметками времени появилась в базе дважды, проверьте повторную запись результата приложением.
| Наблюдение | Что проверить первым | Почему |
|---|---|---|
| Фраза стоит на музыке или длинной паузе | Границы речи и VAD | В распознавание мог попасть участок без речи |
| Одна фраза тянется через несколько окон | Контекст предыдущего текста | Ошибка могла переноситься в следующее окно |
| Совпадают текст и обе отметки времени | Сохранение результата и повторный запуск задачи | Возможен дубль записи, а не новая гипотеза модели |
| После фильтра исчезли тихие слова | Параметры VAD и исходную громкость | Полезная речь могла быть исключена |
Это направления диагностики, не доказательство конкретной причины. Сохраните аудио, исходный результат и настройки до изменений. Иначе будет трудно понять, исчезла ошибка или вместе с ней исчезла часть разговора.
Почему распознавание может продолжить фразу без речи
Распознаватель строит текстовую гипотезу по аудио и контексту. Наличие слов в результате само по себе не доказывает, что они произнесены. Документация faster-whisper предусматривает VAD, параметры обнаружения отсутствия речи и средства работы с повторяющимся контекстом. Это отдельные механизмы, которые не стоит сводить к одному переключателю «убрать галлюцинации». README проекта.
Для делового протокола последствие конкретно: выдуманная фраза может превратиться в ложное поручение. Поэтому при сомнении нужно возвращаться к фрагменту аудио, а не просить другую языковую модель красиво отредактировать транскрипт. Она не получает недостающего акустического доказательства из одного текста.
Причина 1. Участки без речи попадают в распознавание
VAD — детектор речевой активности. В faster-whisper он использует Silero VAD, чтобы исключать части аудио без речи. В README показан параметр vad_filter=True; при пакетной обработке через BatchedInferencePipeline фильтр включён по умолчанию. Не переносите это утверждение на каждый способ вызова: обычный и пакетный пути нужно проверять отдельно. Описание интеграции VAD.
Для диагностики обычного WhisperModel.transcribe можно явно включить фильтр. Минимальный пример предполагает, что совместимая библиотека и выбранная модель уже установлены, а файл meeting.wav существует:
from faster_whisper import WhisperModel

model = WhisperModel("small", device="cpu", compute_type="int8")
segments, info = model.transcribe(
    "meeting.wav",
    language="ru",
    vad_filter=True,
)
for segment in segments:
    print(segment.start, segment.end, segment.text)
Это адаптированный пример по документации, не выполненный запуск. Он не обещает достаточного качества модели small для деловых записей. Перебор segments важен: результат возвращается как генератор, и README отдельно поясняет, что транскрибация выполняется при его итерации. Один вызов без чтения результата нельзя считать завершённым распознаванием.
Сравните подозрительный интервал до и после изменения. Затем прослушайте начало и конец соседних реплик: фильтр должен убрать неречевой участок, сохранив тихую речь. Если исчезло слово, не принимайте сокращение транскрипта за улучшение качества.
Причина 2. Ошибка переносится через предыдущий текст
Параметр condition_on_previous_text определяет, передаётся ли предыдущий вывод модели как подсказка для следующего окна. В описании обычного метода WhisperModel.transcribe указано: отключение может уменьшить склонность к циклу ошибок, но ухудшить согласованность текста между окнами. Исходный код и описание аргументов.
Если проблема похожа на зацикливание, повторите распознавание того же фрагмента с condition_on_previous_text=False, сохранив остальные условия. Это отдельная диагностическая проба, а не безусловная настройка для всех встреч. Проверьте, прекратился ли повтор и не стали ли по-разному записываться имена или термины в соседних окнах.
Не меняйте одновременно модель, фильтр, контекст и подготовку аудио. Тогда исчезновение ошибки ничего не скажет о причине. Для первого сравнения достаточно сохранить тот же файл и ту же модель и изменить один параметр.
Причина 3. Параметр отсутствия речи понимают как универсальный фильтр
no_speech_threshold и VAD работают на разных этапах. В описании обычного метода условие пропуска учитывает вероятность отсутствия речи вместе со средней логарифмической вероятностью текста и log_prob_threshold. Поэтому произвольное изменение одного числа не означает «теперь всё тихое будет удалено». Описание параметров transcribe.
Не начинайте исправление с случайного набора порогов из чужого примера. Сначала зафиксируйте, какие значения реально использует ваш вызов, и проверьте аудио. Для выбора новых значений нужны ваши записи с речью, тихими словами, паузами и фоновыми звуками. Порог для чистой лекции нельзя считать подходящим для телефонного разговора без отдельной проверки.
Причина 4. VAD настроен слишком агрессивно
В определении VadOptions threshold относится к вероятности речи, min_speech_duration_ms — к минимальной длительности речевого фрагмента, а speech_pad_ms — к добавлению контекста у его границ. Единицы различаются: вероятность не измеряется в миллисекундах.
Если после изменения VAD пропадают короткие ответы, проверьте минимальную длительность речи и границы сегментов. Если отрезаются начала или окончания, рассмотрите запас по краям. Значения подбирают на размеченных примерах, а не по желанию получить как можно меньше текста. Фоновый телевизор или музыка с голосом также требуют прослушивания: наличие речеподобного звука не означает, что это участник встречи.
Почему отдельный параметр галлюцинаций не решает всё
В обычном WhisperModel.transcribe есть hallucination_silence_threshold. Его описание связывает пропуск длинных тихих промежутков при возможной галлюцинации с включённым word_timestamps. Это условная эвристика, а не гарантия достоверности каждой строки. Перед применением сверьте сигнатуру установленной версии и выбранный путь обработки. Реализация и документация метода.
Не добавляйте параметр только потому, что его название соответствует симптому. Если проблема возникла из-за повторного сохранения сегментов или неверного входного файла, такая настройка не устраняет причину. Если нужно сравнить обычный и пакетный запуск, фиксируйте их как разные режимы.
Как выбрать исправление на своих записях
Соберите небольшой набор фрагментов из разрешённых к обработке записей: с настоящей речью, длинной паузой, коротким тихим ответом, музыкой и повторяющейся фразой. Рядом запишите, что действительно слышно. Это предлагаемый набор для диагностики, а не проведённый редакцией эксперимент.
Начните с исходного варианта. Затем проверьте VAD. Если остаётся циклический повтор, отдельно сравните использование предыдущего текста. Для каждого варианта ответьте на два вопроса: появились ли слова без акустического основания и пропала ли настоящая речь? Улучшение только первого показателя при потере второго непригодно для протокола.
| Результат сравнения | Следующее действие |
|---|---|
| Выдуманная строка исчезла, речь сохранена | Проверить настройку на остальных выбранных фрагментах |
| Исчезли и ложная строка, и тихий ответ | Вернуть более мягкую обработку и проверить границы |
| Изменений нет, сегменты в базе дублируются | Разбирать сохранение и повторный запуск задания |
| Повтор исчез, но термины стали нестабильны | Оценить компромисс контекста; спорные места отправить на прослушивание |
Если нужен выбор распознавателя, а не исправление конкретного симптома, начните с отдельного материала о локальной транскрибации встреч. Изменение настроек одного движка не является сравнением качества разных моделей.
Как AI студия Владимира Ломтева помогает с транскрибацией
AI студия Владимира Ломтева может помочь встроить обработку аудио в корпоративный процесс:
- подготовить записи и набор характерных речевых ситуаций для проверки;
- спроектировать интеграцию распознавания с хранением аудио и связью сегментов с оригиналом;
- организовать проверку спорных реплик перед созданием задач и протоколов.
Первый шаг — выбрать один тип записи и показать разрешённый к обработке фрагмент с конкретным неверным результатом. Обсудить задачу.
Итог: исправляйте источник ошибки, сохраняя настоящую речь
Сначала отличите ошибку распознавания от дубля интеграции. Затем проверьте VAD, перенос предыдущего текста и только после этого — специальные пороги выбранного метода. Принимайте изменение по аудио: ложные реплики должны исчезнуть, реальные слова — сохраниться. До такой проверки спорный текст нельзя считать основанием для делового поручения.