Дообучение языковой модели — продолжение обучения готовой LLM на дополнительных данных. Выбор схемы состоит из двух разных решений: чему учить модель и какие параметры менять. SFT, DPO и продолжение предобучения задают учебную задачу; полное дообучение, LoRA и QLoRA описывают способ обновления и хранения параметров. Поэтому противопоставлять «SFT или LoRA» некорректно: SFT можно выполнить через LoRA.
Материал подготовила AI студия Владимира Ломтева 11 ноября 2026 года для технических руководителей, разработчиков и владельцев LLM-продуктов. Здесь разобраны методы адаптации текстовых языковых моделей, устройство обучающих данных, параметры эксперимента и выпуск результата. У моделей изображений, речи и компьютерного зрения есть свои схемы дообучения; переносить на них все настройки этого материала нельзя.
Это технический разбор по официальной документации Transformers, PEFT и TRL и оригинальным работам LoRA и QLoRA. Собственного обучения, сравнения качества и замеров GPU-памяти мы не проводили. Примеры данных ниже учебные; они показывают структуру, а не готовый датасет или подтверждённый результат обучения. Вопросы бюджета, договора и облачных предложений отдельно собраны в FAQ о дообучении на данных компании.
Содержание
- Что называют fine-tuning и чем он отличается от предобучения
- Сначала выберите цель обучения, затем способ изменения весов
- Как работает полное дообучение модели
- Как устроена LoRA: матрицы, ранг и масштаб
- Какие слои обучать и почему больший ранг не гарантирует успех
- Что добавляет QLoRA и почему обучение не становится полностью четырёхбитным
- Чем SFT отличается от продолжения предобучения и DPO
- Как выглядят данные для SFT и обучения на предпочтениях
- Почему токенизатор, chat template и маска loss так важны
- Как подготовить данные и разделить выборки
- Какие параметры управляют экспериментом
- Почему падающий training loss ещё не доказывает улучшение
- Что сохраняется после LoRA и как выпустить результат
- Какие ещё методы стоит знать: DoRA, prompt tuning и дистилляция
- Как выбрать схему для своей задачи
- Частые вопросы о fine-tuning и адаптерах
Что называют fine-tuning и чем он отличается от предобучения
Модель во время обучения получает последовательности токенов, формирует предсказания и изменяет обучаемые параметры так, чтобы уменьшить функцию ошибки — loss. Fine-tuning обычно начинают с уже обученных весов: модель не осваивает язык с нуля, а адаптируется к дополнительным данным и цели. Обучение в Transformers.
Под одним словом «дообучение» часто скрываются разные задачи:
- Продолжение предобучения на текстах предметной области: модель продолжает учиться языковому моделированию на новом корпусе.
- SFT, supervised fine-tuning: обучение на примерах желательного поведения, например на диалогах или парах «вход — правильный ответ».
- Обучение по предпочтениям, например DPO: для одного запроса показывают более и менее предпочтительный ответы.
- Обучение с подкреплением: поведение меняют по сигналу награды, который задаётся отдельно от простого эталонного продолжения.
Эти этапы можно сочетать, но проходить их все для каждого проекта не требуется. Для классификации обращений с понятным эталоном разумно сначала исследовать SFT. Если модель умеет отвечать, но систематически выбирает нежелательный стиль или стратегию из нескольких допустимых, может понадобиться обучение на предпочтениях. Состав доступных подходов и тренеров показывает обзор TRL.
Instruction tuning обычно означает SFT на инструкциях и ответах. PEFT, parameter-efficient fine-tuning, — семейство методов, которые обучают лишь небольшую часть параметров или добавленные компоненты. LoRA относится к PEFT; PEFT не ограничивается LoRA.
Сначала выберите цель обучения, затем способ изменения весов
Две оси удобно рассматривать раздельно.
| Цель | Какие данные нужны | Какой результат ожидается |
|---|---|---|
| Продолжение предобучения | Тексты подходящей предметной области | Адаптация к распределению текстов и терминологии |
| SFT | Входы и эталонные ответы либо диалоги | Более устойчивое воспроизведение нужного поведения |
| DPO | Запрос и пара ответов с предпочтением | Сдвиг предпочтения в сторону выбранного ответа |
| Методы обучения с подкреплением | Запросы и определённый сигнал награды | Оптимизация поведения относительно награды |
Эта таблица описывает цели, а не гарантированные улучшения. Корпус с ошибками, плохие эталоны или неверно заданная награда способны закрепить нежелательное поведение. Документация TRL отдельно различает форматы языкового моделирования, prompt-completion и предпочтений.
Вторая ось — какие параметры обновляются:
| Способ | Что обучается | Что важно учитывать |
|---|---|---|
| Полное дообучение | Все выбранные для обучения веса базовой модели | Градиенты и состояние оптимизатора требуют дополнительных ресурсов |
| Частичное обновление | Заранее выбранные слои или компоненты | Выбор замороженных и обучаемых частей влияет на возможности адаптации |
| LoRA | Небольшие добавочные матрицы, база обычно заморожена | Нужно выбрать целевые слои, ранг и способ применения адаптера |
| QLoRA | LoRA-адаптеры поверх низкобитной замороженной базы | Совместимость квантования, вычислительной точности и обучения |
Получается конкретная схема: например, SFT + LoRA для изменения формата ответа или SFT + QLoRA, если критична память базы. Само слово LoRA ещё не сообщает, какие примеры использовались и какую функцию ошибки оптимизировали.
Как работает полное дообучение модели
При полном fine-tuning изменяются все параметры, включённые в оптимизатор. Это даёт возможность корректировать модель по всей сети, но создаёт большие состояния обучения: кроме весов нужны градиенты, состояния оптимизатора и активации для обратного прохода. Память зависит также от длины последовательности, batch size, точности вычислений и распределения по устройствам. Руководство по обучению Transformers.
Размер файла готовой модели не показывает, сколько памяти потребует её полное обучение. Нельзя взять расчёт весов для инференса и объявить его требованиями к обучающему серверу. Техники распределения, checkpointing активаций и оптимизатор меняют картину, поэтому универсальная рекомендация «одна GPU для любой модели среднего размера» ненадёжна.
Полное обновление рассматривают, когда ограничения адаптерного подхода подтверждены сравнением, есть данные и ресурсы для контролируемого эксперимента. Выбирать его только потому, что слово «полное» звучит надёжнее, не стоит. И LoRA, и full fine-tuning могут переобучиться на узком датасете.
Как устроена LoRA: матрицы, ранг и масштаб
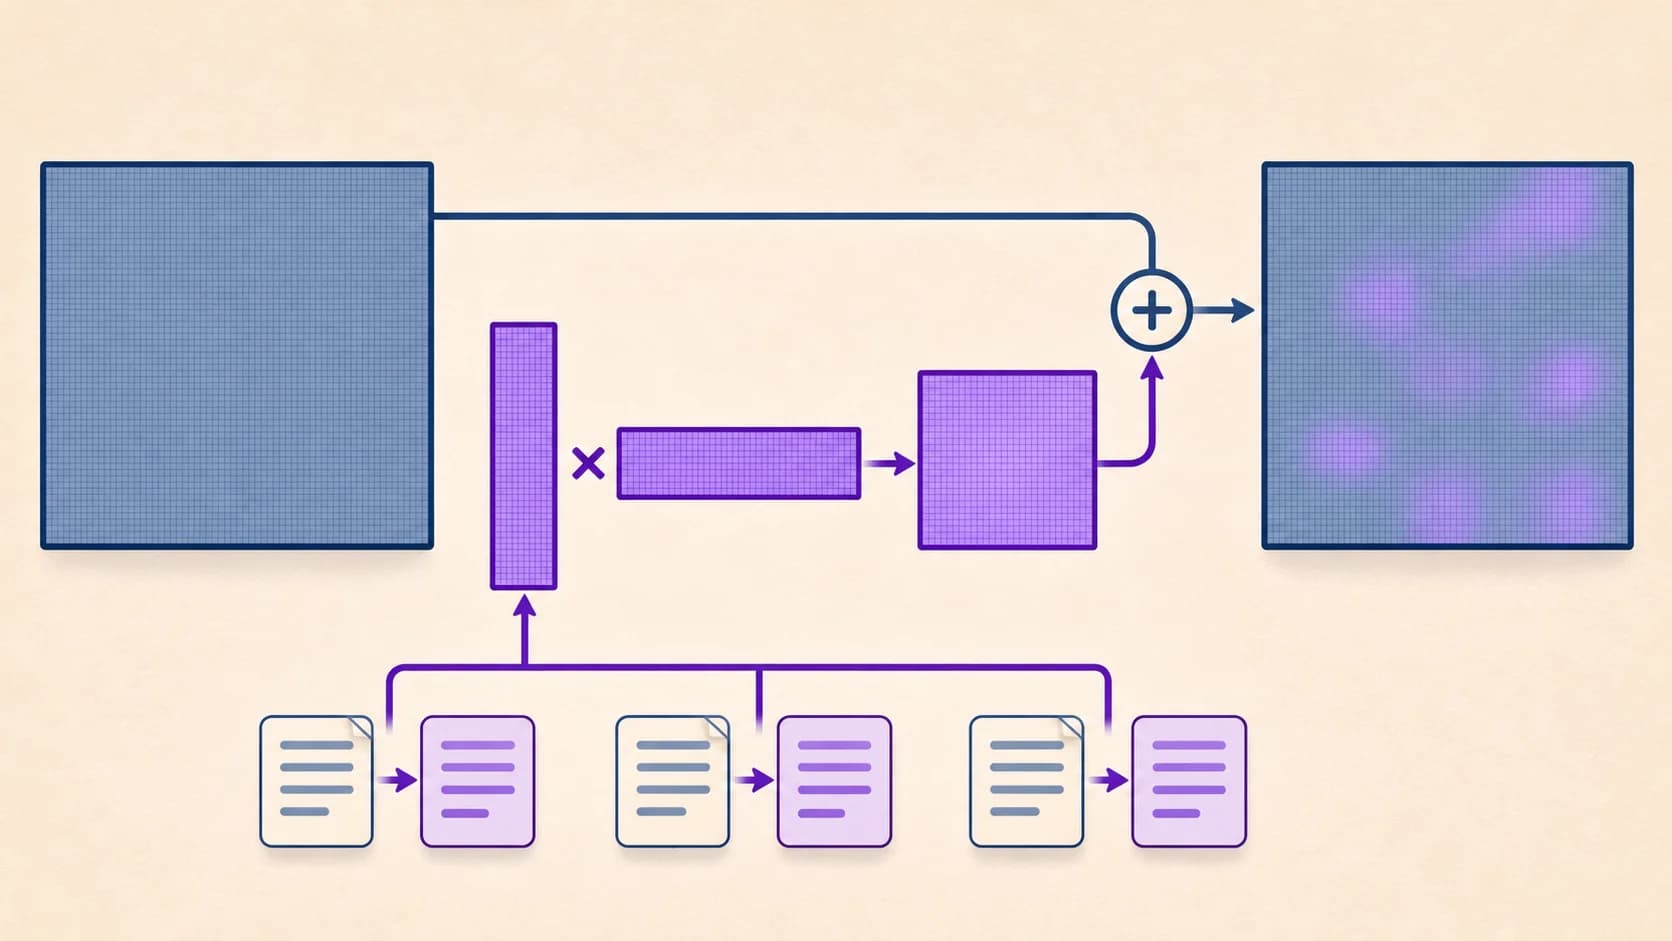
LoRA, Low-Rank Adaptation, сохраняет базовую матрицу весов и обучает небольшое низкоранговое дополнение. В упрощённой записи:
W_новая = W_базовая + s × B × AЕсли базовая матрица имеет размер d_out × d_in, то добавочные матрицы можно представить размерами d_out × r и r × d_in. Параметр r, или ранг, ограничивает размер этого дополнения. Вместо изменения всей матрицы обучаются две меньшие. Это основной принцип оригинальной работы LoRA.
Для условной квадратной матрицы 4096 × 4096 исходное число параметров равно 16 777 216. При ранге 16 две добавочные матрицы содержат 4096 × 16 + 16 × 4096 = 131 072 параметра. Это в 128 раз меньше для добавляемого обновления этой одной матрицы. Расчёт не означает уменьшения всей модели или всей GPU-памяти в 128 раз: базовые веса по-прежнему нужны, как и активации обучения.
В типичной конфигурации PEFT масштаб обновления связан с lora_alpha / r; у rank-stabilized LoRA используется другая зависимость — от квадратного корня ранга. Поэтому сравнивать только r без масштаба и варианта метода недостаточно. Руководство PEFT по LoRA.
У адаптера нет независимой способности отвечать без базы. Он описывает изменения конкретных компонентов конкретной модели. Это важно и для хранения, и для смены версии, и для развертывания.
Какие слои обучать и почему больший ранг не гарантирует успех
Параметр target_modules определяет, к каким модулям добавить LoRA. В Transformer это могут быть проекции внимания и линейные слои других блоков. Названия модулей различаются между архитектурами; список из чужого примера нельзя автоматически переносить в свою модель.
PEFT поддерживает и более широкий выбор вроде target_modules="all-linear". Для QLoRA-подобного обучения документация описывает применение адаптеров ко всем линейным слоям. Но это не универсальный оптимум: меняются объём обучаемых параметров и возможности адаптации. Для некоторых MoE-архитектур целями могут быть параметры, которые устроены иначе, чем обычные линейные модули. Настройка целевых модулей в PEFT.
Увеличение ранга расширяет пространство обновления и расход ресурсов адаптера. Оно не исправляет противоречивую разметку, ошибочный chat template или обучение на неправильных токенах. Если модель выдаёт корректный JSON, но выбирает неправильную категорию обращения, добавление ранга без анализа данных может ничего не решить.
Для первого сравнения зафиксируйте базу, данные, учебную цель и целевые модули. Затем меняйте один существенный фактор. Это предлагаемый порядок эксперимента, а не выполненное нами сравнение конфигураций.
Что добавляет QLoRA и почему обучение не становится полностью четырёхбитным
QLoRA объединяет LoRA с квантованной базовой моделью. Базовые веса хранятся компактно и остаются замороженными; обучаемые дополнения позволяют адаптировать поведение. В исходной работе описаны NF4, двойное квантование и paged optimizers. Это согласованный метод экономии ресурсов, а не просто файл с «Q4» в названии. Оригинальная работа QLoRA.
Хранение базы в четырёх битах не означает, что все умножения, активации и градиенты тоже четырёхбитные. Точность хранения и точность вычислений задаются отдельно. В документации PEFT приведён вариант NF4 с вычислениями BF16, подготовкой через prepare_model_for_kbit_training и последующим добавлением LoRA. Это порядок для поддерживаемой комбинации библиотек и оборудования. Квантование и PEFT.
Под «двойным квантованием» здесь понимается дополнительное сжатие констант квантования, а не два последовательных прохода обучения или обычная повторная конвертация Q4-файла. NF4 — тип представления из этой схемы; он не тождественен любому INT4 или Q4_K_M.
QLoRA уменьшает часть расходов, но не убирает зависимость от длины примеров и обучающего batch size. При длинных диалогах существенную память могут занимать активации. Утверждение «веса помещаются — значит обучение точно запустится» неверно.
Чем SFT отличается от продолжения предобучения и DPO
При SFT модель учится выдавать нужное продолжение для заданного входа. Например, сообщение клиента должно превращаться в короткий ответ поддержки или запись с категорией и извлечёнными полями. Существенны не только тексты, но и то, на каких токенах считается ошибка. Устройство SFTTrainer.
Продолжение предобучения на отраслевых текстах может менять знание терминологии и закономерностей области. Но оно не превращает веса в управляемую базу актуальных регламентов с проверяемыми ссылками. Модель способна усваивать факты, однако их точное обновление, удаление и воспроизводимое цитирование требуют другого механизма. Для изменяемых документов компании часто сохраняют RAG; адаптацию поведения при необходимости добавляют отдельно. Подробно различие задач разобрано в сравнении RAG, fine-tuning и prompt engineering.
DPO, Direct Preference Optimization, использует предпочтения: для одного запроса есть выбранный ответ chosen и отвергнутый rejected. Метод меняет относительное предпочтение с опорой на эталонную политику; это другая функция обучения, чем простое воспроизведение единственного эталона. Реализация может заранее вычислять оценки эталонной модели, поэтому физическая конфигурация обучения зависит от настроек. DPOTrainer.
DPO не следует добавлять автоматически после любого SFT. Если «предпочтительный» ответ просто длиннее и эксперт выбирает его по длине, модель может усвоить это смещение. Правило предпочтения должно отражать нужное свойство: корректность, полноту, тон или соблюдение ограничения.
Как выглядят данные для SFT и обучения на предпочтениях
Для диалогового SFT подходят записи с ролями system, user, assistant, если выбранный тренер и шаблон поддерживают такой формат. Вот вымышленный пример одной записи. Он иллюстрирует структуру диалога; одного примера недостаточно для вывода о пригодности датасета.
{
  "messages": [
    {"role": "system", "content": "Определи категорию обращения. Верни JSON с полями category и order_id. Не придумывай отсутствующий номер заказа."},
    {"role": "user", "content": "Заказ 104 приехал с повреждённой крышкой. Как оформить замену?"},
    {"role": "assistant", "content": "{\"category\":\"damaged_item\",\"order_id\":\"104\"}"}
  ]
}
Эталон задаёт формат и категорию, но не придумывает процедуру замены или обещание возврата. Если цель — извлекать данные, не стоит незаметно обучать модель ещё и сочинять правила обслуживания. Отсутствующий номер заказа должен быть представлен предусмотренным схемой способом, одинаково во всём датасете.
Для DPO структура другая. Следующий пример показывает предпочтение ответа, который не выдумывает статус заказа:
{
  "prompt": "Заказ 104 уже отправлен? Данных о статусе нет.",
  "chosen": "У меня нет данных о статусе заказа 104. Для ответа нужна проверка в системе заказов.",
  "rejected": "Да, заказ 104 отправлен и прибудет завтра."
}
Это учебная пара, не результат эксперимента. Схемы messages и prompt/chosen/rejected описаны в документации форматов TRL. Конкретный загрузчик может ожидать JSONL, dataset-объект или иной контейнер; JSON с полями сам по себе не подтверждает совместимость всего обучающего процесса.
Почему токенизатор, chat template и маска loss так важны
Токенизатор переводит текст в токены. Chat template превращает сообщения с ролями в последовательность со специальными маркерами модели. Маска loss определяет, какие позиции участвуют в расчёте ошибки. Эти три компонента легко спутать, хотя они решают разные задачи.
Диалог в JSON ещё не является готовым обучающим представлением. Если шаблон не соответствует модели, она может видеть неправильные границы сообщений или лишние служебные токены. Документация Transformers отдельно предупреждает о дублировании специальных токенов при ручном форматировании и повторной токенизации. Chat templates.
Для prompt-completion-наборов SFTTrainer предусматривает обучение на completion. Для conversational-наборов режим assistant_only_loss=True позволяет считать ошибку только на ответах ассистента, но требует совместимого шаблона, способного выделять соответствующие участки. Поддержка и автоматическая подготовка зависят от семейства модели и версии библиотек. Один флаг не исправляет произвольный шаблон. Настройка loss в SFTTrainer.
Практический вопрос перед длительным запуском: какие именно токены модель будет учиться предсказывать в этой записи? Убедитесь, что нужный ответ попал в последовательность и не был срезан лимитом длины, а пользовательский текст не оказался целью обучения вопреки замыслу. Это особенно существенно для длинных переписок, где эталон стоит в конце.
Как подготовить данные и разделить выборки
Начните с правил, которые определяют хороший ответ. Для примера с повреждённым товаром нужны определения категорий, границы допустимых значений и правило для недостающих данных. Если эксперты сами по-разному размечают одинаковую ситуацию, модель получит конфликтующие цели.
В наборе должны встречаться типовые и пограничные входы: явный номер заказа, отсутствующий номер, несколько номеров, описка, сообщение без достаточного контекста. Синтетические записи могут дополнять покрытие, но их метки и факты требуют проверки. Они не доказывают качество на реальных обращениях. Ограничения разобраны в FAQ о синтетических данных.
Разделяйте данные по источнику зависимости. Реплики одной переписки, почти одинаковые обращения и шаблонные варианты одного документа нельзя бездумно распределять между train и test: модель может встречать в обучении почти тот же пример, по которому её потом оценивают. Если важна работа на будущих обращениях, рассмотрите временное разделение. Это методическая рекомендация, а не универсальная пропорция выборок.
Train служит обучению. Validation помогает выбирать настройки и остановку. Test нужен для итоговой оценки после выбора. Повторный подбор параметров по тестовым ошибкам постепенно превращает test в ещё одну validation-выборку.
Универсального количества примеров нет. Важны разнообразие входов, согласованность эталонов, сложность операции и исходные возможности модели. Размер корпуса и число проходов следует рассматривать вместе: многократное повторение узкого набора не создаёт новых независимых ситуаций.
Какие параметры управляют экспериментом
| Параметр | На что влияет | Типичная ошибка интерпретации |
|---|---|---|
| Learning rate | Размер обновления обучаемых параметров | Перенос значения с полного fine-tuning на LoRA без проверки |
| Число эпох или шагов | Сколько обновлений получит модель | Предположение, что дольше всегда лучше |
| Batch size и accumulation | Состав одного обновления и расход ресурсов | Учёт только числа примеров на одной GPU |
| Максимальная длина | Какие части примеров попадут в обучение | Незаметное отрезание эталонного ответа |
| Ранг r и alpha | Ёмкость и масштаб LoRA-обновления | Изменение r без учёта варианта масштабирования |
| Target modules | Где модель получает обучаемое дополнение | Копирование названий слоёв другой архитектуры |
| Packing | Объединение примеров в последовательности | Включение без понимания разделения примеров и работы тренера |
| Маска loss | Какие токены создают учебный сигнал | Обучение на ненужных ролях или пустых целевых участках |
Настройки этих механизмов описаны в PEFT LoRA и SFTTrainer. Таблица объясняет смысл параметров; готового универсального набора значений здесь нет.
Для сохранения воспроизводимости запишите ревизию базы, токенизатор и шаблон, версии библиотек, подготовку и разделение данных, конфигурацию обучения и источник checkpoint. Случайное зерно полезно сохранить, но само по себе оно не гарантирует одинаковый результат на любом оборудовании и стеке.
Почему падающий training loss ещё не доказывает улучшение
Training loss показывает, насколько модель подстраивается под обучающие последовательности. Она может запоминать повторы, лучше воспроизводить стиль и одновременно хуже отвечать на новые входы. Оценка на отложенных данных нужна именно для отделения подгонки от полезного переноса.
В учебной задаче извлечения номера заказа следует раздельно проверить: валиден ли JSON, верна ли категория, правильно ли извлечён номер и не появился ли выдуманный номер при его отсутствии. Суммарное впечатление «ответ выглядит профессионально» таких ошибок не обнаруживает.
Сравнивайте адаптированную и базовую модель при одинаковых входах и условиях генерации. Если одновременно сменились шаблон, системная инструкция и подключённый поиск, результат нельзя полностью приписать LoRA. Для важных общих функций сохраните набор регрессионных задач, чтобы заметить побочные ухудшения.
Возможные причины проблем различаются. Ухудшение после нескольких проходов может указывать на переобучение; одинаково плохое поведение с начала — на неверные данные или формат; обрывы — на лимит длины либо завершение последовательности. Это диагностические гипотезы, которые нужно проверять по артефактам запуска. Собственных наблюдений об этих сбоях статья не заявляет.
Что сохраняется после LoRA и как выпустить результат
При сохранении PEFT-адаптера файл adapter_model.safetensors содержит параметры адаптера, а adapter_config.json — его конфигурацию и сведения о базе. Это не полный набор базовых весов. Для восстановления нужны совместимые исходные веса; точную ревизию лучше фиксировать явно. Формат checkpoint PEFT.
Есть два основных варианта использования: загрузить базу и адаптер вместе либо слить поддерживаемый адаптер с базовыми весами. PEFT описывает merge_and_unload, но доступность слияния зависит от метода и схемы квантования. Нельзя считать, что любой низкобитный checkpoint допускает любую операцию слияния. Варианты объединения моделей и адаптеров.
Если после слияния модель экспортируют и квантуют для инференса, появляется ещё один объект проверки. Нужен тест именно того файла и движка, которые попадут в сервис. Причины изложены в практическом руководстве по квантованию и GGUF.
Датасет, токенизатор, шаблон и настройки имеют такую же практическую ценность для повторения обучения, как итоговый адаптер. При смене базовой модели совместимость не предполагается автоматически. Откат должен возвращать весь согласованный набор компонентов, а не только файл весов.
Какие ещё методы стоит знать: DoRA, prompt tuning и дистилляция
DoRA развивает адаптерный подход, разделяя изменение направления и величины весов. В PEFT он включается отдельной настройкой и имеет свои требования и ограничения. Это вариант для сравнения при конкретной задаче, а не гарантированное улучшение любой LoRA. Документация описывает также разные инициализации и варианты рангов: изучать их имеет смысл после того, как понятны данные и базовая постановка. Варианты LoRA и DoRA.
Prompt tuning и prefix tuning обучают дополнительные непрерывные представления на входе или в механизме модели. Это не обычное редактирование текстовой инструкции человеком. Они относятся к параметрически эффективной адаптации, но отличаются от LoRA местом и способом приложения обучаемого дополнения. Знакомство с PEFT.
Дистилляция использует модель-учителя как источник обучающего сигнала для ученика. Например, ответы учителя могут стать материалом для SFT ученика; при этом нужны проверка качества и права на использование данных. Дистилляция и LoRA могут участвовать в одном проекте, потому что отвечают на разные вопросы: откуда берётся сигнал и какие параметры обновляются. Отдельный разбор дистилляции LLM.
Как выбрать схему для своей задачи
Если модель не получает нужные актуальные факты, сначала обеспечьте доступ к источнику: поиск по документам, API или базе данных. Если факты есть, но ответ стабильно нарушает согласованный формат и примеры в инструкции не помогают, рассматривайте SFT. При ограничениях ресурсов сравните LoRA или QLoRA с доступной базой.
Если задача состоит в изменении предпочтения между допустимыми ответами и у вас есть надёжные сравнительные оценки, рассмотрите DPO. Если модель плохо работает с языком и распределением отраслевых текстов, вопрос продолжения предобучения заслуживает отдельного исследования. Эти варианты могут потребовать разных данных, поэтому общий архив компании нельзя считать готовым универсальным датасетом.
Полное дообучение выбирают по подтверждённой необходимости и доступным ресурсам. Параметрически эффективные методы — полезная отправная точка для сравнения, но решение определяется качеством конкретной операции. Увеличивать сложность схемы стоит после того, как понятна ошибка более простого варианта.
Частые вопросы о fine-tuning и адаптерах
LoRA — это модель меньшего размера?
Нет. Адаптер небольшой, но во время работы ему нужна базовая модель. Компактный файл адаптера нельзя сравнивать с полным checkpoint как два самостоятельных исполнителя одной задачи.
QLoRA и Q4_K_M — одно и то же?
Нет. QLoRA — схема обучения адаптера поверх квантованной базы. Q4_K_M — вариант представления тензоров в экосистеме GGUF. Факт успешного запуска GGUF не означает готовности этой же копии к обучению через TRL.
Можно ли обучить модель только на документах компании?
Можно продолжать языковое обучение на текстах, если позволяют права, данные и инструменты. Для обучения нужным ответам потребуются примеры соответствующего поведения. Документы, диалоги SFT и пары предпочтений — разные учебные сигналы.
Может ли адаптер раскрывать обучающие данные?
Сам по себе адаптерный метод не является механизмом обезличивания или гарантией конфиденциальности. Чувствительные данные нужно обрабатывать по установленным правилам до обучения, ограничивать доступ к артефактам и отдельно проверять поведение системы. Утверждение «мы обучаем только маленькие матрицы, поэтому утечки невозможны» необоснованно.
Как AI студия Владимира Ломтева помогает адаптировать языковую модель
AI студия Владимира Ломтева может подготовить данные для дообучения, дообучить и протестировать LLM, развернуть её и интегрировать с корпоративными источниками. Метод выбирается по нужному поведению, доступным данным и ограничениям инфраструктуры, без обещания результата по одному названию LoRA или QLoRA.
Первый шаг — выбрать один процесс и описать текущие ошибки модели, исходные данные и критерий пригодного ответа. Так становится ясно, нужен ли новый учебный сигнал или достаточно изменить доступ к информации и инструкцию. Обсудить задачу.
Итог: дообучение начинается с учебной задачи
Сначала определите, чему учить модель: продолжать тексты области, воспроизводить эталонные ответы или предпочитать один ответ другому. Затем выберите, как менять параметры: полностью, частично или через адаптер. LoRA и QLoRA помогают управлять ресурсами, но не заменяют корректные данные, шаблон и оценку.
Результат проекта — согласованный набор базы, адаптера или полных весов, токенизатора, настроек и подтверждённых ограничений. Проверять нужно поведение итогового сервиса на новых входах. Маленький файл адаптера и падающий training loss сами по себе ещё не показывают, что задача решена.