Синтетические данные — это искусственно созданные записи, тексты или изображения, которые повторяют свойства реальных данных и используются для обучения и тестирования моделей ИИ. Они помогают, когда реальных примеров мало, редкие случаи почти не встречаются или данные нельзя использовать напрямую. Но они не заменяют проверку на реальных данных и не гарантируют приватность сами по себе.
Материал подготовлен AIrassvet 25 октября 2026 года для руководителей и владельцев данных, которые слышат от подрядчика «данных мало, можно добавить синтетику» и хотят понять, что за этим стоит. Ответы опираются на публикации в Nature и на arXiv, технические отчёты NVIDIA и Microsoft, документацию библиотеки SDV и текст 152-ФЗ. Собственных экспериментов мы не проводили. Это не юридическая консультация: правовой статус конкретного набора данных оценивайте с юристом.
Содержание
- Кратко
- Что входит и не входит в эту статью
- Вопросы об основах
- Вопросы о применении
- Вопросы о рисках, качестве и законе
- Синтетические данные по типам задач: сводная таблица
- Первоисточники и метод проверки
Кратко
- Где помогают: редкие случаи и дефекты, компьютерное зрение через рендер, инструкции для дообучения языковых моделей, тестовые наборы для проверки систем.
- Кто использует: по техническому отчёту NVIDIA, более 98% данных на этапе выравнивания модели Nemotron-4 340B были синтетическими.
- Главный риск качества: модель, обученная на синтетике, может хуже работать на реальном потоке. Итоговая проверка — только на отложенных реальных данных.
- Главный риск приватности: исследование Stadler и соавторов показало, что синтетика либо не защищает от атак на вывод, либо теряет полезность.
- Долгосрочный риск: бесконтрольное обучение на сгенерированных данных ведёт к «коллапсу модели», по статье в Nature 2024 года.
Что входит и не входит в эту статью
Мы отвечаем на вопросы о синтетических данных для обучения и тестирования моделей: табличных, текстовых и изображений. Мы не разбираем подробно алгоритмы генерации, дифференциальную приватность и правовой режим обезличенных данных — про обезличивание и передачу клиентских данных в ИИ мы писали в отдельной статье о клиентских данных и нейросетях.
Термины. *Реальные данные* — собранные из работы компании: продажи, фотографии продукции, обращения. *Генератор* — модель или программа, создающая синтетику. *Отложенная выборка* — реальные данные, которые не участвуют в обучении и нужны только для итоговой проверки. *Аугментация* — изменение существующих примеров: поворот, обрезка, шум.
Вопросы об основах
Что такое синтетические данные?
Это данные, которые создал алгоритм, а не собрали из реальных событий. Генератор изучает свойства исходного набора или работает по заданным правилам и выдаёт новые записи: строки таблицы, тексты, изображения. Цель — сохранить закономерности, полезные для обучения модели, но получить больше примеров, нужные редкие случаи или набор без прямых сведений о реальных клиентах.
Какие бывают синтетические данные?
По типу содержимого выделяют четыре основные группы. Табличные — строки с теми же столбцами и распределениями, что в исходной таблице. Временные ряды и последовательности — продажи, показания датчиков, история действий. Текстовые — вопросы, ответы, диалоги и инструкции, созданные языковой моделью. Изображения и видео — рендер 3D-моделей или генерация нейросетью. Для каждого типа свои инструменты и свои способы проверки.
Используют ли синтетические данные крупные разработчики моделей?
Да, и это задокументировано. В техническом отчёте Nemotron-4 340B от июня 2024 года NVIDIA пишет, что более 98% данных на этапе выравнивания модели были сгенерированы синтетически. Microsoft обучила модель phi-1 для программирования на 6 млрд токенов отобранных веб-данных и 1 млрд токенов синтетических учебников и упражнений, созданных GPT-3.5. Модель с 1,3 млрд параметров набрала 50,6% pass@1 на тесте HumanEval.
Чем синтетические данные отличаются от аугментации?
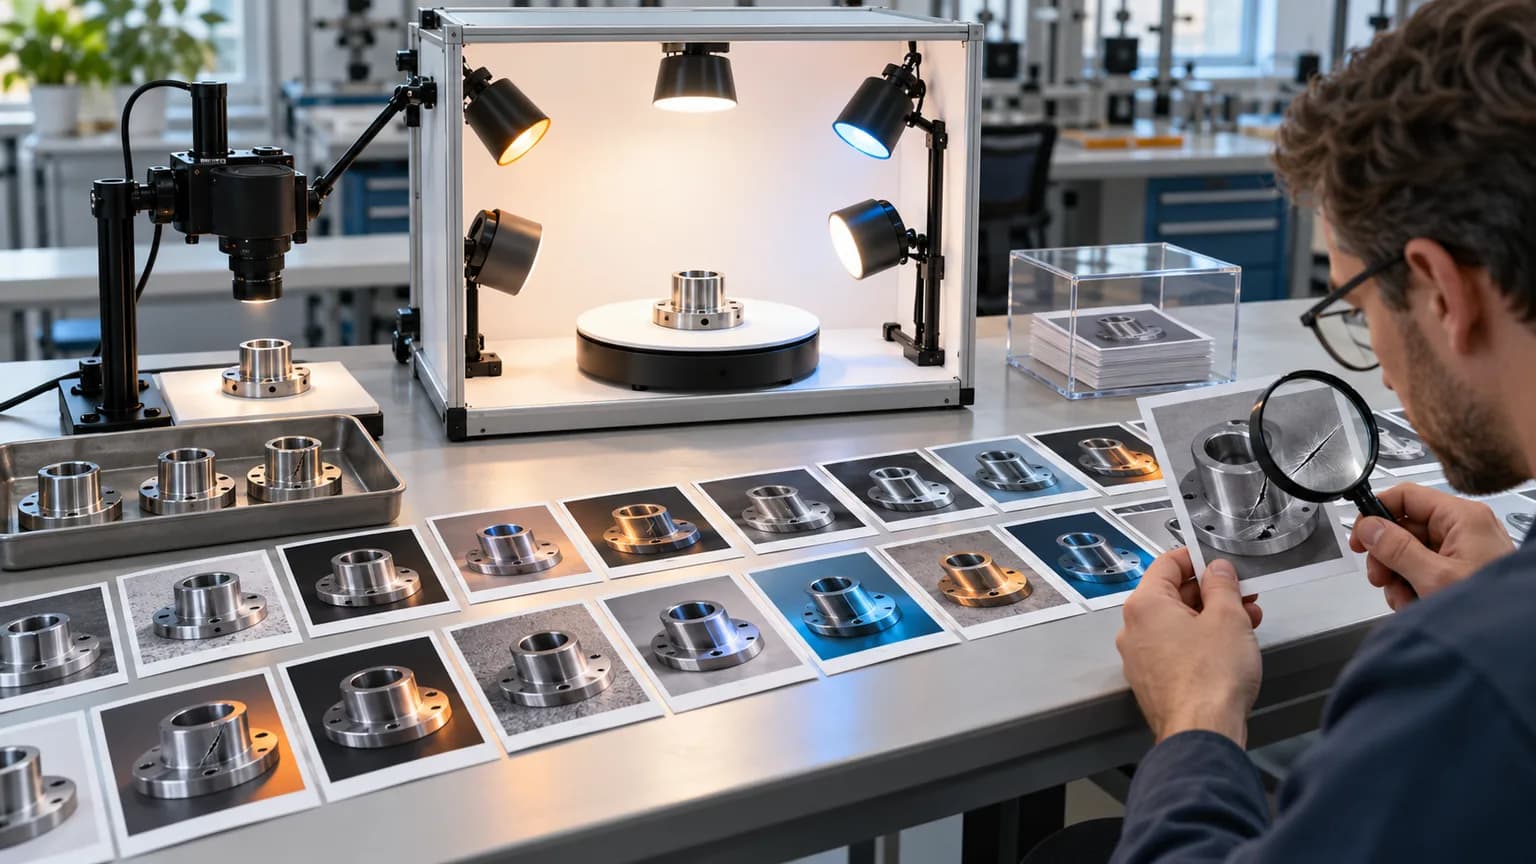
Аугментация изменяет уже существующий пример, а синтетика создаёт новый. Повернуть фотографию детали, изменить яркость или добавить шум — аугментация: объект и дефект остаются теми же. Отрендерить деталь с царапиной в новом месте, под другим светом и на другом фоне — синтетика. На практике оба подхода часто сочетают: аугментация дёшева, синтетика даёт варианты, которых в реальных данных не было вообще.
Вопросы о применении
У нас мало данных — поможет ли синтетика?
Может помочь, но не заменит реальные примеры полностью. Синтетика полезна, когда мало редких случаев: дефектов, отказов, нестандартных обращений. Если реальных данных нет вообще, генератору не на что опереться, а проверить модель будет не на чем. Минимум — небольшой реальный набор для настройки генератора и отложенная реальная выборка для итоговой оценки. О сборе и разметке реальных данных мы писали в статье про подготовку данных для ИИ.
Можно ли обучить компьютерное зрение на синтетических изображениях?
Да, это один из самых проработанных сценариев. В работе Tobin и соавторов 2017 года детектор объектов обучили только на изображениях из симулятора со случайными нереалистичными текстурами, и на реальных снимках он определял положение объекта с точностью 1,5 см. Приём называется доменной рандомизацией: если в синтетике достаточно вариаций, реальный мир выглядит для модели ещё одним вариантом. Реальные снимки по-прежнему нужны для проверки и разметки.
Можно ли сгенерировать данные для дообучения языковой модели с помощью другой модели?
Да, так готовят вопросы, ответы и инструкции для дообучения и дистилляции. Сильная модель генерирует примеры, специалисты проверяют выборку, затем на них дообучают меньшую модель. Перед этим проверьте лицензию генерирующей модели: у ряда поставщиков есть условия на использование ответов для обучения других моделей. Подробнее — в материалах о дообучении LLM и дистилляции.
Подходят ли синтетические данные для табличных задач: прогнозов, скоринга, оттока?
Подходят, но с осторожностью. Например, библиотека SDV умеет синтезировать одиночные таблицы, связанные таблицы и последовательные данные. Это полезно для тестовых сред, обмена данными с подрядчиком и усиления редких классов. Для прогноза спроса или оттока синтетика рискованна: генератор может сгладить сезонность, выбросы и связи между признаками. Качество модели всегда сравнивайте с моделью, обученной только на реальных данных.
Можно ли тестировать ИИ-систему на синтетических данных?
Да, и это часто безопаснее, чем обучение. Синтетические обращения, документы и диалоги помогают проверить граничные случаи: опечатки, странные форматы, попытки обойти правила. Это хорошо подходит для тестовой среды, где нельзя использовать реальные данные клиентов. Но приёмку системы проводите на реальных примерах из рабочего потока: синтетический тест показывает, что система справляется с придуманными случаями, а не с вашими.
Вопросы о рисках, качестве и законе
Являются ли синтетические данные персональными?
Зависит от того, можно ли по ним определить конкретного человека. По статье 3 закона № 152-ФЗ персональные данные — любая информация, относящаяся к прямо или косвенно определённому или определяемому физическому лицу. Если синтетические записи повторяют реальные слишком близко или генератор «запомнил» редких клиентов, связь с человеком может сохраниться. Поэтому статус набора оценивают по результатам проверки, а не по названию «синтетический».
Защищает ли синтетика от утечки персональных данных?
Не гарантирует. Stadler, Oprisanu и Troncoso в работе «Synthetic Data — Anonymisation Groundhog Day» оценили ряд генеративных моделей и пришли к выводу: синтетические данные либо не предотвращают атаки на вывод, либо теряют полезность. Авторы также отмечают, что выигрыш в приватности трудно предсказать заранее. Поэтому синтетику для обмена данными сочетают с проверкой на атаки и формальными методами защиты.
Что такое коллапс модели и грозит ли он бизнесу?
Это деградация моделей, которые обучают на данных, сгенерированных предыдущими моделями. В статье Shumailov и соавторов в Nature от 24 июля 2024 года показано: бесконтрольное использование сгенерированного контента вызывает необратимые дефекты, у модели пропадают «хвосты» исходного распределения. Для бизнеса вывод практический: храните реальные данные, помечайте синтетические и не обучайте модель только на собственной генерации.
Как проверить качество синтетических данных?
Проверяют по трём направлениям. Похожесть: совпадают ли распределения и связи между признаками с реальными. Полезность: обучите модель на синтетике и проверьте на отложенных реальных данных, затем сравните с моделью на реальных данных. Приватность: нет ли записей, почти совпадающих с реальными, и устойчив ли набор к атакам на вывод. Отложенная реальная выборка никогда не должна попадать в генератор.
Сколько синтетических данных добавлять к реальным?
Универсальной пропорции нет: её подбирают экспериментом. Обучите несколько вариантов модели с разной долей синтетики и сравните их на одной отложенной реальной выборке по метрике, важной для бизнеса. Если добавление синтетики перестаёт улучшать результат или ухудшает его на реальных данных, остановитесь. Отдельно смотрите на редкие классы: синтетика может улучшить их распознавание, но ухудшить частые случаи.
Какие инструменты используют для генерации?
Выбор зависит от типа данных. Для таблиц и последовательностей есть, например, библиотека SDV; она распространяется по Business Source License, которая запрещает использовать её для коммерческого сервиса генерации синтетики для третьих лиц. Для текстов используют языковые модели; NVIDIA открыла конвейер генерации синтетических данных, применявшийся для Nemotron-4. Для изображений — 3D-рендер и генеративные модели. Лицензию инструмента проверяйте до начала проекта.
Сколько стоит подготовка синтетических данных и сколько времени она занимает?
Универсальной цены и срока нет: они зависят от типа данных, объёма и требований к проверке. Основные статьи затрат — подготовка реального образца, настройка генератора или 3D-сцены, вычисления, проверка качества и приватности, повторное обучение модели. Самая частая ошибка — не заложить время на сравнение с реальными данными. Реалистичную оценку даёт небольшой пилот на одной задаче с заранее выбранной метрикой.
Синтетические данные по типам задач: сводная таблица
| Задача | Как получают синтетику | Главный риск | Как проверить |
|---|---|---|---|
| Компьютерное зрение | 3D-рендер с рандомизацией света, фона, положения; генеративные модели | Разрыв между рендером и реальной камерой | Метрики на отложенных реальных снимках с той же линии |
| Дообучение LLM | Генерация вопросов, ответов и инструкций сильной моделью | Ошибки генератора, ограничения лицензии | Выборочная экспертная проверка, тест на реальных вопросах |
| Табличные модели | Статистические и нейросетевые генераторы таблиц | Потеря сезонности, выбросов и связей | Сравнение с моделью на реальных данных |
| Тестирование систем | Генерация граничных случаев и документов | Тест не отражает реальный поток | Приёмка на реальных примерах |
| Обмен данными с подрядчиком | Синтетическая копия структуры и распределений | Остаточная связь с реальными людьми | Проверка на близкие записи и атаки на вывод |
Таблица — наша сводка по источникам ниже, а не стандарт отрасли.
Первоисточники и метод проверки
Мы проверили утверждения 25 октября 2026 года по первоисточникам:
- Shumailov I. et al. AI models collapse when trained on recursively generated data, Nature, опубликовано 24.07.2024;
- NVIDIA. Nemotron-4 340B Technical Report, arXiv:2406.11704, июнь 2024;
- Gunasekar S. et al. Textbooks Are All You Need, arXiv:2306.11644 — модель phi-1;
- Tobin J. et al. Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World, arXiv:1703.06907;
- Stadler T., Oprisanu B., Troncoso C. Synthetic Data — Anonymisation Groundhog Day, arXiv:2011.07018;
- Федеральный закон № 152-ФЗ «О персональных данных», статья 3;
- README и лицензия библиотеки SDV.
Цифры приведены так, как их сообщают авторы, в указанных ими условиях. Рекомендации о проверке и пропорциях — наша редакционная интерпретация, а не результат собственного эксперимента.
Как AIrassvet помогает, когда для ИИ-проекта не хватает данных
Решение «добавить синтетику» стоит принимать после того, как понятно, каких именно примеров не хватает и как будет проверяться результат. На сайте AIrassvet среди направлений указаны аудит процессов и подготовка данных, решения компьютерного зрения, ML-прогнозирование, а также развёртывание и дообучение LLM. Для этой задачи это означает:
- аудит имеющихся данных: каких случаев не хватает и можно ли собрать реальные примеры;
- подготовку данных и отложенной реальной выборки, на которой сравниваются модели с синтетикой и без неё;
- прототип модели компьютерного зрения, прогноза или дообученной LLM с проверкой на реальных данных до запуска.
Первый шаг — выбрать один процесс, для которого не хватает данных, и зафиксировать текущий результат, источники данных, ограничения и критерий приёмки.
Итог: синтетика дополняет реальные данные, а не заменяет их
Синтетические данные — рабочий инструмент: на них выравнивают крупные языковые модели, обучают детекторы объектов и тестируют системы. Но три правила остаются неизменными: итоговая проверка — только на отложенных реальных данных, приватность нужно проверять, а не предполагать, а реальные данные нужно сохранять, чтобы не получить коллапс модели.
Если подрядчик предлагает синтетику, попросите показать, какой метрикой и на каких реальных данных будет доказан эффект. Это главный вопрос, который отделяет обоснованное решение от модного слова.