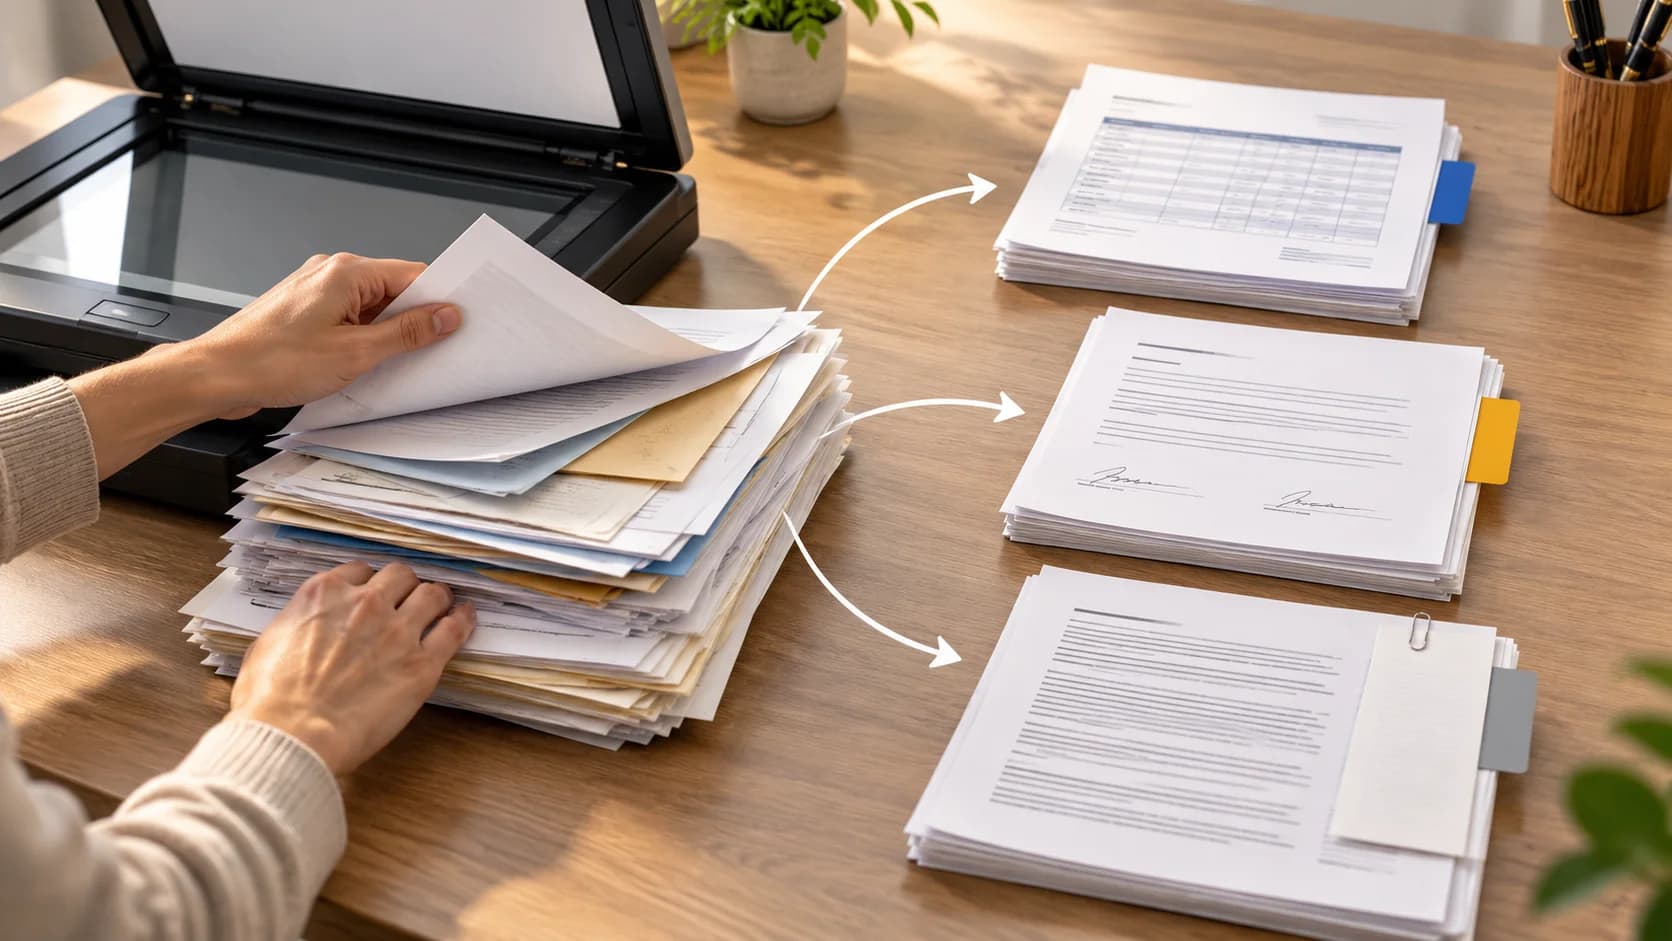
Чтобы разделить сканированный PDF со счетами, актами и договорами, сначала определите границы каждого документа, подтвердите спорные переходы и только затем создавайте отдельные файлы. OCR распознаёт текст, но сам по себе не задаёт эти границы. Ниже — ответы для руководителя документооборота и специалиста интеграций, которым нужно направлять части входящего пакета в подходящий обработчик.
Материал посвящён разделению по целым страницам на примере Google Cloud Document AI. Это документированный подход и учебные примеры, а не отчёт о запуске сервиса на документах компании. Доступность облака, условия оплаты и допустимость передачи данных нужно выяснить до загрузки файлов. Сведения сверены 31 октября 2026 года.
Чем разделение PDF с ИИ отличается от обычной нарезки?
Обычная нарезка отделяет заданные страницы: например, каждые две. ИИ-разделитель пытается найти логические документы по содержимому. В пакете из счёта, акта и договора длина частей может различаться, поэтому фиксированный шаг неудобен.
Подробнее об отдельной задаче распознавания — в материале OCR для бизнеса. В терминологии Google Document AI классификация определяет тип, разделение — состав документов, извлечение — нужные поля. Для бизнеса это разные результаты: знать, что перед вами счёт, ещё недостаточно, чтобы получить его сумму или отдельный PDF.
Когда ИИ нужен, а когда достаточно правил?
Начните с правил, если границы уже известны: отдельные вложения письма, штрихкод начала документа или стабильная разметка. Сохраните эти признаки при передаче в обработку. Модель полезно рассматривать там, где пакеты собираются непредсказуемо и простые признаки регулярно отсутствуют.
| Входящий материал | Предлагаемый подход | Что получить на выходе |
|---|---|---|
| Один счёт отдельным вложением | Сразу классификация или извлечение | Поля исходного документа |
| Общий PDF с достоверными разделителями | Правила разбиения | Файлы по заданным границам |
| Скан счетов, актов и договоров без разделителей | Предсказание границ и типов | Проверяемая карта частей |
| Два документа на одной странице | Отдельная работа с областями страницы | Подготовленные фрагменты, а затем документы |
Это редакционные критерии выбора, не сравнительный тест продуктов. Разделение по страницам не решает последнюю задачу: если акт и счёт занимают разные половины листа, одной карты номеров страниц недостаточно.
Что подготовить до загрузки пакета?
Подготовьте копию файла, перечень ожидаемых типов и пояснения к неоднозначным случаям. Например: приложение к договору остаётся с договором или становится самостоятельным документом? Оба правила могут быть осмысленными, но модель и сотрудник должны ориентироваться на одно.
Для первого разбора используйте обезличенный материал, который разрешено передавать выбранному сервису. Сохраните оригинал отдельно. Не заменяйте его автоматически созданными частями: иначе ошибка на границе осложнит повторную обработку.
Custom Splitter поддерживает пользовательские классы; документация описывает предобученные варианты и обучение на своих документах. Наличие предобученной модели не доказывает качество на русскоязычных актах вашей формы.
Создаёт ли Document AI отдельные PDF автоматически?
Нет. Разделитель возвращает сведения о частях в JSON, а физическое создание файлов выполняется отдельно. Для этого Google указывает утилиты Document AI Toolbox. Этот разрыв важен при постановке задачи интегратору: «получить границы» и «записать файлы в хранилище» — разные операции. Документация поведения разделителей.
Предлагаемый результат первого этапа — карта: идентификатор исходного пакета, тип каждой части, исходные страницы и решение сотрудника. На втором этапе приложение создаёт файлы из подтверждённой карты. На третьем — передаёт их обработчикам полей. Успешное получение JSON не означает, что все три этапа завершены.
Почему первая страница в JSON может выглядеть как пустой объект?
В Entity.pageAnchor.pageRefs[] поле page — индекс с нуля. Нулевое значение может отсутствовать в сериализованном JSON: {} в этом контексте обозначает первую страницу. Это не пустая страница скана. Правило относится именно к объекту ссылки на страницу, а не к любому пустому объекту ответа. Описание формата разделения.
Учебный фрагмент, составленный вручную:
{
  "pageRefs": [{}, {"page": "1"}]
}
Он соответствует первой и второй страницам. При этом pages[].pageNumber использует нумерацию с единицы, как поясняет руководство по ответу Document AI. Не применяйте одинаковое прибавление единицы ко всем полям: сначала определите, индекс это или отображаемый номер.
Как выглядит понятная сотруднику карта разделения?
Показывайте номера исходных страниц, тип и статус решения. Ниже вымышленный пакет из шести страниц; это образец представления, не фактический ответ API.
| Часть | Тип | Страницы исходного PDF | Решение |
|---|---|---|---|
| A | Счёт | 1–2 | Подтвердить после просмотра |
| B | Акт | 3 | Подтвердить после просмотра |
| C | Договор с приложением | 4–6 | Уточнить правило для приложения |
В интерфейсе полезно рядом открывать последнюю страницу текущей части и первую следующей. Сотрудник увидит, не оторвана ли подпись или таблица от предыдущего документа. Для исправления границы ему нужен исходный пакет, а не только извлечённый текст.
Можно ли обойтись одним порогом уверенности, например 0,95?
Универсального порога нет. Высокая уверенность модели сама по себе не является гарантией корректной границы. В рекомендациях Custom Splitter порог предлагают определять по историческим ошибкам с учётом допустимого риска бизнес-процесса.
Практический выбор для старта — подтверждение человеком перед созданием файлов. Если позже появится размеченная история, отдельно рассмотрите типы документов и ошибки: неверный переход между частями, неправильный класс, пропущенная страница. Значение 0,95 здесь — пример обсуждаемого порога, а не рекомендация поставщика или результат нашего теста.
Почему хороший OCR не спасает от ошибки разделения?
Потому что правильный текст и правильная принадлежность страницы — разные свойства. Модель может прочитать подпись, но присоединить лист к следующему акту. Тогда следующий обработчик получит чужую страницу.
Разбирайте причину по очереди: откройте исходный скан, сверяйте текст и расположение блоков, затем сравните карту границ с правилами компании. Руководство по обработке ответа различает распознанный текст и структуру документа. Если текст неверен, работайте с качеством входа и распознавания; если текст читается, а части перепутаны, исправляйте границы и описание классов.
Что делать с пустыми листами, приложениями и повторными сканами?
Задайте явные правила до автоматического удаления. Пустой лист может быть техническим разделителем; приложение может относиться к договору; повторный лист может содержать другую подпись. Простое сходство изображений не доказывает, что страницу можно выбросить.
Предлагаемый порядок: пометить сомнительный лист, оставить его в исходнике, показать проверяющему соседние страницы и записать решение в карту. Например, «лист 5 — оборот без содержимого, остаётся внутри договора» понятнее, чем безусловное «удалять пустые». Это правила предлагаемого рабочего процесса; они не являются встроенным поведением Google.
Как понять, что разделение завершилось успешно?
Сверьте результат с исходником, а не только с наличием новых файлов. Для учебного пакета выше должны существовать части со страницами 1–2, 3 и 4–6, если сотрудник подтвердил именно такую карту. В каждом файле порядок листов должен совпадать с оригиналом. Откройте части и убедитесь, что они читаются.
Для реального потока заранее определите, допустимы ли пропуски и повторное включение страницы. Если нет, каждая страница должна принадлежать ровно одной части. Если есть исключения, у них должна быть причина. Затем проверьте соответствие типа следующему обработчику: договор не должен уйти в извлечение реквизитов счёта. Это предложенные проверки результата, здесь они не выполнялись на реальном потоке.
Какие ограничения проверить у конкретной версии сервиса?
Проверьте тип процессора, версию модели, поддерживаемый вход, регион и ограничения выбранного режима обработки. Условия одной версии нельзя переносить на другую. В частности, документация Custom Splitter отдельно предупреждает об отсутствии поддержки data residency у указанной там версии 1.6 Release Candidate. Выбор региона проекта сам по себе не заменяет проверку этого условия.
Не начинайте с отправки всего архива. Сначала подтвердите доступ к нужному процессору и допустимость обработки выбранных данных. Общие ограничения платформы собраны на странице Document AI limits. Стоимость, доступность оплаты и качество на русском языке в этом FAQ не измерялись; статья не обещает, что зарубежное облако подойдёт конкретной российской компании.
Как AI студия Владимира Ломтева помогает с потоком документов
AI студия Владимира Ломтева может помочь связать разделение пакетов с последующей обработкой документов:
- описать типы входящих документов и правила принадлежности приложений;
- подготовить данные для компьютерного зрения и извлечения полей;
- спроектировать передачу подтверждённых частей в корпоративные системы с сохранением связи с оригиналом.
Первый шаг — выбрать один входящий поток и подготовить разрешённый к разбору обезличенный пакет вместе с ожидаемым составом документов. По нему можно обсудить границы задачи и подходящее размещение обработки. Обсудить задачу.
Что сделать с первым пакетом
Составьте карту «тип — исходные страницы — решение», подтвердите спорные границы и создайте файлы только по согласованной карте. Сохраните связь каждой части с оригиналом. Если структура предсказуема, начните с правил; если границы зависят от содержания, рассмотрите ИИ-разделитель с проверкой человеком. Главный результат — отдельные читаемые документы правильного состава, готовые к извлечению нужных полей.