ИИ-агента, который сам выполняет многошаговые задачи, уже можно запустить на одной рабочей станции внутри компании: без облачных API, без платы за токены и без серверных ускорителей. Мы проверили это на компьютере с игровой видеокартой RTX 3070 на 8 ГБ и 64 ГБ оперативной памяти. Две открытые модели — Qwen3.8-Flash-Next в движке Strata и Ternary Bonsai 2 27B — по одному короткому запросу изучили сайт-образец и сделали длинный лендинг в одном HTML-файле: первая за 11 минут, вторая за 14,5 минуты. Это не уровень лучших облачных моделей, и результат нужно проверять: одна из моделей перенесла на страницу чужие цены и проценты.
Тест провёл Владимир Ломтев, AI студия Владимира Ломтева, 17 ноября 2026 года. Разбор подготовлен 19 ноября 2026 года по журналам сессий, конфигурациям запуска и самим HTML-файлам. Статья для руководителей и инженеров, которые хотят держать ИИ в контуре компании и выбирают, на каком железе и с какой моделью начать. Здесь нет рейтинга моделей и расчёта стоимости владения: это один запуск каждой модели на одной агентной задаче.
Коротко:
- Открытая модель на одной рабочей станции с видеокартой 8 ГБ выполнила агентную задачу целиком: прочитала сайт, разобрала CSS, написала страницу из 15 секций и проверила свой код.
- Модель, файлы и запросы остаются на компьютере компании; платы за токены нет. Расходы — это железо и его эксплуатация.
- Qwen3.8-Flash-Next в Strata оказалась быстрее: 11 минут 5 секунд против 14 минут 30 секунд, 54,2 против 23,5 токена в секунду на последнем запросе. Ей нужны 64 ГБ оперативной памяти.
- Bonsai 2 весит 5,95 ГБ и целиком помещается в видеопамять — вариант для компьютеров с меньшим объёмом RAM.
- Результат такого ИИ нельзя публиковать без проверки: 39 из 41 числа на странице Bonsai скопированы с сайта-образца, а отчёт модели о своей работе разошёлся с файлом.
Содержание
- Что и на чём проверяли
- Что за модели участвовали
- Как модели выполняли задание
- Время и скорость
- Что получилось: два лендинга
- Откуда на странице взялись цифры
- Почему Bonsai оказалась медленнее
- Где граница возможностей
- Что нужно, чтобы запустить такой ИИ в контуре компании
- Какую модель выбрать для локального агента
- Как повторить тест на своих задачах
- Ограничения теста
- Частые вопросы
Что и на чём проверяли
Обе модели работали на одном компьютере: процессор AMD Ryzen 7 5700X, видеокарта NVIDIA GeForce RTX 3070 с 8 ГБ памяти (8192 МиБ), 64 ГБ оперативной памяти. Это обычная игровая или офисная рабочая станция, а не сервер с ускорителями. Именно на таком железе проверяется главный вопрос статьи: можно ли получить полезный ИИ внутри компании без больших вложений в инфраструктуру.
Задание было одним коротким сообщением в чат локального агента:
создай длинный красивый лендинг про себя в стиле https://airassvet.ru/. упакуй всё в один html
Для Bonsai формулировка отличалась на одно слово: «сделай длинный лэндинг про себя…» — без слова «красивый». Других подсказок, примеров или повторных попыток не было. Образцом выбран сайт нашей студии airassvet.ru: так мы точно знали, какие тексты и цифры на нём есть, и могли проверить, что модели взяли с него.
| Параметр | Qwen3.8-Flash-Next | Ternary Bonsai 2 27B |
|---|---|---|
| Файл модели | GSQ-RCO IQ2_XS от ISTA-DASLab, в среднем 2,50 бита на вес | PTQ1_0 от PrismML, 1,75 бита на вес |
| Объём файлов | 68,0 ГБ: 39,2 ГБ весов и 28,8 ГБ таблицы n-грамм | 5,95 ГБ |
| Движок | Strata engine 0.1.60 (CUDA) | Форк llama.cpp от PrismML, локальная сборка под CUDA 12.4 |
| Окно контекста | 262 144 токена | 262 144 токена |
| KV-кэш | q4_0, 32 768 позиций в видеопамяти | q3_0, 8192 позиции в видеопамяти, остальное в RAM |
| Черновики (спекулятивное декодирование) | включены: отдельная модель-черновик DFlash2 на 487 МиБ, окно 6 токенов | выключены |
| Рассуждения | включены, бюджет 2048 токенов | включены, бюджет 2048 токенов |
| Инструменты агента | run_shell, fetch_url, web_search | run_shell, fetch_url, web_search |
| Начало запуска | 17 ноября 2026, 17:37 МСК | 17 ноября 2026, 21:20 МСК |
Агентная обвязка одна и та же: локальный чат с инструментами, где shell работает в изолированной папке без доступа к домашнему каталогу и с лимитом 45 секунд на команду. Различаются модель, формат весов и движок.
Что за модели участвовали
Qwen3.8-Flash-Next — разреженная MoE-модель Alibaba: 125 млрд параметров, из которых на каждый токен активны около 6 млрд, плюс 51 млрд в таблице n-граммных эмбеддингов и 4 млрд в слое MTP для черновиков. В каждом из 48 слоёв 512 экспертов, на токен работают 10 из них и один общий. Это данные карточки модели на Hugging Face; лицензия — Qwen Community License 1.0, а не Apache 2.0.
Целиком такую модель в 8 ГБ не уместить. Движок Strata держит в видеопамяти внимание, общие слои и кэш самых востребованных экспертов, остальных экспертов хранит в оперативной памяти и считает на процессоре. Подробно схема разобрана в нашем обзоре Strata. Мы использовали вариант IQ2_XS из репозитория ISTA-DASLab: каждому тензору в нём подобран свой тип квантования, в среднем 2,50 бита на вес.
Ternary Bonsai 2 27B — версия плотной модели Qwen3.8-27B, сжатая компанией PrismML до тернарных весов. Тернарный вес принимает только три значения: −1, 0 или +1, а на каждую группу из 128 весов хранится один общий множитель. По карточке модели это 1,72 бита на вес в среднем против 16 у исходной версии: около 54 ГБ сжимаются до 5,8–5,95 ГБ. PrismML заявляет, что модель сохраняет 98,2% среднего результата исходной Qwen3.8-27B по 14 тестам в режиме рассуждений. Это оценка самого разработчика. Лицензия — Apache 2.0.
Формат PTQ1_0, который мы запускали, требует форка llama.cpp от PrismML: обычная сборка llama.cpp такой файл не откроет. Для стандартного llama.cpp, начиная с версии b11556, у PrismML есть вариант Q2_0 на 7,63 ГБ.
Сопоставление получилось неравным, и это нужно держать в голове. Одна модель — большая MoE: только её основные веса занимают 39,2 ГБ, и на 8 ГБ видеопамяти она работает за счёт оперативной памяти компьютера. Другая — плотная модель на 27 млрд параметров, ужатая так, что помещается в видеокарту целиком. Поэтому тест показывает, какого агента можно получить на одном и том же компьютере, а не какая архитектура лучше.
Как модели выполняли задание
Обе модели прошли один и тот же путь, хотя этого им никто не подсказывал.
- Изучили образец. Каждая модель загрузила главную страницу сайта инструментом fetch_url, затем через curl скачала HTML и подключённый CSS-файл размером 175 808 байт. Bonsai сначала попробовала несуществующий адрес
/css/style.css, получила ошибку 404 и пошла через shell. - Вытащили стиль. Обе нашли в CSS переменные темы: тёмный фон, карточки и оранжевый акцент
hsl(14 100% 63%). Qwen отдельно искала шрифты и анимации, Bonsai — частые классы разметки и текст первого экрана. - Писали файл частями. Обе модели записывали HTML несколькими командами shell: Qwen собрала страницу из семи частей, а Bonsai — из одиннадцати фрагментов, дописывая их в конец файла.
- Проверили результат. Qwen проверила баланс тегов, синтаксис скрипта через
node --check, нашла ссылку меню на несуществующий разделlevelsи добавила недостающий якорь. Bonsai проверила файл HTML-парсером, исправила разметку в одном из ответов FAQ и добавила пропущенныйidдля раздела «ИИ для вашей отрасли». - Отчитались. Обе описали структуру страницы и выполненные проверки.
Всего Qwen сделала 26 вызовов инструментов (25 команд shell и одно чтение страницы), Bonsai — 32 (30 команд и два чтения). Ни одна из моделей не зациклилась, не потеряла файл и не попросила помощи. Для агентной задачи на 15 минут это главный практический результат: обе модели довели многошаговую работу до конца.
Время и скорость
Агент записывает время по этапам задачи. Ниже данные из журналов сессий; доли посчитаны из них.
| Показатель | Qwen3.8-Flash-Next в Strata | Bonsai 2 27B |
|---|---|---|
| Общее время задачи | 665,4 с (11 мин 5 с) | 870,3 с (14 мин 30 с) |
| Генерация вызовов инструментов, то есть написание кода страницы | 447,8 с (67%) | 639,1 с (73%) |
| Рассуждения | 79,8 с | 133,6 с |
| Чтение контекста (prefill) | 104,4 с | 40,1 с |
| Выполнение инструментов | 17,2 с | 20,9 с |
| Итоговый ответ | 14,9 с | 32,6 с |
| Скорость генерации на последнем запросе | 54,2 токена/с | 23,5 токена/с |
| Скорость чтения контекста на последнем запросе | 257,6 токена/с | 224,0 токена/с |
| Контекст к концу задачи | 43 750 токенов | 42 769 токенов |
Больше всего времени у обеих моделей ушло на то, чтобы написать сам HTML: весь код страницы проходит через генерацию модели. Поэтому общее время определяется прежде всего скоростью генерации.
Qwen медленнее читала контекст: на этап prefill ушло 104 секунды против 40. Зато она в 2,3 раза быстрее писала, и на длинной задаче это решило исход. Разница в общем времени — 1,31 раза в пользу Qwen.
Скорости генерации из таблицы измерены на одном последнем запросе к модели, а не усреднены по всей задаче. Для оценки общей картины надёжнее смотреть на время этапов.
Что получилось: два лендинга
Обе страницы открываются без интернета: стили и скрипты встроены, внешних шрифтов и библиотек нет. По объёму они близки, по устройству — разные.
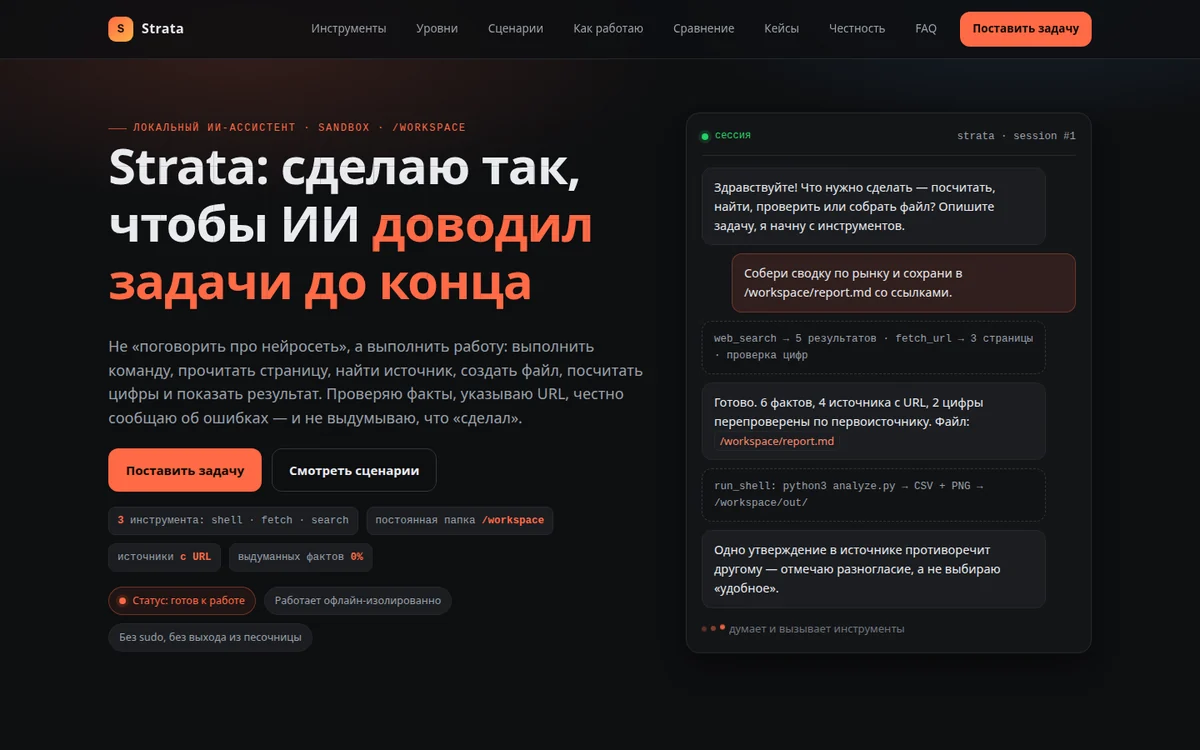
Qwen назвала страницу по движку — «Strata» — и построила её вокруг того, что агент действительно умеет: три инструмента, рабочая папка, лимит 45 секунд на команду, запрет удалять файлы без просьбы. На первом экране — макет чата с цепочкой вызовов web_search и fetch_url.

Bonsai сделала страницу, которая по структуре повторяет сайт-образец: услуги, отрасли, таблица «было — стало», цены, достижения, города присутствия. Формулу заголовка обе модели взяли с главной страницы образца — «Сделаем так, чтобы ИИ приносил деньги». Bonsai заменила только последнее слово и дописала «а не просто болтал», Qwen — «доводил задачи до конца».
| Характеристика | Лендинг Qwen (Strata) | Лендинг Bonsai |
|---|---|---|
| Размер файла | 76 084 байта | 68 018 байт |
| Видимый текст | около 3000 слов | около 2200 слов |
| Секций / заголовков H2 | 15 / 13 | 15 / 14 |
| Вопросов в FAQ | 21 | 20 (в отчёте модели — 23) |
| Таблиц | 3 | 3 |
| Медиазапросов для мобильных | 5 | 10 |
| Объём JavaScript | 4952 символа: счётчики, вкладки, аккордеон, генератор брифа | 1011 символов: аккордеон, плавная прокрутка, анимация появления |
| Форма | генератор брифа, работает только в браузере | кнопка «Отправить заявку» без формы |
| О ком страница | об агенте и его инструментах | о «Bonsai» с услугами и показателями студии-образца |
Страница Qwen богаче интерактивом: вкладки сценариев, растущая линия шагов, генератор текста задачи. Страница Bonsai проще по коду, но лучше подготовлена к мобильным экранам — у неё вдвое больше медиазапросов. Оценку вёрстки на телефоне мы не проводили.
Откуда на странице взялись цифры
Здесь модели разошлись сильнее всего. Мы выписали из видимого текста обеих страниц все проценты, суммы в рублях и сроки и сверили их с главной страницей airassvet.ru, загруженной 19 ноября 2026 года.
На странице Bonsai нашлось 41 такое значение. 39 из них дословно встречаются на главной странице образца: «+35% конверсия», «от 300 000 ₽», «30+ успешных проектов», «90% клиентов возвращается», «30 дней на бесплатное исправление ошибок». Это формулировки студии о собственной работе. Модель не выдумала эти числа, а перенесла их на свою страницу и подала от первого лица, как свои достижения. У языковой модели не может быть «30+ проектов» и «15 экспертов в команде». Если бы такой лендинг выпустили для реального продукта, он содержал бы чужие цены и неподтверждённые обещания.
На странице Qwen числовых обещаний почти нет. Счётчики под первым экраном показывают правила работы: три инструмента, 45 секунд на команду, ноль удалений без запроса. Под ними модель сама написала, что числа «отражают правила работы ассистента, а не маркетинговые обещания». Значение «+240%», которое есть на сайте-образце, Qwen использовала только как пример цифры из чужого текста, которую нужно сверить с первоисточником.
Не обошлась без натяжек и Qwen. На первом экране её страницы есть плашка «выдуманных фактов 0%». Это обещание, которое модель гарантировать не может, и его тоже пришлось бы убрать перед публикацией.
Вторая находка касается отчётов. В итоговом сообщении Bonsai написала, что в FAQ «23 вопроса». В файле их 20. Qwen написала «21 вопрос», и это совпадает с файлом. Расхождение небольшое, но показательное: сообщение агента «готово, проверил» — не доказательство. Проверять нужно сам артефакт.
Почему Bonsai оказалась медленнее
Bonsai целиком лежит в видеопамяти, а Qwen постоянно обращается к экспертам в оперативной памяти. Казалось бы, маленькая модель должна быть быстрее. На этой машине вышло наоборот, и у этого есть объяснения.
Первое — формат весов на этой видеокарте. В разделе ограничений карточки Bonsai PrismML пишет, что распаковка плотно упакованных тернарных весов PTQ1_0 требует дополнительных вычислений: на картах класса Ada такой формат быстрее, а на Ampere, Hopper и Blackwell медленнее. RTX 3070 относится к поколению Ampere. По таблице того же разработчика на A100 (тоже Ampere) PTQ1_0 выдаёт 54,7 токена в секунду, а вариант PQ2_0 — 73,9. Файл PQ2_0 весит 7,21 ГБ, и в 8 ГБ вместе с контекстом он уже не помещается.
Второе — черновики. Strata в нашем запуске использовала спекулятивное декодирование: маленькая модель-черновик DFlash2 предлагает сразу несколько следующих токенов, а основная модель проверяет их за один проход. У Bonsai этот режим был выключен. Мы не измеряли вклад каждого фактора отдельно, поэтому это объяснение, а не доказанная причина.
Для сравнения есть независимый тест на более мощной карте. Автор InsiderLLM на RTX 3090 получил для Bonsai 2 в формате PQ2_0 скорость 77,62 токена в секунду против 42,13 у исходной Qwen3.8-27B в 4-битном кванте UD-Q4_K_XL. На его наборе из 47 задач выбора инструмента Bonsai ответила правильно на 12, а 4-битная Qwen3.8-27B — на 19. Так что на подходящем железе тернарная модель быстрее своей основы в 4-битном кванте, но цена сжатия видна на задачах, где важна точность.
Где граница возможностей
Владимир Ломтев, проводивший тест, написал о результате в своём блоге 17 ноября:
Qwen 3.8 Flash Next вполне себе несложные агентные сценарии тянет. Конечно, это не Opus 5.5 и тем более не GPT-6.1-Sol, но это интеллект, который компания может себе позволить недорого и локально.
Сам тест подтверждает первую часть этой оценки. Задача из 26–32 вызовов инструментов с чтением сайта, разбором CSS, записью файла и самопроверкой выполнена без вмешательства человека. Для внутренних задач компании этого уровня часто достаточно: собрать черновик страницы или отчёта, разобрать выгрузку, подготовить документ по шаблону.
Граница проходит по ответственности за содержание. Модель выполняет поручение буквально и копирует то, что видит в образце, если в задании не сказано обратного. Эту проблему не решает ни размер модели, ни скорость: её закрывают постановка задачи и проверка результата человеком или отдельным скриптом.
Вторая граница — скорость. 11–15 минут на одну страницу приемлемы для фоновой работы агента, но не для живого диалога с клиентом. И обе конфигурации обслуживают один запрос за раз: это рабочее место одного сотрудника, а не сервер для отдела.
Что нужно, чтобы запустить такой ИИ в контуре компании
«В контуре компании» здесь значит, что модель работает на компьютере организации, а запросы, файлы и результаты не уходят во внешний сервис. Для конфигураций из нашего теста нужно следующее.
| Что | Qwen3.8-Flash-Next в Strata | Ternary Bonsai 2 27B |
|---|---|---|
| Видеокарта | NVIDIA с 8 ГБ памяти (в тесте RTX 3070) | NVIDIA с 8 ГБ памяти (в тесте RTX 3070) |
| Оперативная память | 64 ГБ в тесте; основные веса занимают 39,2 ГБ | файл модели 5,95 ГБ помещается в видеопамять; RAM нужна под часть KV-кэша |
| Место на диске | 68 ГБ под файлы модели | 5,95 ГБ |
| Движок | Strata, открытый код под лицензией MIT | форк llama.cpp от PrismML |
| Лицензия весов | Qwen Community License 1.0 — условия нужно проверить | Apache 2.0 |
| Плата за использование | нет, модель работает на своём компьютере | нет, модель работает на своём компьютере |
Почему это недорого. Не нужны серверные ускорители и подписка на облачный API: модель запускается на рабочей станции того класса, который есть во многих компаниях, а каждый запрос ничего не стоит сверх электричества и износа железа. Конкретные цены мы не приводим — они зависят от того, есть ли подходящий компьютер. Как сравнить затраты на свою модель и облако, разобрано в статье облачная или локальная LLM: как сравнить TCO.
Что остаётся в контуре. В нашем тесте агенту был открыт интернет, потому что задача требовала прочитать сайт-образец. Для работы с внутренними документами агенту можно не давать доступ в сеть: чтение страниц и поиск отключаются в настройках агента, а сама модель считает на локальном компьютере. Как устроить работу полностью без интернета, описано в разборе LLM в закрытом контуре.
Где предел. Такая станция обслуживает один запрос за раз. Это ИИ-помощник для одного сотрудника или фоновых задач, а не сервис для всего отдела: для нескольких пользователей нужен сервер с vLLM или SGLang.
Какую модель выбрать для локального агента
| Ситуация | Что выбрать | Почему |
|---|---|---|
| На компьютере 64 ГБ RAM и больше, видеокарта NVIDIA от 8 ГБ, нужен агент для одного сотрудника | Qwen3.8-Flash-Next в Strata | В нашем тесте быстрее и аккуратнее с содержанием |
| Оперативной памяти 16–32 ГБ, видеокарта 8 ГБ | Ternary Bonsai 2 27B | Модель помещается в видеопамять целиком; основным весам Qwen3.8-Flash-Next в IQ2_XS на 39,2 ГБ здесь не хватит места |
| Карта поколения Ada (RTX 40) или ноутбук на Apple Silicon | Bonsai 2 | По таблице PrismML, на RTX 4090 Bonsai 2 выдаёт 81–91 токен/с, а на ноутбуке с Apple M5 Pro — 28 токенов/с |
| Нужна лицензия Apache 2.0 без особых условий | Bonsai 2 или исходная Qwen3.8-27B | У Qwen3.8-Flash-Next собственная лицензия Qwen Community License 1.0 |
| Несколько пользователей одновременно | ни одна из этих конфигураций | Нужен сервер с vLLM или SGLang — см. выбор модели для локального инференса |
| Текст уйдёт клиентам без правки | ни одна модель без проверки | Обе страницы содержали утверждения, которые нужно было убрать |
Если сомневаетесь, сколько памяти потребует конкретный вариант, посчитайте по нашему разбору сколько VRAM нужно для LLM. Что означают обозначения IQ2_XS, Q2_0 и другие, объясняет статья о квантовании LLM на практике.
Как повторить тест на своих задачах
Этот порядок подходит для любой пары локальных моделей и любой агентной задачи.
- Зафиксируйте железо и конфигурацию. Запишите процессор, видеокарту, объём RAM, файл модели, движок с версией, размер окна, тип KV-кэша и режим черновиков.
- Возьмите одну обвязку. Агент, инструменты, лимиты и бюджет рассуждений должны совпадать. Иначе вы сравните обвязки, а не модели.
- Дайте одинаковое задание. Одно сообщение, без подсказок по ходу. Сохраните его дословно.
- Сохраните журналы. Время по этапам, число вызовов инструментов, скорость чтения и генерации, размер контекста.
- Проверьте результат механически. Откройте файл в браузере, посчитайте секции и вопросы, проверьте якоря и синтаксис скриптов. Сверьте отчёт агента с файлом.
- Проверьте содержание. Выпишите все числа, цены, сроки и обещания и найдите источник каждого. Отдельно отметьте то, что скопировано из образца.
- Повторите. Один запуск показывает, что модель справляется в принципе. Чтобы оценить стабильность, сделайте несколько запусков на одной задаче, например три.
Чек-лист для проверки страницы, которую сделал агент:
- в тексте нет чужих цен, процентов, сроков и названий клиентов;
- каждое число на странице можно подтвердить;
- нет обещаний вроде «0% ошибок» и «гарантия результата»;
- все пункты меню ведут на существующие разделы;
- форма заявки либо работает, либо её нет;
- страница открывается на телефоне без горизонтальной прокрутки.
Ограничения теста
- Один запуск на модель. Мы не повторяли задание, поэтому не знаем, как сильно результат меняется от запуска к запуску.
- Одна задача. Генерация лендинга проверяет агентный цикл и вёрстку, но не работу с документами, точными расчётами или длинным контекстом.
- Неодинаковый формат весов. Qwen работала в 2,5-битном варианте, Bonsai — в тернарном. Полноразмерные версии этих моделей могут вести себя иначе.
- Разные движки. Strata и форк llama.cpp от PrismML используют разные ядра и настройки, поэтому скорость отражает связку «модель + движок + видеокарта».
- Разница в одном слове задания. Для Qwen задание содержало слово «красивый», для Bonsai — нет. На вывод о копировании цифр это вряд ли влияет, но мы фиксируем расхождение.
- Качество вёрстки не оценивалось людьми. Мы проверили структуру, код и содержание, но не проводили опрос читателей и не проверяли страницы на телефонах.
- Скорость генерации снята с последнего запроса. Общее время задачи надёжнее этого показателя.
Частые вопросы
Можно ли запустить ИИ в контуре компании без сервера и облака? Да, для одного пользователя. В нашем тесте рабочая станция с RTX 3070 8 ГБ и 64 ГБ оперативной памяти выполнила агентную задачу из 26–32 вызовов инструментов за 11–15 минут. Для нескольких одновременных пользователей нужен сервер.
Можно ли запустить Qwen3.8-Flash-Next на видеокарте с 8 ГБ? Да, через Strata. В нашем тесте модель работала на RTX 3070 8 ГБ с окном 262 144 токена на компьютере с 64 ГБ оперативной памяти. Основные веса варианта IQ2_XS занимают 39,2 ГБ, а все файлы модели — 68 ГБ на диске.
Сколько памяти нужно для Bonsai 2 27B? Файл PTQ1_0 весит 5,95 ГБ и помещается в 8 ГБ видеопамяти вместе с частью контекста. Остальной KV-кэш при длинном окне можно держать в оперативной памяти.
Можно ли публиковать лендинг, который сделала локальная модель? Как черновик — да. Публиковать без проверки нельзя: в нашем тесте одна модель перенесла на страницу чужие цены и показатели, другая добавила обещание «0% выдуманных фактов».
Почему тернарная модель оказалась медленнее большой MoE? На видеокартах поколения Ampere распаковка формата PTQ1_0 требует лишних вычислений, а у Strata была включена модель-черновик DFlash2. На RTX 3090 независимый тест показал, что Bonsai 2 в формате PQ2_0 быстрее 4-битной Qwen3.8-27B в 1,84 раза.
Подойдут ли эти модели для агента, который работает с клиентами? Для фоновых задач одного сотрудника — да. Для общения с клиентами в реальном времени 11–15 минут на задачу слишком долго, а одна видеокарта обслуживает только один запрос одновременно.
Чем Bonsai 2 отличается от обычного 2-битного кванта? Веса изначально приводятся к трём значениям −1, 0 и +1 с общим множителем на группу из 128 весов. По данным PrismML, при размере около 82% от стандартного кванта IQ2_XXS такая модель набирает 84,78 балла в среднем по 14 тестам против 72,59 у IQ2_XXS.
Как AI студия Владимира Ломтева помогает запустить ИИ в контуре компании
Тест показывает, что открытая модель на обычной рабочей станции уже выполняет многошаговые задачи, но её нужно правильно подобрать под железо и встроить в процесс с проверкой результата. AI студия Владимира Ломтева разворачивает открытые LLM в контуре компании, в том числе на собственном оборудовании заказчика, и строит на них ИИ-агентов.
Для такой задачи мы:
- подбираем модель, формат весов и движок под имеющееся железо и вашу задачу, а затем проверяем их на ваших примерах;
- разворачиваем модель локально и подключаем агента к нужным инструментам и системам в изолированной среде;
- проводим тест на ваших данных с проверкой результата: откуда взялись числа, совпадает ли отчёт агента с файлом, где нужна правка человека.
Первый шаг — выбрать один процесс, который хотите поручить агенту, описать, как он выполняется сейчас, какие данные в нём участвуют, какие есть ограничения и по какому признаку вы примете результат.
Итог
ИИ, который выполняет многошаговые задачи, больше не требует облака или сервера с дорогими ускорителями. На рабочей станции с RTX 3070 8 ГБ и 64 ГБ оперативной памяти Qwen3.8-Flash-Next в Strata за 11 минут сама изучила сайт, написала страницу на 76 КБ и проверила свой код; Bonsai 2 27B справилась за 14,5 минуты и помещается даже в 8 ГБ видеопамяти. Модель, данные и результаты при этом остаются в контуре компании, а платы за токены нет.
Цена такого решения — скорость и ответственность за проверку. Это помощник для одного сотрудника и фоновых задач, а его результат нужно сверять так же, как работу нового сотрудника. Начните с одного процесса и вашего железа: повторите тест по описанному порядку и проверьте не только скорость, но и происхождение каждого числа в результате.