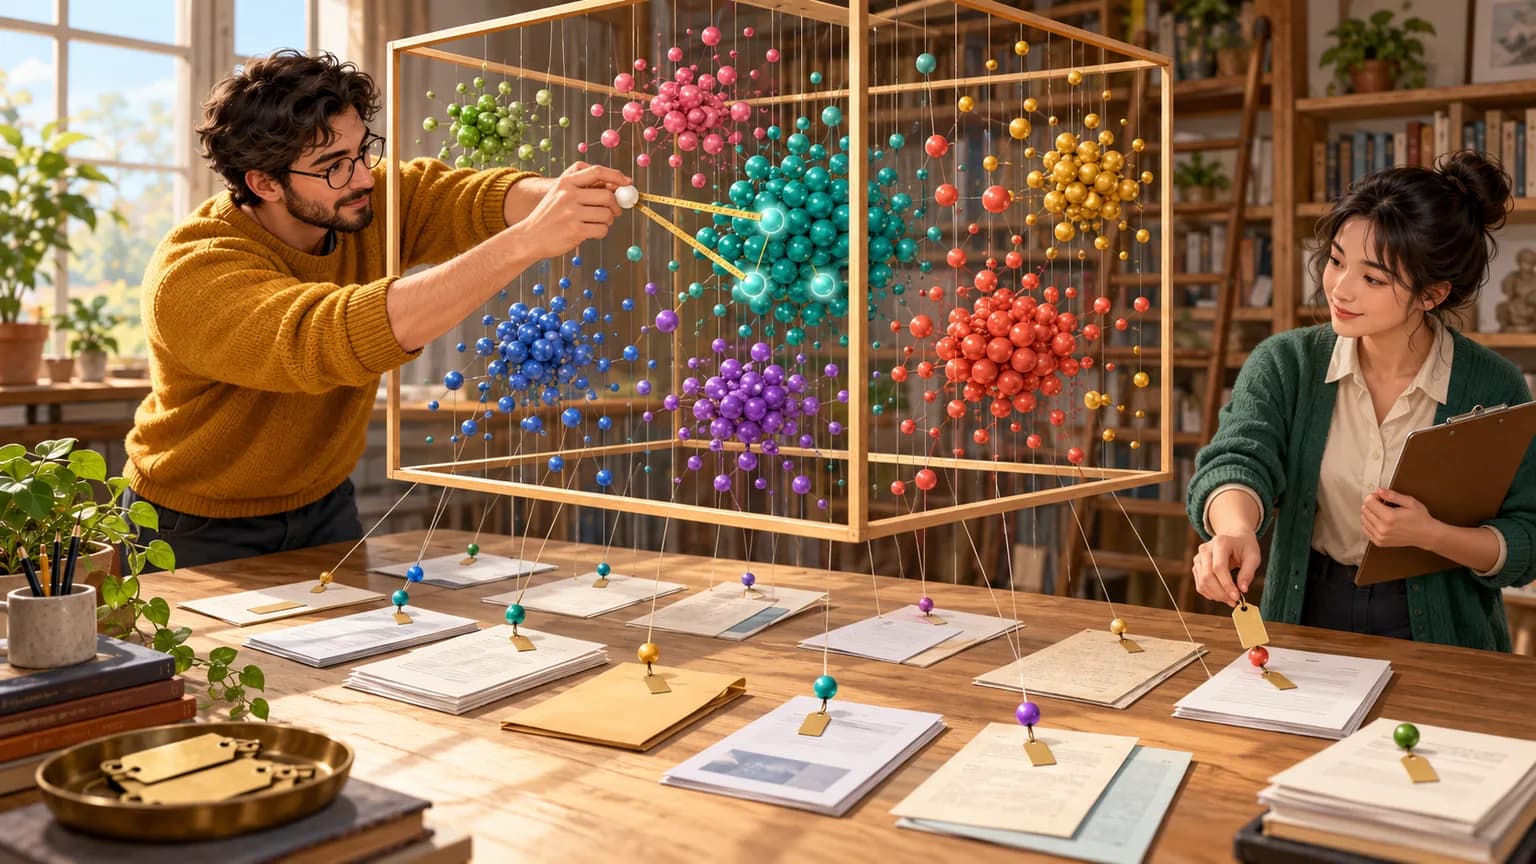
Векторная база данных — это хранилище, которое держит тексты, изображения и другие объекты в виде векторов (наборов чисел, описывающих смысл) и умеет быстро находить среди них самые похожие на запрос. Благодаря ей ИИ-ассистент находит нужный пункт регламента, даже если сотрудник сформулировал вопрос другими словами. Это основа RAG-систем, поиска по смыслу и рекомендаций. При этом векторная база не «понимает» документы сама: качество поиска определяют модель эмбеддингов, нарезка документов, фильтры по правам доступа и настройки индекса.
Материал подготовлен AIrassvet 19 октября 2026 года для руководителей, владельцев продуктов и ИТ-менеджеров, которые слышат про «векторный поиск» в проектах с ИИ и хотят понимать, что за ним стоит. Объяснение опирается на документацию OpenAI, pgvector и Qdrant и на научные работы о HNSW, библиотеке Faiss, RAG и восстановлении текста по эмбеддингам. Собственных замеров скорости и качества для этой статьи мы не проводили.
Содержание
- Кратко
- Определение и границы статьи
- Что такое эмбеддинг
- Как работает векторный поиск: пять шагов
- Точный и приближённый поиск: индексы HNSW и IVFFlat
- Фильтры, метаданные и права доступа
- Гибридный поиск: смысл плюс точные слова
- Где векторная база применяется в бизнесе
- Отдельная векторная СУБД или PostgreSQL с pgvector
- Ограничения и риски
- Глоссарий
- Частые вопросы
- Первоисточники
Кратко
- Векторная база ищет по смыслу, а не по совпадению слов. Каждый объект превращается в вектор, и близость векторов означает близость смысла.
- Векторы создаёт отдельная модель эмбеддингов. Например, у OpenAI модель text-embedding-3-small выдаёт векторы из 1536 чисел, text-embedding-3-large — из 3072.
- Для скорости используют приближённый поиск. Индексы вроде HNSW жертвуют небольшой долей точности ради скорости; pgvector по умолчанию ищет точно, но медленнее.
- Фильтры по правам доступа нужно проектировать отдельно. При приближённом поиске фильтр может вернуть меньше результатов, чем запрошено.
- Эмбеддинги — это не обезличивание. Исследование 2023 года восстановило 92% коротких текстов по их векторам точно.
Определение и границы статьи
Векторная база данных хранит векторы вместе с исходными объектами и их метаданными и отвечает на вопрос «какие записи ближе всего к этому вектору». Обычная база отвечает на вопросы вида «найди договоры с номером 145» — она сравнивает значения точно. Векторная отвечает на «найди документы о том же, о чём этот вопрос», даже если общих слов в них нет.
«Векторной базой» называют и специализированные системы (Qdrant, Milvus, Weaviate), и расширения к привычным СУБД, например pgvector для PostgreSQL, и библиотеки поиска вроде Faiss, которые встраивают в приложение. Принцип у них один, отличаются удобство эксплуатации, фильтры и масштаб.
Эта статья объясняет, как устроена векторная база и где она полезна. Мы не сравниваем конкретные продукты по скорости, не приводим бенчмарков и не разбираем архитектуру RAG целиком — ей посвящён материал «RAG-система для бизнеса».
Что такое эмбеддинг
Эмбеддинг — это вектор, то есть список чисел, которым модель описывает смысл текста, изображения или другого объекта. Документация OpenAI формулирует это так: эмбеддинг — вектор из чисел с плавающей точкой, а расстояние между двумя векторами измеряет их связанность — чем меньше расстояние, тем сильнее связь.
Проще всего представить карту, на которой похожие по смыслу фразы лежат рядом. «Как оформить отпуск» и «порядок предоставления ежегодного отпуска» окажутся соседями, хотя слова у них разные. Только измерений у этой карты не два, а сотни или тысячи: у text-embedding-3-small их 1536, у text-embedding-3-large — 3072.
Из этого следуют два практических вывода. Во-первых, векторы разных моделей несовместимы: сравнивать можно только векторы, созданные одной и той же моделью. Во-вторых, качество поиска сильно зависит от модели эмбеддингов и от того, насколько хорошо она понимает язык и терминологию компании.
Как работает векторный поиск: пять шагов
- Нарезка. Документы делят на фрагменты — абзацы, разделы, карточки. Слишком крупный фрагмент размывает смысл, слишком мелкий теряет контекст.
- Векторизация. Модель эмбеддингов превращает каждый фрагмент в вектор. Вместе с вектором сохраняют текст фрагмента и метаданные: источник, дату, отдел, уровень доступа.
- Индексация. База строит индекс, который позволяет не сравнивать запрос с каждым вектором подряд.
- Запрос. Вопрос пользователя векторизуется той же моделью, и база ищет ближайшие векторы — обычно по косинусной близости, которую рекомендует, например, OpenAI.
- Использование результата. Найденные фрагменты показывают пользователю как результаты поиска или передают языковой модели, чтобы она ответила с опорой на них. Второй вариант и есть RAG: в исходной работе Lewis и соавторов (2020) модель обращалась к плотному векторному индексу Википедии через нейросетевой поиск.
Между шагами 4 и 5 часто добавляют переранжирование — второй, более точный проход по найденным кандидатам. Когда оно окупается, мы разбирали в статье «Реранкер в RAG».
Точный и приближённый поиск: индексы HNSW и IVFFlat
Найти ближайших соседей можно точно — сравнив запрос с каждым вектором. Так pgvector работает по умолчанию: в документации сказано, что точный поиск даёт идеальную полноту (perfect recall). Но на миллионах векторов полный перебор становится медленным, поэтому используют индексы приближённого поиска (ANN, approximate nearest neighbor). Они находят почти всех ближайших соседей гораздо быстрее, жертвуя небольшой долей полноты.
Самый распространённый подход — HNSW (Hierarchical Navigable Small World), описанный Ю. Малковым и Д. Яшуниным в 2016–2018 годах. Векторы связываются в многоуровневый граф: поиск начинается на разреженных верхних уровнях и спускается к плотным, а авторы заявляют логарифмическое масштабирование сложности. Второй распространённый тип — IVFFlat: векторы заранее делятся на группы, и поиск идёт только по ближайшим группам.
| Параметр | Точный поиск | HNSW | IVFFlat |
|---|---|---|---|
| Полнота результатов | Полная | Почти полная, настраивается | Почти полная, настраивается |
| Скорость запроса на больших объёмах | Низкая | Высокая | Средняя |
| Время построения индекса | Не нужен | Дольше | Быстрее |
| Память | Минимальная | Больше | Меньше |
| Когда выбирать | Небольшие базы, эталонная проверка | Основной вариант для быстрых ответов | Ограничена память, частая перестройка |
*Соотношения в таблице приведены по документации pgvector; конкретные цифры зависят от данных и настроек и в этой статье не измерялись.*
У pgvector есть и практическое ограничение: индексировать можно векторы типа vector размерностью до 2000, типа halfvec — до 4000. Это значит, что для 3072-мерных векторов text-embedding-3-large в pgvector понадобится половинная точность или уменьшение размерности.
Фильтры, метаданные и права доступа
В бизнесе почти никогда не нужен «поиск по всему». Сотруднику продаж нельзя показывать документы HR, а ответ про тарифы должен опираться на действующий прайс, а не на прошлогодний. Для этого к каждому вектору привязывают метаданные — в Qdrant они называются payload и хранятся как произвольный JSON — и фильтруют по ним при поиске. Документация Qdrant объясняет, зачем это нужно: не все свойства объекта можно выразить в эмбеддинге.
Здесь есть подводный камень. Документация pgvector предупреждает, что при приближённом поиске фильтр применяется после сканирования индекса. Пример оттуда: если условию соответствуют 10% строк, а параметр hnsw.ef_search равен 40 (значение по умолчанию), то в среднем вернутся около 4 подходящих строк. Для этого в pgvector 0.8.0 появились итеративные сканирования индекса, а специализированные базы предлагают свои механизмы фильтрации. Проверять поведение фильтров нужно на своих данных до запуска.
Права доступа надёжнее применять до или во время поиска, а не после генерации ответа: если фрагмент чужого отдела уже попал в контекст модели, он может «просочиться» в ответ.
Гибридный поиск: смысл плюс точные слова
Векторный поиск хорошо находит перефразированные вопросы, но может промахнуться по точным значениям: артикулам, номерам договоров, редким фамилиям, кодам ошибок. Классический полнотекстовый поиск, наоборот, точен в словах и слеп к смыслу. Поэтому часто используют гибридный поиск: запускают оба и объединяют результаты.
Qdrant описывает такой подход как сочетание плотных векторов (смысл) и разреженных (точные слова), а для объединения списков предлагает метод RRF (Reciprocal Rank Fusion). Он поднимает документы, которые оказались близко к началу в нескольких списках сразу. Как это выглядит на примере поиска по каталогу, мы разбирали в статье «Умный поиск для интернет-магазина».
Где векторная база применяется в бизнесе
- Ассистент по документам компании (RAG). Регламенты, договоры, инструкции и база знаний поддержки становятся источником ответов для ИИ-ассистента — подробнее в материале о корпоративной базе знаний с ИИ-агентом.
- Поиск по смыслу в каталоге. Покупатель пишет «куртка, чтобы не продувало», а находит ветрозащитные модели.
- Похожие обращения и дубликаты. Новое обращение в поддержку сравнивается с уже решёнными, чтобы подсказать оператору готовое решение или найти повторы.
- Рекомендации. Товары, статьи или курсы, близкие по смыслу к тем, что человек уже смотрел.
- Классификация и маршрутизация. Обращение относят к категории, к которой ближе всего его вектор, — без отдельного обучения классификатора на старте.
- Поиск по изображениям. При мультимодальных эмбеддингах можно искать похожие фото товаров, чертежи или дефекты.
Во всех случаях векторная база — инфраструктурный слой. Эффект для бизнеса зависит от того, как измеряют качество поиска; способы мы описывали в статье «Точность RAG и галлюцинации».
Отдельная векторная СУБД или PostgreSQL с pgvector
| Ситуация | Что обычно разумнее | Почему |
|---|---|---|
| Данные уже в PostgreSQL, объём умеренный | pgvector | Одна база, привычные транзакции, резервное копирование и права |
| Нужны сложные фильтры, гибридный поиск, отдельное масштабирование | Специализированная векторная СУБД | Встроенные механизмы фильтрации и объединения результатов |
| Поиск встроен в приложение, данные статичны | Библиотека вроде Faiss | Нет отдельного сервера, полный контроль над индексом |
| Пилот на небольшой базе знаний | Самый простой вариант из уже используемых | Важнее проверить качество ответов, чем выбрать «лучшую» базу |
*Таблица — методика редакции, обобщающая документацию pgvector, Qdrant и статью о Faiss; бенчмарков мы не проводили.*
Решение почти всегда упирается не в скорость, а в эксплуатацию: кто будет обновлять индекс при изменении документов, как переносить права доступа из исходных систем и как переиндексировать данные при смене модели эмбеддингов.
Ограничения и риски
- Смена модели эмбеддингов означает переиндексацию. Векторы разных моделей несравнимы, поэтому при переходе на новую модель всю базу нужно векторизовать заново. Храните исходные фрагменты, а не только векторы.
- Устаревшие данные. База знает только то, что в неё загрузили. Без регулярного обновления ассистент будет уверенно цитировать отменённый регламент.
- Точные значения. Номера, артикулы и коды чисто векторный поиск может пропустить — нужен гибридный поиск или фильтры.
- Эмбеддинги не обезличивают данные. Morris и соавторы (2023) восстановили около 92% текстов длиной 32 токена точно по их эмбеддингам, а на медицинских записях — полные имена пациентов. Векторы с персональными данными защищайте так же, как исходные тексты.
- Нет гарантии правильного ответа. Векторная база находит похожее, а не верное. Если в документах ответа нет, она всё равно вернёт ближайшее — и модель может построить на нём неточный ответ.
Глоссарий
- Вектор — упорядоченный набор чисел; в векторной базе описывает смысл объекта.
- Эмбеддинг — вектор, полученный моделью из текста, изображения или другого объекта.
- Размерность — количество чисел в векторе, например 1536.
- Косинусная близость — мера похожести двух векторов по углу между ними.
- ANN (approximate nearest neighbor) — приближённый поиск ближайших соседей.
- HNSW — индекс на основе многоуровневого графа для быстрого приближённого поиска.
- IVFFlat — индекс, который делит векторы на группы и ищет по ближайшим группам.
- Полнота (recall) — доля действительно ближайших объектов, которые нашёл поиск.
- Метаданные (payload) — дополнительные поля записи: источник, дата, права доступа.
- Гибридный поиск — объединение векторного и полнотекстового поиска.
- RRF — метод объединения нескольких списков результатов по позициям.
- RAG — подход, при котором языковая модель отвечает с опорой на найденные фрагменты документов.
Частые вопросы
Векторная база данных и RAG — это одно и то же?
Нет. RAG — это подход, при котором языковая модель отвечает с опорой на найденные документы. Векторная база — один из способов эти документы найти. RAG может использовать и полнотекстовый поиск, а векторная база применяется не только в RAG, но и в поиске по каталогу, рекомендациях и поиске дубликатов.
Нужна ли векторная база, если документов немного?
Не обязательно отдельная. Для небольшой базы знаний хватит точного поиска в pgvector или библиотеки в приложении, а иногда — простого полнотекстового поиска. Отдельная векторная СУБД оправдана, когда растут объём, требования к фильтрам и скорости или нужен гибридный поиск.
Можно ли хранить в векторной базе персональные данные?
Можно, но защищать их нужно как исходные данные. Исследование Morris и соавторов (2023) показало, что текст можно в значительной степени восстановить по эмбеддингу. Значит, на векторы распространяются те же требования к доступу, хранению и месту обработки, что и на документы, из которых они получены.
Что будет, если сменить модель эмбеддингов?
Придётся заново векторизовать все документы и перестроить индекс: векторы разных моделей несовместимы. Поэтому храните исходные фрагменты и метаданные рядом с векторами и заранее проверяйте новую модель на наборе реальных запросов, прежде чем переводить на неё всю базу.
Почему векторный поиск не находит номер договора?
Потому что он ищет по смыслу, а номер — это точное значение без смысловой нагрузки. Для таких запросов добавляют полнотекстовый поиск или фильтр по полю метаданных, а результаты объединяют, например методом RRF. Такой гибридный подход описан в документации Qdrant.
Первоисточники
Документы и статьи проверены 19 октября 2026 года:
- OpenAI: Vector embeddings — определение эмбеддинга, размерности, косинусная близость.
- pgvector на GitHub — точный поиск по умолчанию, HNSW и IVFFlat, ограничения размерности, фильтрация.
- Malkov, Yashunin. HNSW, 2016–2018 — алгоритм многоуровневого графа.
- Douze et al. The Faiss library, 2024 — библиотека векторного поиска.
- Qdrant: Filtering и Qdrant: Hybrid queries — метаданные, гибридный поиск, RRF.
- Lewis et al. Retrieval-Augmented Generation, 2020 — исходная работа о RAG.
- Morris et al. Text Embeddings Reveal (Almost) As Much As Text, 2023 — восстановление текста по эмбеддингам.
Цифры приведены по данным авторов и разработчиков, мы их не перепроверяли.
Как AIrassvet помогает внедрить векторный поиск
Векторная база приносит пользу, когда понятно, какие вопросы она должна закрывать, из каких источников и для кого. На сайте AIrassvet указаны направления, которые относятся к этой задаче:
- RAG-системы на базе знаний компании: подготовка и нарезка документов, векторизация, поиск с фильтрами по правам доступа;
- развёртывание языковых моделей на серверах заказчика, если документы и их векторы нельзя передавать во внешний сервис;
- аудит процесса, подготовка данных и тестирование качества поиска на реальных вопросах сотрудников или клиентов.
Первый шаг — выбрать один процесс, где люди тратят время на поиск информации, описать текущий результат, источники документов, ограничения доступа и критерий, по которому поиск будет считаться удачным.
Итог: векторная база — это поиск по смыслу, а не готовый ответ
Векторная база данных хранит объекты как векторы и быстро находит похожие по смыслу — поэтому на ней строятся RAG-ассистенты, поиск по каталогу и рекомендации. Но её качество определяется не самой базой, а моделью эмбеддингов, подготовкой документов, фильтрами по правам и регулярным обновлением.
Если вы планируете проект с векторным поиском, начните с набора реальных вопросов и проверки на нём, а выбор между pgvector и отдельной СУБД делайте по требованиям к эксплуатации. И помните, что векторы с персональными данными требуют той же защиты, что и сами документы.