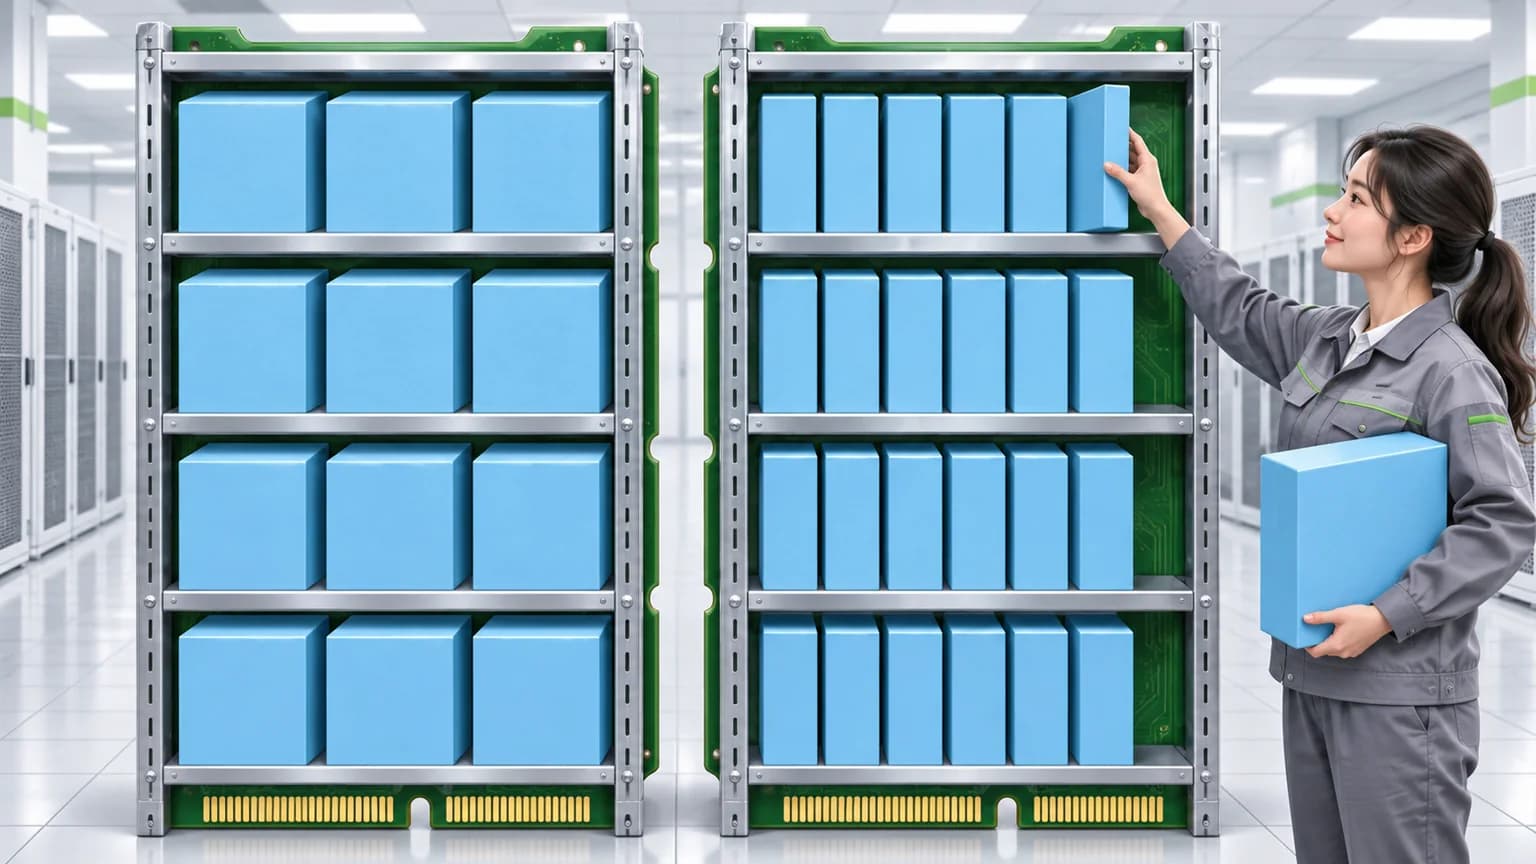
Хранение KV-кэша в FP8 вместо FP16 или BF16 уменьшает его объём примерно вдвое, потому что каждое значение занимает 1 байт вместо 2. На той же видеокарте помещается примерно вдвое больше токенов контекста или одновременных диалогов. Веса модели при этом не меняются. Качество может немного сдвинуться, поэтому перед включением в продакшене нужен сравнительный тест на ваших задачах.
Материал подготовила AI студия Владимира Ломтева 16 ноября 2026 года для инженеров, которые запускают LLM на vLLM, SGLang или llama.cpp и упираются в видеопамять. Параметры сверены с документацией движков и заметками к выпуску llama.cpp v1.0.0. Собственных замеров качества и скорости мы не проводили. Все расчёты в статье условные и показывают порядок величин.
Содержание
- Что именно сжимается
- Сколько памяти освобождает FP8: расчёт
- E4M3 и E5M2: какой формат FP8 выбрать
- Как включить FP8-кэш в разных движках
- Как проверить, что качество не упало
- Где FP8-кэш рискованнее
- Скорость: что ожидать
- Частые вопросы
Что именно сжимается
У LLM на сервере три основных потребителя видеопамяти: веса модели, KV-cache и служебные буферы. Квантование весов, например GGUF Q4 или AWQ, уменьшает первую часть. Сжатие KV-кэша уменьшает вторую — память, которая растёт с длиной контекста и числом одновременных запросов. Это независимые настройки: можно хранить веса в BF16, а кэш в FP8, и наоборот. Как устроено квантование весов, разобрано в статье «Квантование LLM на практике».
Сжимать кэш имеет смысл, когда модель уже помещается, но не хватает места для длинных контекстов или параллельных пользователей. Если не помещаются сами веса, FP8-кэш эту проблему не решит. Порядок диагностики описан в статье «LLM не помещается в видеопамять».
Сколько памяти освобождает FP8: расчёт
Объём KV-кэша на один токен для модели с GQA:
2 × число слоёв × число KV-голов × размер головы × байт на значение
Возьмём условную конфигурацию, типичную для 8B-моделей: 32 слоя, 8 KV-голов, размер головы 128.
| Формат кэша | Байт на значение | Объём на токен | Токенов в пуле 20 ГиБ | Сессий по 8192 токена |
|---|---|---|---|---|
| FP16 / BF16 | 2 | 128 КиБ | 163 840 | 20 |
| FP8 | 1 | 64 КиБ | 327 680 | 40 |
Расчёт: 2 × 32 × 8 × 128 × 2 = 131 072 байта = 128 КиБ; 20 ГиБ / 128 КиБ = 163 840 токенов; 163 840 / 8192 = 20 сессий. Для FP8 все значения в два раза лучше. Реальная ёмкость будет немного меньше из-за коэффициентов масштаба, выравнивания блоков и того, что движок оставляет часть памяти под активации.
Удвоение относится только к пулу KV-кэша. Если из 24 ГБ видеокарты 16 ГБ занимают веса, то свободной памяти для кэша после перехода на FP8 больше не станет — вдвое больше станет токенов, которые помещаются в те же гигабайты.
E4M3 и E5M2: какой формат FP8 выбрать
FP8 бывает двух основных вариантов. В E4M3 четыре бита отведено под порядок и три под мантиссу: точность выше, диапазон уже. В E5M2 пять бит под порядок и два под мантиссу: диапазон шире, точность ниже. Для хранения значений внимания обычно важнее точность, поэтому E4M3 с коэффициентами масштаба встречается в документации чаще.
Коэффициент масштаба переводит значения в диапазон, который FP8 представляет без потерь от переполнения. Без него значения хранятся как есть. В документации vLLM по квантованному KV-кэшу сказано, что при fp8 без калибровки все коэффициенты равны 1.0, а в справочнике аргументов SGLang прямо предупреждают, что коэффициенты по умолчанию 1.0 могут привести к проблемам с точностью, и рекомендуют передавать файл с ними.
Как включить FP8-кэш в разных движках
| Движок | Параметр | Значения FP8 | Коэффициенты масштаба |
|---|---|---|---|
| vLLM | --kv-cache-dtype |
fp8, fp8_e4m3, fp8_e5m2 и другие |
Калибровка через llm-compressor, по умолчанию 1.0 |
| SGLang | --kv-cache-dtype |
fp8_e4m3, fp8_e5m2 |
Файл --quantization-param-path |
| llama.cpp | -ctk, -ctv |
f8_e4m3 с версии 1.0.0 |
Опциональные статические коэффициенты на тензор |
vLLM
По умолчанию --kv-cache-dtype auto, то есть кэш хранится в типе данных модели. Документация указывает, что fp8_e4m3 поддерживается на CUDA 11.8+ и ROCm, fp8_e5m2 — на CUDA 11.8+. В справочнике аргументов движка перечислено и больше вариантов, включая 4-битные; их поддержка зависит от GPU и версии.
vllm serve Qwen/Qwen3-8B \
  --host 127.0.0.1 --port 8000 \
  --api-key "$VLLM_API_KEY" \
  --kv-cache-dtype fp8 \
  --kv-cache-dtype-skip-layers sliding_window
Параметр --kv-cache-dtype-skip-layers оставляет чувствительные слои, например слои со скользящим окном внимания, в исходном типе. Документация vLLM помечает как рекомендуемый путь калибровку коэффициентов на наборе данных через llm-compressor, со стратегией на тензор или на голову внимания. Масштаб на голову требует бэкенда Flash Attention.
SGLang
python3 -m sglang.launch_server \
  --model-path Qwen/Qwen3-8B --host 127.0.0.1 --port 30000 \
  --kv-cache-dtype fp8_e4m3 \
  --quantization-param-path ./kv_scales.json
Путь ./kv_scales.json — пример. Файл с коэффициентами получают калибровкой или берут из репозитория модели, если автор его опубликовал.
llama.cpp
В описании llama-server для -ctk и -ctv перечислены значения f32, f16, bf16, f8_e4m3, q8_0, q4_0, q4_1, iq4_nl, q5_0, q5_1, по умолчанию f16. FP8 добавлен в выпуске v1.0.0 от 13 ноября 2026 года вместе с необязательными статическими коэффициентами на тензор. Ключи и значения можно сжимать по-разному:
llama-server -m ./models/model-Q4_K_M.gguf \
  --host 127.0.0.1 --port 8080 \
  -c 32768 -np 4 \
  -fa on \
  -ctk f8_e4m3 -ctv f8_e4m3
В llama.cpp давно есть и целочисленные варианты кэша q8_0 и q4_0. Они тоже экономят память, но это другая схема квантования. Сравнивайте их с FP8 на одном тестовом наборе, а не по названию.
Как проверить, что качество не упало
Документация движков не даёт универсальной оценки потери качества: она зависит от модели, длины контекста и задачи. Поэтому проверять нужно на своих данных.
- Соберите тестовый набор. 100–300 реальных запросов из ваших сценариев с эталонными ответами или критериями оценки. Добавьте длинные документы, близкие к максимальному рабочему контексту.
- Зафиксируйте условия. Одна и та же модель и версия движка, температура 0, одинаковые параметры генерации. Меняется только тип кэша.
- Сравните ответы. Долю ответов, совпадающих с эталоном или прошедших проверку; для структурированного вывода — долю валидного JSON; для поиска по документу — найден ли нужный факт на разной глубине контекста.
- Сравните распределения токенов. В llama.cpp для этого есть утилита
llama-perplexity: по её README логиты эталонного прогона сохраняют через--kl-divergence-base, а флаг--kl-divergenceсчитает расхождение с ними. Чем меньше расхождение, тем ближе поведение к исходному кэшу. - Проверьте скорость и ёмкость. Сколько одновременных запросов выдерживает сервер до роста очереди, по методике из статьи о нагрузочном тесте локальной LLM.
- Примите решение по порогу. Заранее запишите, какое падение метрики допустимо, например не больше одного процентного пункта по доле правильных ответов, и сравните с результатом.
Пример расчёта KL-дивергенции в llama.cpp:
# эталонный прогон с кэшем f16, логиты сохраняются в файл
llama-perplexity -m ./models/model-Q4_K_M.gguf -f ./eval.txt -c 4096 \
  -ctk f16 -ctv f16 --kl-divergence-base ./base.kld
# прогон с FP8-кэшем и сравнение с эталоном
llama-perplexity -m ./models/model-Q4_K_M.gguf -f ./eval.txt -c 4096 \
  -fa on -ctk f8_e4m3 -ctv f8_e4m3 \
  --kl-divergence-base ./base.kld --kl-divergence
Перплексия и KL-дивергенция показывают сдвиг распределения, но не заменяют проверку на ваших задачах. Модель может немного изменить вероятности и при этом отвечать так же правильно, и наоборот. Как построить собственный набор оценки, описано в статье о своём бенчмарке для выбора LLM.
Где FP8-кэш рискованнее
- Очень длинный контекст. Ошибки округления накапливаются в механизме внимания, и поиск фактов в конце длинного документа страдает раньше, чем короткий диалог.
- Задачи с точным ответом. Код, расчёты, извлечение реквизитов из документов, где одна ошибочная цифра делает ответ неверным.
- Модели с особыми слоями. Скользящее окно, гибридные архитектуры, модели, у которых автор уже задал особый формат кэша. Для них проверяйте рекомендации в карточке модели.
- Отсутствие коэффициентов масштаба. Значения по умолчанию 1.0 — самый простой и самый рискованный вариант.
Скорость: что ожидать
FP8-кэш уменьшает объём данных, которые нужно читать на каждом шаге генерации, и позволяет собрать больше запросов в батч. Это может повысить пропускную способность. Но итог зависит от того, поддерживает ли ваш GPU и бэкенд внимания вычисления с FP8 напрямую или тратит время на преобразование. Документация vLLM, например, отмечает, что с бэкендом Flash Attention 3 в FP8 квантуются и запросы. Без замера на своём железе не обещайте ускорение, обещайте только ёмкость.
Частые вопросы
FP8-кэш и FP8-веса — одно и то же? Нет. FP8-веса уменьшают модель, FP8-кэш уменьшает память под контекст. Их включают разными параметрами и проверяют отдельно.
Можно ли включить FP8-кэш на любой видеокарте? vLLM и SGLang указывают для FP8 требование CUDA 11.8+, а для отдельных форматов и бэкендов нужны более новые GPU и версии CUDA. В llama.cpp поддержка зависит от бэкенда сборки. Проверяйте запуском и логами движка.
Что выбрать: FP8 или q8_0 в llama.cpp? Оба формата занимают около байта на значение. Выбирайте по результату одного и того же теста качества и скорости на вашей модели.
Нужно ли менять приложение? Нет, API остаётся прежним. Меняются только параметры запуска сервера и, если повезёт, допустимое число параллельных запросов.
Как AI студия Владимира Ломтева помогает с настройкой FP8-кэша
AI студия Владимира Ломтева разворачивает и настраивает LLM на серверах компании. Для сжатия KV-кэша это означает:
- рассчитать, сколько контекста и параллельных пользователей нужно бизнес-сценарию и сколько памяти под это уходит;
- собрать тестовый набор из реальных запросов и сравнить качество с исходным кэшем и с FP8;
- подобрать формат, коэффициенты масштаба и параметры движка под конкретную модель и GPU;
- провести нагрузочное тестирование и передать команде критерии, по которым настройку можно откатить.
Первый шаг — выбрать один сценарий, где сейчас не хватает контекста или параллельности, и записать метрику качества, которую нельзя ухудшить. Обсудить задачу.
Итог: FP8 удваивает ёмкость кэша, качество нужно доказать
FP8 вдвое уменьшает объём KV-кэша и позволяет держать больше контекста на той же видеокарте. Это одна из самых дешёвых оптимизаций памяти, но не бесплатная. Включайте её с коэффициентами масштаба, оставляйте чувствительные слои в исходном типе и принимайте решение по тесту на своих задачах, а не по названию формата.