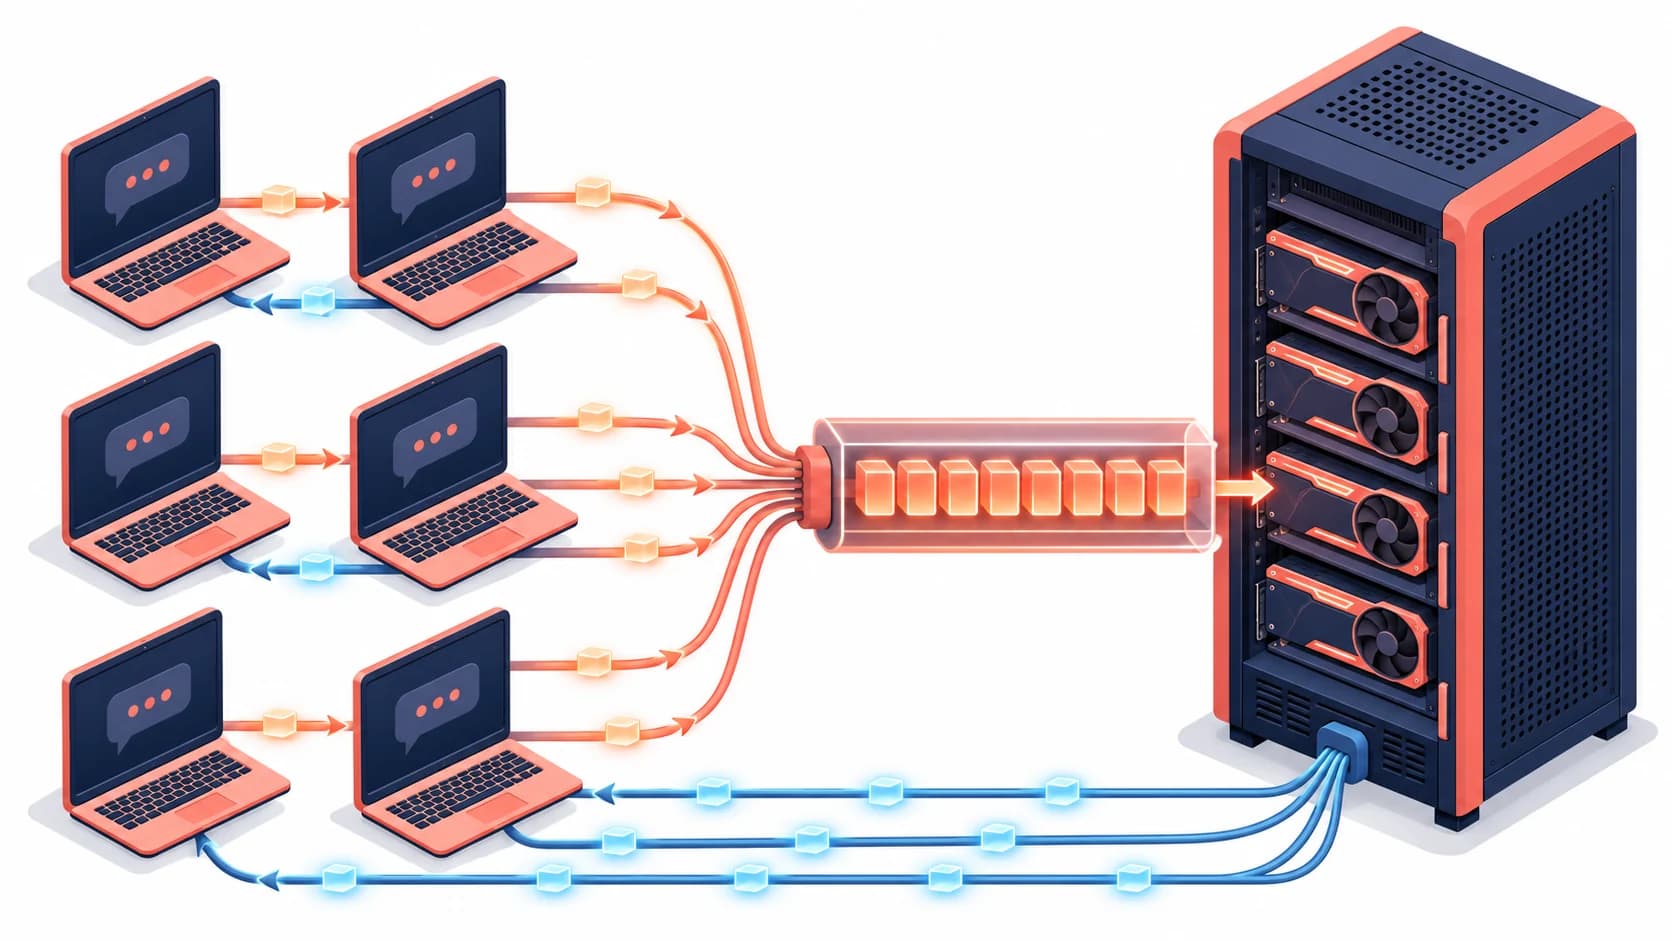
Нагрузочный тест локальной LLM должен показывать, сколько корректной работы сервер выполняет при допустимой задержке и доле отказов. Для этого фиксируют модель, оборудование, длины запросов, режим кэша и профиль поступления. Одна цифра токенов в секунду без этих условий не описывает готовность сервиса.
Материал подготовила AI студия Владимира Ломтева 14 ноября 2026 года для разработчиков и команд эксплуатации. Это инструкция по организации измерений, а не публикация собственных аппаратных результатов. Ниже нет рейтинга GPU и вымышленных замеров. Серверы тестируют только в разрешённой среде; учебный сценарий не запускают на чужом или рабочем endpoint без согласованного окна.
Содержание
- Что именно проверять
- Сначала определить критерии приёмки
- Какие метрики записывать
- Карточка окружения
- Как подготовить поток запросов
- Открытая и закрытая модель нагрузки
- Холодный и прогретый режимы
- Пример синтетического теста vLLM
- Как наращивать нагрузку
- Как читать результат без ошибочных выводов
- Что должно остаться после теста
- Частые вопросы
Что именно проверять
Разделите два вопроса: правильно ли модель решает задачу и выдерживает ли система необходимый поток. Первый требует эталонных примеров и правил оценки. Второй — измерения задержки, мощности, очереди и ошибок. Быстрый неверный ответ не должен считаться успешной бизнес-операцией.
Существуют и разные границы системы. Тест самого движка может не включать OCR, поиск документов, шлюз и инструменты агента. Для пользовательского обещания нужен сквозной тест приложения. Начать удобно с сервера модели, а затем добавить остальные компоненты и сравнить вклад каждого.
Для проверки качества используйте методику собственного бенчмарка LLM. Для серверного измерения у vLLM есть Benchmark CLI, где отдельно предусмотрены разные виды тестов.
Сначала определить критерии приёмки
До запуска запишите пользовательское ожидание. Для чата это может быть ограничение времени до первого токена, для извлечения полей — полное завершение в заданный срок, для ночного архива — обработка всего объёма к установленному времени. Пределы задаёт процесс, а не шаблон из чужого бенчмарка.
Полезно разделять обычный режим и перегрузку. В обычном режиме сервис должен выполнять согласованные SLO. При перегрузке — ограничивать очередь и возвращать понятный отказ, а не накапливать бесконечные запросы. Восстановление после снятия нагрузки тоже входит в тест.
Критерии фиксируют заранее, чтобы не выбрать удобную метрику после получения результата. Если сначала обещали быстрый чат, а затем показали только общий throughput архива, задача приёмки не выполнена.
Какие метрики записывать
| Показатель | Единица | Как интерпретировать |
|---|---|---|
| Входящий поток | Запросы в секунду | Сколько работы предлагает клиент |
| Успешный поток | Успешные запросы в секунду | Сколько система действительно завершает |
| TTFT | Миллисекунды или секунды | Время до первого токена на выбранной границе |
| Полная задержка | Миллисекунды или секунды | Время до завершения ответа |
| Выходной throughput | Токены в секунду | Суммарная генерация за окно |
| Ошибки и тайм-ауты | Количество и доля | Работа, которую нельзя скрывать из отчёта |
| Очередь и память | Запросы, байты, доля пула | Объяснение причин деградации |
Записывайте знаменатель долей. «Доля ошибок 2%» должна означать определённое число ошибок среди определённого количества отправленных запросов за известный период. Разделяйте клиентский тайм-аут, серверный отказ и ответ, не прошедший проверку содержания.
Квантили рассчитывают по отдельным наблюдениям. Для каждого запуска указывайте число запросов и длительность окна. Не считайте среднее нескольких p95 эквивалентом общего p95: при объединении запусков нужны исходные наблюдения либо корректная агрегация гистограмм.
Карточка окружения
Перед измерением сохраните:
- модель, revision, формат весов и токенизатор;
- движок, образ и конфигурацию запуска;
- GPU, число устройств, драйвер и межсоединение;
- размер контекста, предел выхода и параметры генерации;
- правила кэша и процедуру прогрева;
- способ подачи запросов и ограничения клиента;
- состояние соседних процессов и выбранное окно теста.
Карточка позволяет отличить эффект настройки от изменения окружения. Если во втором запуске использовалась другая модель или освободилась память соседнего процесса, нельзя приписывать весь результат одному флагу движка.
Подход к расчёту ресурса дополняет статья о квантовании и памяти. В нагрузочном тесте нужна не только оценка весов, но и фактическое поведение активных последовательностей.
Как подготовить поток запросов
Начните с распределения реальных задач. Разделите короткие вопросы, длинные документы и запросы с длинным выходом. Если есть общий системный промпт или повторно используемый документ, сохраните эту особенность. Она влияет на возможность переиспользования вычислений.
Синтетические последовательности полезны для изоляции факторов: одинаковый вход и заданный выход позволяют сравнить настройки. Но такой тест не подтверждает качество и не всегда воспроизводит рабочий кэш. В отчёте назовите его синтетическим.
Для рабочих текстов используйте разрешённый обезличенный набор. Не отправляйте внутренние документы в публичный генератор нагрузки или внешнюю систему трассировки без согласованной политики. Проверяйте и сохранённые ответы: тестовый журнал иногда содержит те же чувствительные сведения, что и исходный запрос.
Открытая и закрытая модель нагрузки
При закрытой схеме фиксированное число клиентов отправляет следующий запрос после завершения предыдущего. Если сервер замедляется, клиенты автоматически снижают частоту. Такой режим удобен для изучения параллельности, но может скрыть поведение при независимом входящем потоке.
При открытой схеме запросы приходят с заданной частотой независимо от завершения предыдущих. Если мощности не хватает, очередь растёт или начинаются отказы. Это полезно для оценки пиков, но требует ограничений по длительности и объёму, чтобы тест оставался управляемым.
Число одновременных соединений не заменяет описание частоты. В протоколе укажите обе величины и поведение генератора при достижении лимита. Убедитесь, что клиентская машина сама не стала ограничением сети, CPU или обработки результатов.
Холодный и прогретый режимы
Холодный старт может включать загрузку весов и подготовку runtime. Прогретая модель уже находится в памяти. Prefix cache дополнительно способен переиспользовать общий вход. Эти состояния нужно разделять, а не усреднять случайно.
В документации vLLM Benchmark CLI прямо отмечена возможность повторного использования промптов между тестами. Поэтому повторный запуск с теми же данными может измерять другой режим. Если цель — тест без переиспользования, задайте процедуру сброса или изменения набора; если цель — рабочий повторяющийся поток, сохраните реалистичную повторяемость.
Отдельно проверьте восстановление после перезапуска. Сервис может выполнять SLO в установившемся режиме, но долго выходить на него после обновления. Для процесса с жёсткими ожиданиями это влияет на резервирование.
Пример синтетического теста vLLM
Пример рассчитан на локальный тестовый сервер, который обслуживает local-qwen, и установленный совместимый CLI vLLM. Сначала проверьте доступные параметры:
vllm bench serve --helpЗатем выполните небольшой прогон без заявленных заранее результатов:
vllm bench serve \
  --backend openai-chat \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/chat/completions \
  --model local-qwen \
  --tokenizer Qwen/Qwen2.5-1.5B-Instruct \
  --dataset-name random \
  --random-input-len 256 \
  --random-output-len 64 \
  --num-prompts 40 \
  --request-rate 1 \
  --save-result \
  --result-dir ./benchmark-results
Это учебные размеры: 256 входных токенов, целевой выход 64 токена, 40 запросов и подача около одного запроса в секунду согласно поведению инструмента. Они не являются рекомендуемой производственной нагрузкой. Для защищённого сервера передайте ключ поддерживаемым CLI способом, не вставляя секрет в публикуемый протокол. Описание параметров находится в справке vllm bench serve.
Сохраните версию инструмента вместе с результатом. Перед копированием примера в другую версию проверьте названия backend, параметры токенизатора и режим формирования случайных последовательностей.
Как наращивать нагрузку
Сначала выполните единичный запрос и проверьте корректность. Затем измерьте небольшой устойчивый поток. После этого увеличивайте один параметр: частоту, число клиентов или длину запроса. Не меняйте всё одновременно, иначе причина деградации останется неясной.
Найдите область, где задержка начинает расти быстрее входящего потока. Сопоставьте её с очередью, памятью, временем prefill и decode. Для производственной мощности выбирайте режим, который выполняет SLO с необходимым резервом, а не максимальный достигнутый throughput.
После пика уменьшите нагрузку и наблюдайте восстановление. Если очередь не сокращается, процессы остаются в ошибке или клиент продолжает повторять отказы, это самостоятельное замечание приёмки. Автоматические retries могут усиливать перегрузку, поэтому тестируйте их поведение отдельно.
Как читать результат без ошибочных выводов
Высокая утилизация GPU не равна успешному пользовательскому опыту. Устройство может быть занято, пока значительная часть запросов ждёт или завершается по тайм-ауту. И наоборот, низкая утилизация может объясняться редким потоком, а не неисправностью.
Снижение средней задержки не доказывает улучшение тяжёлых сценариев. Посмотрите отдельные классы запросов и хвост распределения. Если изменилось качество или длина выходов, сначала объясните это, а затем сравнивайте скорость.
Для воспроизводимой оптимизации используйте строку эксперимента:
Дата и конфигурация:
Гипотеза и единственное существенное изменение:
Набор запросов и правила кэша:
Предложенная и завершённая нагрузка:
TTFT, полное время, ошибки, память:
Проверка качества:
Решение и ограничение вывода:
Этот шаблон можно копировать для каждого прогона. Он не требует придумывать итоговый процент ускорения: вывод появляется после измерений.
Что должно остаться после теста
Сохраните исходную конфигурацию, описание набора, параметры генератора, сырые результаты и короткое решение. Определите допустимый поток, условия превышения и способ возврата к стабильному режиму. При существенном изменении модели, контекста или оборудования проверку повторяют.
Серверные метрики дополняют, а не заменяют клиентские измерения. Для vLLM используйте описание Production Metrics, а для общей системы — материал о мониторинге LLM и агентов.
Механизмы, которые стоят за настройками сервера, разобраны в гиде по движкам и ускорению инференса. До выбора оборудования полезно пройти сравнение собственного инференса и API.
Частые вопросы
Достаточно ли одного запроса для проверки скорости?
Он полезен для минимальной диагностики, но не описывает очередь, параллельность, кэш и поведение при пике. Для приёмки нужен согласованный поток.
Почему тест быстрее реального приложения?
В нём могут отсутствовать подготовка данных, поиск, шлюз, внешние инструменты и сетевой путь. Сравните границы измерения и длины последовательностей.
Можно ли сравнивать разные движки?
Да, если зафиксированы модель, оборудование, набор и правила генерации. Различия формата весов и функций нужно раскрыть, чтобы результат относился к конкретным конфигурациям.
Какой p95 считать хорошим?
Тот, который соответствует задаче и пользовательскому ожиданию при заданном потоке. Универсального значения для чата, голосового сервиса и ночного архива нет.
Как AI студия Владимира Ломтева помогает проверить производительность
AI студия Владимира Ломтева может связать аудит процесса, подготовку контрольных данных и тестирование выбранного варианта LLM перед интеграцией. Для нагрузочной проверки это означает сформулировать критерий приёмки, воспроизвести рабочий сценарий и проверить результат в составе запускаемой системы.
Первый шаг — выбрать процесс, его текущую задержку, объём и допустимую долю ручной доработки. Обсудить задачу.
Как принять сервер по результатам теста
Принимайте конфигурацию, которая сохраняет качество и выполняет согласованные пределы задержки и ошибок на рабочем потоке. Отдельно зафиксируйте холодный старт, перегрузку и восстановление. Результат теста должен позволять повторить измерение и объяснить, какую нагрузку система действительно выдерживает.