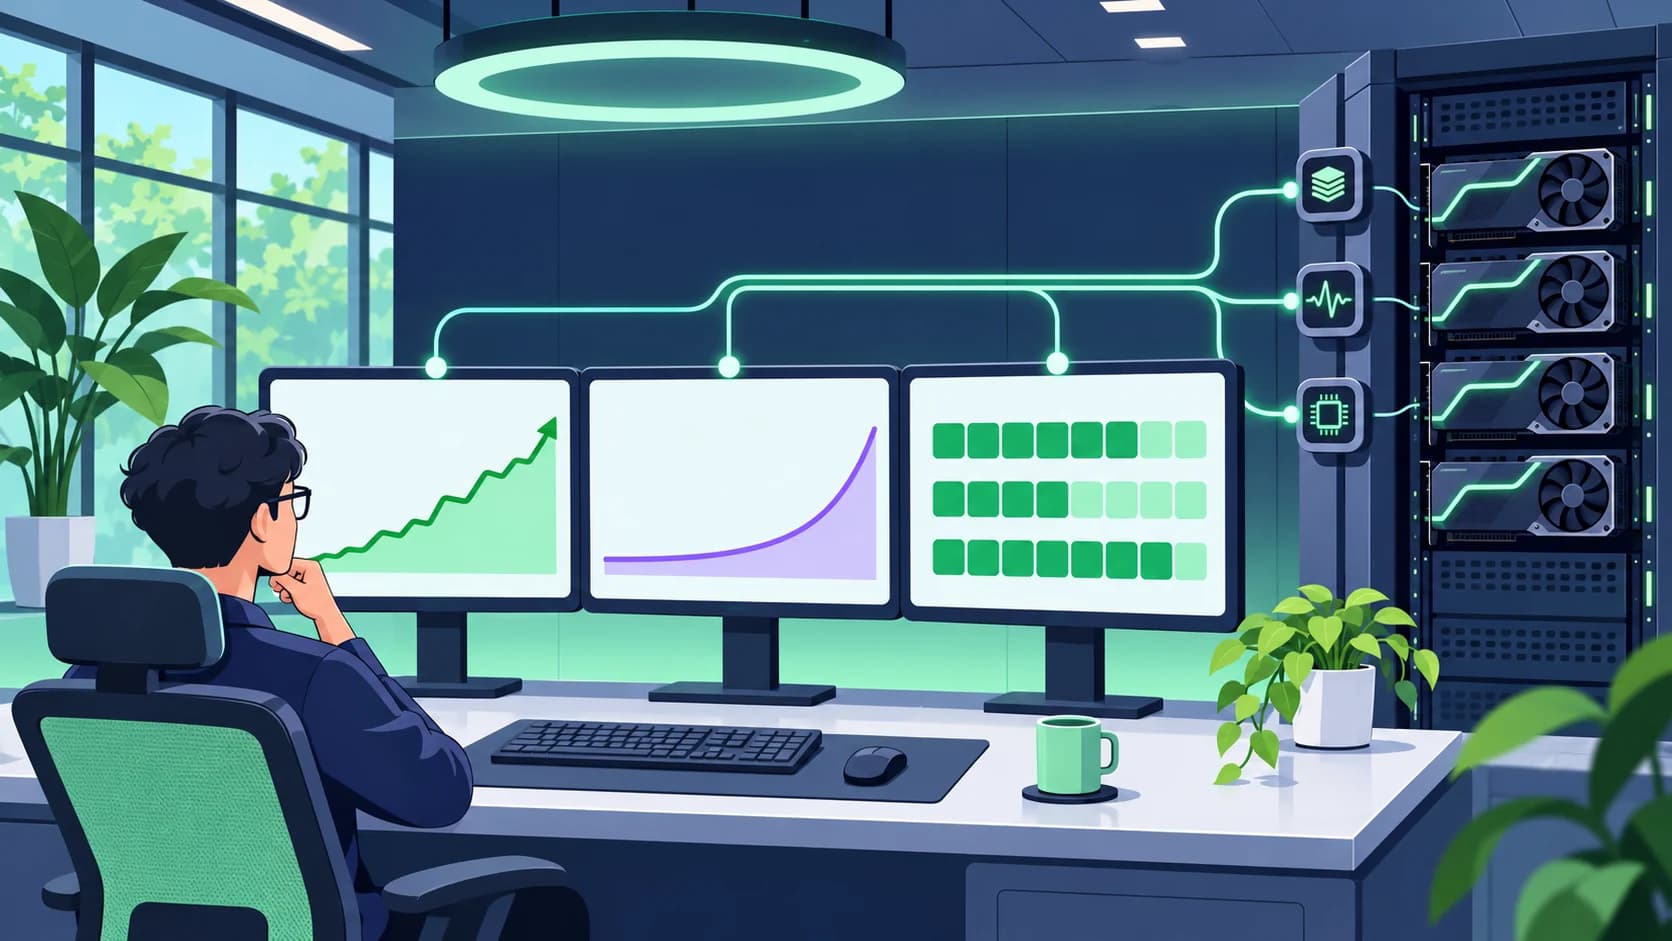
Мониторинг vLLM должен связывать доступность endpoint, очередь, задержки, токены и состояние GPU. Prometheus собирает временные ряды, Grafana показывает панели, а отдельный exporter помогает наблюдать оборудование. Чтобы графики были полезны, определения метрик и пределы нужно привязать к рабочей задаче и закреплённой версии сервера.
Материал подготовила AI студия Владимира Ломтева 14 ноября 2026 года для разработчиков и администраторов собственного инференса. Это схема настройки и диагностики по официальной документации, без заявления о выполненном развёртывании. Примеры конфигурации предназначены для тестовой Linux-среды с уже работающим vLLM. Качество ответов и бизнес-эффект измеряются отдельно от инфраструктурных графиков.
Содержание
- Какие вопросы должен закрывать мониторинг
- Базовая схема сбора
- Шаг 1. Проверить экспорт vLLM
- Шаг 2. Настроить Prometheus
- Шаг 3. Подключить Grafana
- Какие панели создать первыми
- Примеры запросов к метрикам
- Как интерпретировать очередь и память
- Алерты должны соответствовать действию
- Как разобрать инцидент
- Качество ответа требует отдельного наблюдения
- Шаблон приёмки мониторинга
- Частые вопросы
Какие вопросы должен закрывать мониторинг
Начните с операционных вопросов: доступен ли сервис, поступает ли работа, успевает ли модель, почему растёт задержка и что происходит с памятью. Панель должна помогать выбрать следующее действие, а не просто показывать постоянно меняющиеся линии.
Разделите три уровня. Инфраструктура описывает GPU, CPU, RAM и процессы. Сервер модели — запросы, очередь и генерацию. Приложение — полный пользовательский путь и применимость ответа. Полезная архитектура связывает их временем и идентификатором выпуска, не превращая исходный текст пользователя в метку метрики.
В Production Metrics vLLM описаны серверные показатели. Перед настройкой проверьте фактический экспорт вашей версии: названия, типы и метки могут отличаться от последней документации.
Базовая схема сбора
vLLM предоставляет endpoint метрик, Prometheus обращается к нему по расписанию, Grafana запрашивает данные у Prometheus. Для GPU добавляют отдельный источник телеметрии, совместимый с оборудованием и системой. Для сквозного времени клиентское приложение формирует собственные измерения.
Если сервисы находятся в разных контейнерах, localhost у каждого свой. Адрес, который работает из shell хоста, может быть недоступен из контейнера Prometheus. Сначала определите сетевую схему, затем копируйте конфигурацию.
Не публикуйте технические endpoints в открытый интернет ради удобства просмотра. Доступ к метрикам и интерфейсам наблюдения должен соответствовать внутренней политике. Даже без полных промптов метки могут раскрывать названия моделей, узлы и характер нагрузки.
Шаг 1. Проверить экспорт vLLM
На машине, где локально доступен сервер, проверьте:
curl -fsS http://127.0.0.1:8000/metrics -o vllm-metrics.txtЕсли endpoint защищён шлюзом или другой политикой, используйте предназначенный для мониторинга маршрут и поддерживаемую аутентификацию. Не предполагайте, что ключ генерации автоматически защищает все технические endpoints: это нужно проверить для своей конфигурации.
В файле должны быть определения и наблюдения метрик. Отсутствие пользовательских запросов может означать отсутствие некоторых рядов. Отправьте разрешённый короткий запрос и сравните экспорт. Проверьте доступность /metrics отдельно от способности модели отвечать.
Официальный пример Prometheus и Grafana для vLLM помогает сопоставить компоненты. Не переносите готовую панель без проверки соответствия метрик вашей версии.
Шаг 2. Настроить Prometheus
Для примера ниже Prometheus выполняется в той же сетевой среде хоста, где vLLM доступен на 127.0.0.1:8000. Сохраните prometheus.yml:
global:
  scrape_interval: 15s
  evaluation_interval: 15s

scrape_configs:
  - job_name: vllm
    metrics_path: /metrics
    static_configs:
      - targets:
          - 127.0.0.1:8000
        labels:
          environment: local-test
Интервалы 15 секунд — учебный выбор, а не универсальный стандарт. Частота зависит от нужной детализации, количества рядов и расходов сбора. Для короткого пика редкий scrape может пропустить важную динамику; слишком частый увеличивает объём данных.
Если Prometheus уже установлен, проверьте конфигурацию штатным инструментом:
promtool check config prometheus.ymlПараметры конфигурации описаны в документации Prometheus. После применения проверьте target и запрос up{job="vllm"}. Значение доступности сбора не равно готовности модели: оно подтверждает только соответствующую техническую проверку.
Шаг 3. Подключить Grafana
Добавьте источник Prometheus, указав адрес, доступный именно процессу Grafana. Используйте разрешённые учётные данные и TLS там, где этого требует сеть. Кнопка проверки соединения должна подтвердить доступ к источнику; затем убедитесь, что запрос up возвращает ожидаемый target.
В инструкции Grafana по Prometheus data source описаны настройки подключения. Не путайте адрес браузера пользователя и адрес сервера Grafana: запросы к данным выполняет не обязательно браузер.
Сначала создайте несколько простых панелей вручную. Это помогает понять определения рядов. Импортированный dashboard может выглядеть убедительно, но показывать пустые или неверно агрегированные данные из-за другого имени job, меток и версии метрик.
Какие панели создать первыми
| Панель | Что наблюдать | Какое решение помогает принять |
|---|---|---|
| Доступность | Scrape и проверка генерации | Отличить сбой наблюдения от сбоя модели |
| Поток | Входящие, завершённые и ошибочные запросы | Понять, есть ли фактическая работа |
| Очередь | Ожидающие и активные запросы | Найти перегрузку и ограничения допуска |
| Задержка | TTFT, полное время, время этапов | Определить источник ожидания |
| Генерация | Входные и выходные токены | Объяснить изменение профиля работы |
| Память | Состояние пула KV-cache и GPU | Выявить ограничение ресурса |
| Выпуск | Перезапуски и смена версии | Связать деградацию с изменением |
Показатели GPU дополняют серверные. Для NVIDIA один из вариантов — DCGM Exporter. Его установку выбирают по поддержке оборудования и инфраструктуры, а не запускают произвольный привилегированный контейнер без проверки.
Примеры запросов к метрикам
После проверки наличия указанных имён можно начать с очереди:
sum(vllm:num_requests_waiting{job="vllm"})Активная работа:
sum(vllm:num_requests_running{job="vllm"})Для classic histogram полной задержки пример p95 выглядит так:
histogram_quantile(
  0.95,
  sum by (le) (
    rate(vllm:e2e_request_latency_seconds_bucket{job="vllm"}[5m])
  )
)
Запрос объединяет выбранные серии в одну оценку. Если нужно сравнивать модели или экземпляры, сохраните нужные метки в sum by. При отсутствии такой histogram в вашей версии запрос не становится верным от совпадения названия в статье. Тип и допустимость агрегации сверяйте с фактическим экспортом и справочником функций Prometheus.
Не применяйте rate к любому показателю механически. Счётчики и gauge имеют разный смысл. Отсутствующий ряд, ноль и ошибка запроса тоже различаются: панель должна позволять их заметить.
Как интерпретировать очередь и память
Рост очереди при стабильном потоке может указывать на снижение мощности, более тяжёлые запросы или изменение планирования. Сопоставьте его с длиной входов, выходов и активным исполнением. Один график не определяет причину.
Занятая VRAM не всегда означает исчерпание полезного ресурса. Движок может заранее выделять пул. Метрика использования KV-cache и общий объём GPU описывают разные уровни. Поэтому нельзя выводить одинаковый порог аварии для них только из слова «память».
Снижение GPU utilization при росте пользовательской задержки может указывать на очередь до модели, сеть или внешние инструменты. Сначала проверьте полный путь. Разбор архитектуры вокруг модели есть в статье об опыте Битрикс24.
Алерты должны соответствовать действию
Для каждого сигнала запишите владельца и следующий шаг. Недоступность сервера, длительное превышение SLO и рост отказов обычно требуют разных инструкций. Сигнал «GPU занят» без пользовательского ухудшения может вообще не требовать вмешательства.
Порог выбирают после базового измерения и согласования ожиданий. Не копируйте чужие секунды и проценты как норматив. Учтите минимальную длительность состояния, чтобы единичный короткий всплеск не создавал поток ложных сообщений.
Разделяйте деградацию и отсутствие данных мониторинга. Если Prometheus не собирает метрики, график может исчезнуть вместо роста ошибки. Нужен отдельный контроль самого канала наблюдения и его восстановления.
Как разобрать инцидент
- Подтвердите симптом на стороне пользователя или согласованной проверки.
- Сравните начало деградации с выпуском модели, перезапуском и изменением нагрузки.
- Проверьте входящий поток, очередь и успешное завершение.
- Разделите задержку по этапам и классам запросов.
- Проверьте память, ошибки устройства и соседние процессы.
- Примените предусмотренное ограничение или откат.
- После восстановления сохраните причину и воспроизводимый тест.
Не увеличивайте ресурсы как единственный универсальный ответ. Если приложение отправляет дубли, бесконечно повторяет отказы или включает весь архив в каждый промпт, дополнительный GPU может только временно скрыть проблему.
Качество ответа требует отдельного наблюдения
HTTP 200 и высокая скорость не подтверждают правильность. Для извлечения данных проверяют поля и типы, для RAG — опору на доступные источники, для агента — корректность действия. Контрольный набор запускают после существенных изменений модели и конфигурации.
Сопоставляйте технический выпуск и оценку качества. Если задержка улучшилась после уменьшения контекста, проверьте, не исчезли ли важные условия документа. Общая схема наблюдаемости разобрана в статье о мониторинге LLM и ИИ-агентов.
Не сохраняйте полный пользовательский текст в labels. Это увеличивает кардинальность и раскрывает содержимое. Для трасс используйте отдельную политику хранения и доступа; данные должны быть разрешены к обработке в выбранной системе.
Шаблон приёмки мониторинга
Версия модели и сервера:
Адрес и доступ к источнику метрик:
Список проверенных метрик и единиц:
Панели задержки, очереди, ошибок и памяти:
Проверка отсутствующих данных:
SLO и обоснованные пороги:
Владелец каждого алерта:
Действие при перегрузке и отказе:
Политика данных в метках и трассах:
Дата проверки восстановления:
Заполненный шаблон полезнее набора скриншотов без определения метрик. Он позволяет новому дежурному понять, какие наблюдения ожидаются и что делать при изменении.
Механизмы, которые стоят за настройками сервера, разобраны в гиде по движкам и ускорению инференса. До выбора оборудования полезно пройти сравнение собственного инференса и API.
Частые вопросы
Достаточно ли nvidia-smi?
Для быстрой диагностики GPU это полезный инструмент, но он не описывает пользовательскую очередь, качество и полную задержку приложения. Нужны несколько уровней наблюдения.
Почему Grafana показывает пустую панель?
Проверьте доступ к Prometheus, имя job, временной диапазон, существование метрики и метки. После обновления runtime готовая панель может требовать адаптации.
Можно ли считать среднее p95 разных серверов?
Такое среднее не является общим p95. Для общей оценки нужно корректно агрегировать совместимые histogram buckets либо использовать исходные наблюдения подходящим способом.
Нужно ли сразу строить много панелей?
Начните с доступности, потока, задержки, очереди и памяти. Добавляйте детализацию под конкретные вопросы диагностики, сохраняя определения и владельцев.
Как AI студия Владимира Ломтева помогает с эксплуатацией LLM
AI студия Владимира Ломтева может связать развёртывание модели с интеграцией, тестированием и сопровождением рабочего процесса. Для наблюдаемости это означает определить критерий пользовательского результата, проверить технический маршрут и подготовить основу для контроля после запуска.
Первый шаг — выбрать один процесс, его текущую задержку, тип ошибок и критерий приёмки. Обсудить задачу.
Как понять, что мониторинг полезен
Полезный мониторинг позволяет отличить отказ сбора от отказа модели, объяснить рост задержки и выбрать предусмотренное действие. Проверьте панели на управляемом тестовом сбое и восстановлении. Сохраните определения метрик и связи с SLO вместе с конфигурацией сервиса.