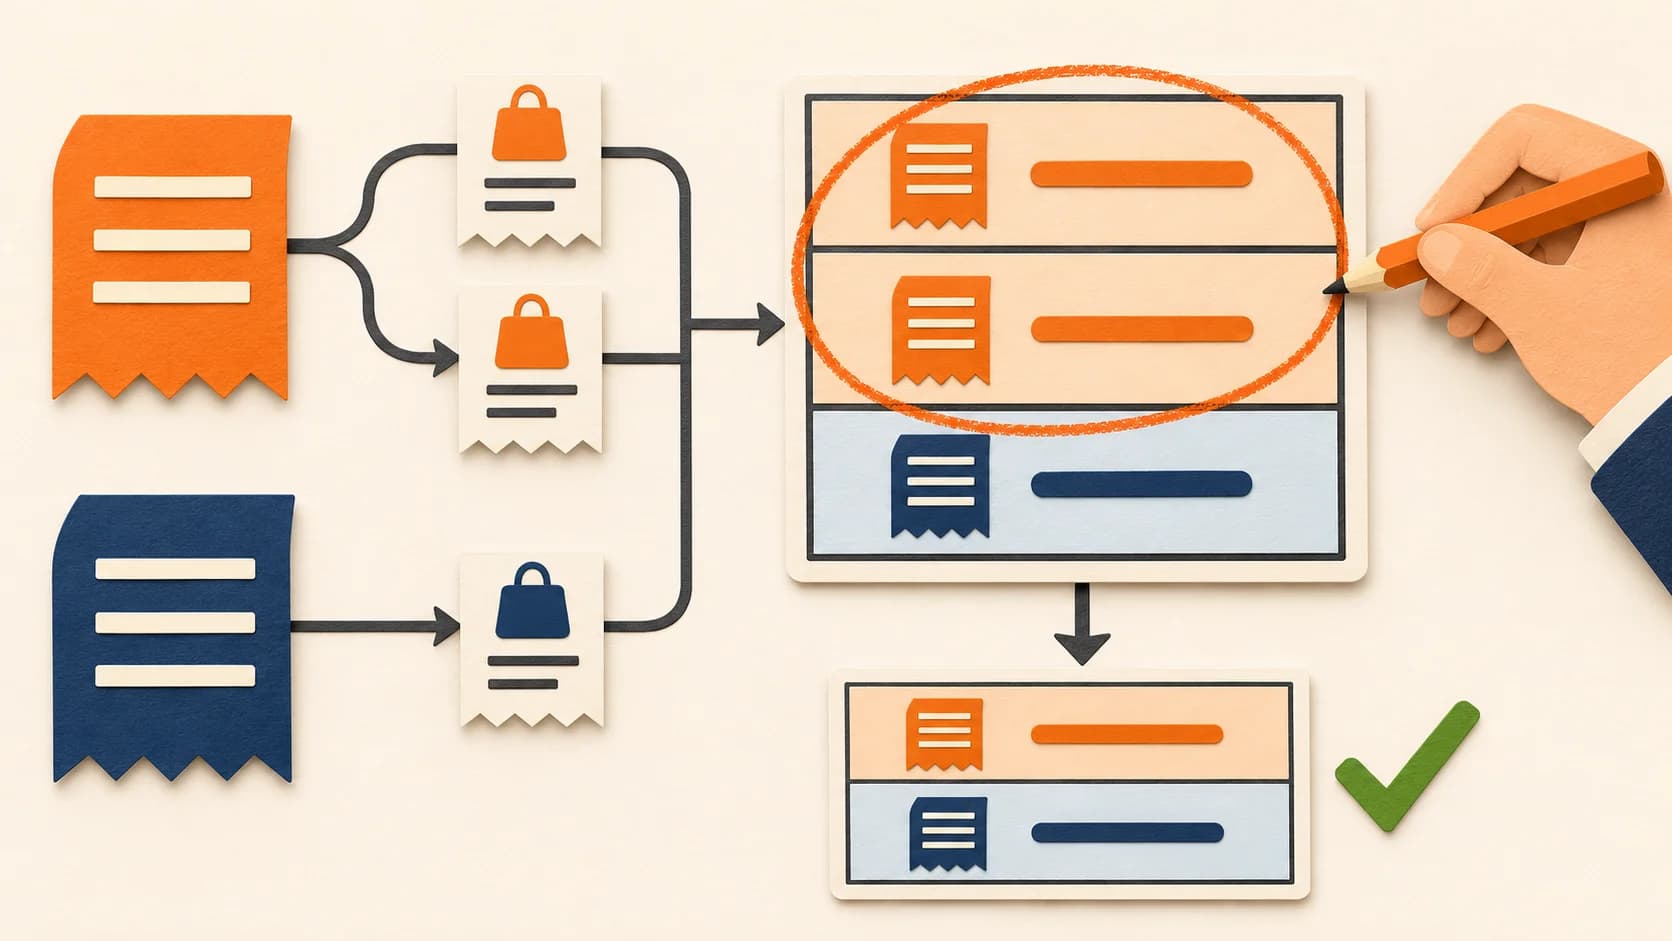
Если сумма или средний чек в ИИ-отчёте расходится с исходными данными, сначала найдите строки, на которых выполнен расчёт. Соединение таблиц может повторить заказ несколько раз, среднее по филиалам — потерять вес каждого филиала, а пропущенная сумма — изменить знаменатель. Просьба к модели «пересчитать внимательнее» не исправляет эти правила автоматически.
Этот FAQ — для аналитика, владельца отчёта и руководителя, которому ИИ помогает готовить SQL-запросы к базе данных. SQL — язык запросов; здесь рассматриваются суммы, количество заказов, средний чек и доли. Подготовка файлов Excel, настройка агента и бухгалтерское признание выручки требуют отдельных решений.
Материал подготовила AI студия Владимира Ломтева; предпоследний раздел описывает услуги издателя. Документация PostgreSQL 18 проверена 15 ноября 2026 года. Все числовые ситуации ниже вымышленные. SQL-блоки — предлагаемые примеры для описанной схемы: в PostgreSQL и на данных компании они не запускались. Материал не измеряет точность какой-либо модели ИИ.
Содержание
- С чего начать, если ИИ и привычный отчёт показывают разные числа?
- Почему JOIN увеличил сумму заказов?
- Можно ли убрать повторный учёт через SUM DISTINCT?
- Почему COUNT показывает больше заказов, чем есть на самом деле?
- Почему среднее средних не равно общему среднему чеку?
- Как NULL и нули меняют результат?
- Почему доля по всей компании отличается от среднего процентов отделов?
- Может ли расхождение объясняться округлением или датой?
- Что написать ИИ, чтобы исправить расчёт, а не получить новое число наугад?
С чего начать, если ИИ и привычный отчёт показывают разные числа?
Сравните состав строк, единицу расчёта и формулу, затем ищите расхождение в арифметике. Единица расчёта, или гранулярность, отвечает на вопрос: что означает одна запись — заказ, товарная позиция, платёж или клиент. Если в одном отчёте строка означает заказ, а в другом позицию, одинаковое название колонки «Сумма» ещё не делает расчёты сопоставимыми.
Попросите у исполнителя запроса небольшой разрешённый фрагмент именно тех данных, которые поступили в агрегирование. Агрегирование — сведение множества значений в итог, например сумму или среднее. В SQL набор строк последовательно формируется через FROM, соединения и фильтры; группировка работает с получившимся набором. Это документированный порядок обработки табличного выражения: PostgreSQL: Table Expressions.
| Наблюдаемое расхождение | Рабочая гипотеза | Что сопоставить |
|---|---|---|
| Сумма выросла после добавления товарных атрибутов | Заказ повторился при соединении с позициями | Идентификаторы заказов до и после соединения |
| Заказов больше, чем в CRM | Посчитаны строки позиций | Строки и уникальные идентификаторы заказов |
| Общий средний чек отличается от среднего по филиалам | Филиалы получили одинаковый вес | Сумму и число заказов каждого филиала |
| Среднее изменилось после «заполнения пустых» | Пропуски стали нулями | Число известных сумм и правило заполнения |
| Итоги по дням различаются | Выбраны другая дата или часовой пояс | Поле даты, границы периода и пояс |
Это гипотезы для локализации, а не диагноз по одному скриншоту. Если SQL и его фактический результат совпадают с согласованным расчётом, а число в текстовом ответе ИИ другое, проверяйте уже перенос результата в ответ. Если расходится сам результат SQL, исправлять нужно запрос или определение показателя.
Почему JOIN увеличил сумму заказов?
JOIN соединяет строки таблиц. Если одному заказу соответствуют несколько позиций, сумма заказа может появиться в результате несколько раз. По документации PostgreSQL, INNER JOIN создаёт строку для каждого подходящего сочетания записей: правила соединений.
Учебные исходные данные: в таблице orders две записи. Заказ A стоит 1 000 ₽, заказ B — 3 000 ₽. В таблице order_items у A две позиции, у B одна. orders.id уникален, а order_items.order_id ссылается на заказ.
| Строка после соединения | Сумма из orders |
|---|---|
| A — позиция 1 | 1 000 ₽ |
| A — позиция 2 | 1 000 ₽ |
| B — позиция 1 | 3 000 ₽ |
| Сумма трёх строк | 5 000 ₽ |
По двум исходным заказам сумма равна 4 000 ₽. Разница 1 000 ₽ возникла из-за повторения A. Ниже — пример запроса с такой ошибкой:
SELECT SUM(o.total_rub)
FROM orders AS o
JOIN order_items AS i ON i.order_id = o.id;
Если задача — сложить суммы всех заказов, в этом примере достаточно orders: присоединять позиции незачем. Если нужны только заказы, содержащие товар категории service, можно предложить проверку существования подходящей позиции:
SELECT SUM(o.total_rub)
FROM orders AS o
WHERE EXISTS (
  SELECT 1
  FROM order_items AS i
  WHERE i.order_id = o.id
    AND i.category = 'service'
);
EXISTS отвечает, найдена ли хотя бы одна строка; несколько подходящих позиций не размножают внешний заказ. Такое поведение описано в PostgreSQL: Subquery Expressions. Здесь считается полная сумма заказов с услугой, включая остальные позиции. Для суммы только самих услуг нужны суммы соответствующих позиций и другая формула. Подмена этих задач снова даст неверный бизнес-ответ.
Можно ли убрать повторный учёт через SUM DISTINCT?
Не используйте уникальность суммы как замену уникальности заказа. SUM(DISTINCT total_rub) оставляет разные значения выражения, а не разные заказы. Это следует из определения DISTINCT внутри агрегата: PostgreSQL: Aggregate Expressions.
Контрпример: два независимых заказа C и D стоят по 1 000 ₽. Их общая сумма — 2 000 ₽. Но множество уникальных сумм содержит единственное значение 1 000, поэтому SUM(DISTINCT total_rub) даст 1 000 ₽. На предыдущих заказах A и B такой приём случайно скрывал бы размножение; на одинаковых чеках он теряет настоящую продажу.
Устранение повторов должно опираться на идентичность сущности и происхождение дубля. Для расчёта по заказам восстановите одну запись на ключ заказа либо используйте условие существования, если позиции нужны только для отбора. Если у одного ключа заказа уже в источнике разные суммы, сначала выясните, являются ли записи версиями, платежами или ошибкой загрузки. Произвольный выбор одной суммы скроет эту проблему.
Почему COUNT показывает больше заказов, чем есть на самом деле?
COUNT(*) считает строки. COUNT(поле) считает строки с непустым значением этого поля, а COUNT(DISTINCT поле) — различные непустые значения. Это разные вопросы к одному набору данных: описание COUNT.
В примере с заказами A и B после соединения есть три строки, но два уникальных идентификатора заказа. Поэтому COUNT(*) даст 3, а COUNT(DISTINCT o.id) — 2. Второе выражение отвечает на вопрос о числе заказов, если id действительно является их ключом в рассматриваемой системе.
Однако правильное количество заказов не исправляет соседнюю сумму. Выражение SUM(o.total_rub) / COUNT(DISTINCT o.id) на том же соединении поделит ошибочные 5 000 ₽ на 2 и даст 2 500 ₽ за заказ. По исходным двум заказам средний чек равен 4 000 / 2 = 2 000 ₽. Числитель и знаменатель должны относиться к одной согласованной совокупности.
Отдельный случай — LEFT JOIN, сохраняющий заказ без подходящих позиций. В его результирующей строке поля позиции будут NULL, то есть значение отсутствует. Тогда COUNT(*) учитывает сохранённую строку, а COUNT(i.id) её не учитывает. Правило добавления таких строк описано в документации LEFT OUTER JOIN.
Почему среднее средних не равно общему среднему чеку?
Филиалы могут иметь разное количество заказов. Среднее их средних придаёт каждому филиалу одинаковый вес, хотя задача «средний чек всех заказов» придаёт одинаковый вес каждому заказу.
Возьмём отдельный учебный набор, не связанный с заказами A и B:
| Филиал | Число заказов | Сумма заказов | Средний чек |
|---|---|---|---|
| Север | 1 | 1 000 ₽ | 1 000 ₽ |
| Юг | 3 | 9 000 ₽ | 3 000 ₽ |
| Вместе | 4 | 10 000 ₽ | 2 500 ₽ |
Среднее двух средних равно (1 000 + 3 000) / 2 = 2 000 ₽. Общий средний чек равен (1 000 + 9 000) / (1 + 3) = 2 500 ₽. Если доступны только готовые групповые показатели, храните рядом сумму и число заказов. По округлённым средним без весов исходный общий результат может быть невосстановим.
Одинаковый вес филиалов бывает осмыслен сам по себе — например, когда именно он определён в задаче сравнения подразделений. Но такой показатель следует назвать средним по филиалам. Для общего среднего чека предложите ИИ формулировку: «Раздели общую сумму подходящих заказов на их общее количество; не усредняй средние чеки групп».
Как NULL и нули меняют результат?
Отсутствующая сумма и известная нулевая сумма означают разные состояния. PostgreSQL исключает NULL из входов AVG и SUM; сумма пустого набора возвращает NULL, а не автоматически ноль. Эти правила зафиксированы в документации агрегатных функций.
Для значений 1 000, NULL, 0 известны две суммы. Среднее известных значений — 500 ₽. Если заменить пропуск нулём до усреднения, получится 1 000 / 3 ≈ 333,33 ₽. Это уже предположение о неизвестной операции, а не косметическое оформление.
Попросите ИИ отдельно вывести число строк и число известных сумм. Если показатель требует полного набора, пропуск может означать, что итог пока нельзя публиковать. Если владелец данных подтвердил, что отсутствие значения действительно кодирует нулевую сумму, замену можно включить в правило расчёта. Решение зависит от смысла поля.
Также различайте отсутствие подходящих операций и отсутствие загрузки за период. Отображение нуля вместо пустого результата не доказывает, что данные пришли полностью. Для этого нужен отдельный признак готовности источника.
Почему доля по всей компании отличается от среднего процентов отделов?
У долей тоже есть веса: их задаёт знаменатель. Если отделы обрабатывают разное число заявок, среднее двух процентов и доля успешных заявок среди всех заявок отвечают на разные вопросы.
В учебном примере отдел X выполнил 100 из 1 000 заявок — 10%. Отдел Y выполнил 90 из 300 — 30%. Среднее процентов равно 20%, но общая доля составляет 190 / 1 300 × 100 ≈ 14,62%. В общей формуле складываются числители и соответствующие знаменатели. Категории здесь предполагаются непересекающимися, с одинаковым определением успешной заявки.
Если одна заявка попала в оба отдела, сначала определите, считаете ли вы уникальные заявки или участия отделов в обработке. Складывать такие знаменатели без оговорки уже нельзя. Если у группы знаменатель равен нулю, процент по ней требует отдельного правила представления; ноль процентов и неопределённая доля не тождественны.
Для SQL дополнительно проверьте тип деления. PostgreSQL при делении целых чисел отбрасывает дробную часть, поэтому долю нельзя бездумно записывать как отношение двух целочисленных счётчиков. Предусмотрите десятичный тип, например приведение числителя к numeric, до деления и обработку нулевого знаменателя: математические операторы PostgreSQL.
Может ли расхождение объясняться округлением или датой?
Да, но сначала отделите небольшую разницу представления от изменения самого состава расчёта. Для каждого объяснения должен найтись конкретный механизм.
Округление отдельных строк и округление общей суммы могут дать разные итоги. Например, три учебных значения по 0,335 ₽ при округлении каждого до двух знаков дадут по 0,34 ₽, вместе 1,02 ₽. Их точная сумма 1,005 ₽ при округлении один раз до двух знаков даст 1,01 ₽. Этот пример предполагает правило округления половины от нуля. В PostgreSQL оно действует для numeric; типы real и double precision имеют неточное представление, а правила округления могут отличаться. См. Numeric Types.
Переход к numeric помогает явно задать десятичную арифметику, но не определяет за компанию момент округления. Согласуйте, округляются ли позиции, документы или только финальный показатель. Даже точный тип с заданным числом знаков может округлить значение при записи.
Для периода отдельно проверьте поле события: создание заказа, оплату или отгрузку. Затем сравните часовые пояса и границы. Например, 14 ноября 2026 года в 23:30 UTC — это 15 ноября в 02:30 при UTC+03:00. Одна операция может попасть в разные календарные дни. PostgreSQL преобразует вывод timestamp with time zone в текущий пояс сессии; исходный пояс ввода внутри этого значения не сохраняется: Date/Time Types.
В предлагаемом правиле периода используйте начало включительно и начало следующего периода исключительно, в явно выбранном поясе. Так соседние интервалы можно определить без общей граничной точки. Это рекомендация к постановке задачи; конкретный SQL зависит от типа и смысла поля даты.
Что написать ИИ, чтобы исправить расчёт, а не получить новое число наугад?
Передайте структуру таблиц, ключи и определение показателя. Попросите сначала показать, как формируется набор строк, и только затем предложить исправление. Сами названия orders и order_items не доказывают, что одна строка в них означает именно то, что ожидает модель.
Ниже — предлагаемый запрос к ИИ для вымышленной схемы. Это шаблон постановки задачи; его результат на конкретной модели не проверялся:
Разбери расхождение среднего чека в SQL, который я приложу.
orders: id — уникальный ключ заказа, total_rub — известная сумма
полного заказа в рублях. Одна запись = один заказ.
order_items: order_id — ссылка на orders.id, category — категория.
У заказа может быть несколько позиций.

Нужен средний чек полных заказов, где есть хотя бы одна позиция service.
Все суммы в одной валюте. Рассматриваем уже согласованный набор orders;
дополнительные фильтры периода и статуса сейчас не добавляй.
Покажи, какие строки создаёт JOIN и где повторяется сумма заказа.
Предложи вариант отбора без размножения заказов.
Отдельно выведи число заказов, сумму и формулу среднего чека.
Не считай сумму только service-позиций: нужна полная сумма заказа.
Если схема или смысл показателя неоднозначны, перечисли вопросы.
Не выполняй запросы и не изменяй данные.
Для продолжения приложите фактический SQL и разрешённый небольшой пример с ключами. Если исходный запрос показать нельзя, попросите объяснить принцип на синтетических строках. До выполнения предложенного SQL аналитик должен проверить схему, доступные данные и смысл результата; текстовое «не изменяй» само по себе не задаёт технических прав.
Для постоянных отчётов полезно закрепить формулу и допустимые связи в управляемой модели данных. Этот следующий уровень описан в статье о семантическом слое для ИИ-аналитики. Если расхождение возникло ещё при чтении книги, вернитесь к материалу о формулах и листах Excel для ИИ.
Как студия помогает связать ИИ с расчётами компании
AI студия Владимира Ломтева занимается подготовкой данных, разработкой MVP, интеграцией и тестированием ИИ с бизнес-системами. Для аналитических отчётов эти работы могут включать:
- подготовку таблиц с согласованными ключами, уровнем детализации и определениями показателей;
- разработку и тестирование MVP, в котором ИИ обращается к согласованному расчёту и возвращает пояснение к его результату;
- интеграцию такого процесса с корпоративными источниками данных.
Первый шаг — выбрать один отчёт с расхождением, назвать его владельца, текущий способ расчёта, источники и ограничения доступа, определить нужный результат. Например, согласовать, что именно считается заказом и какой средний чек должен получаться на разрешённом наборе записей. Обсудить задачу.
Итог: как локализовать расхождение
Начните с одного спорного числа и строк, из которых оно получено. Найдите повторение ключей после соединения, проверьте общую совокупность числителя и знаменателя, различите пропуск и ноль, затем разберите округление и период. Исправление должно объяснять разницу конкретными записями или правилом вычисления. После этого переносите согласованный результат в текст ИИ-отчёта.