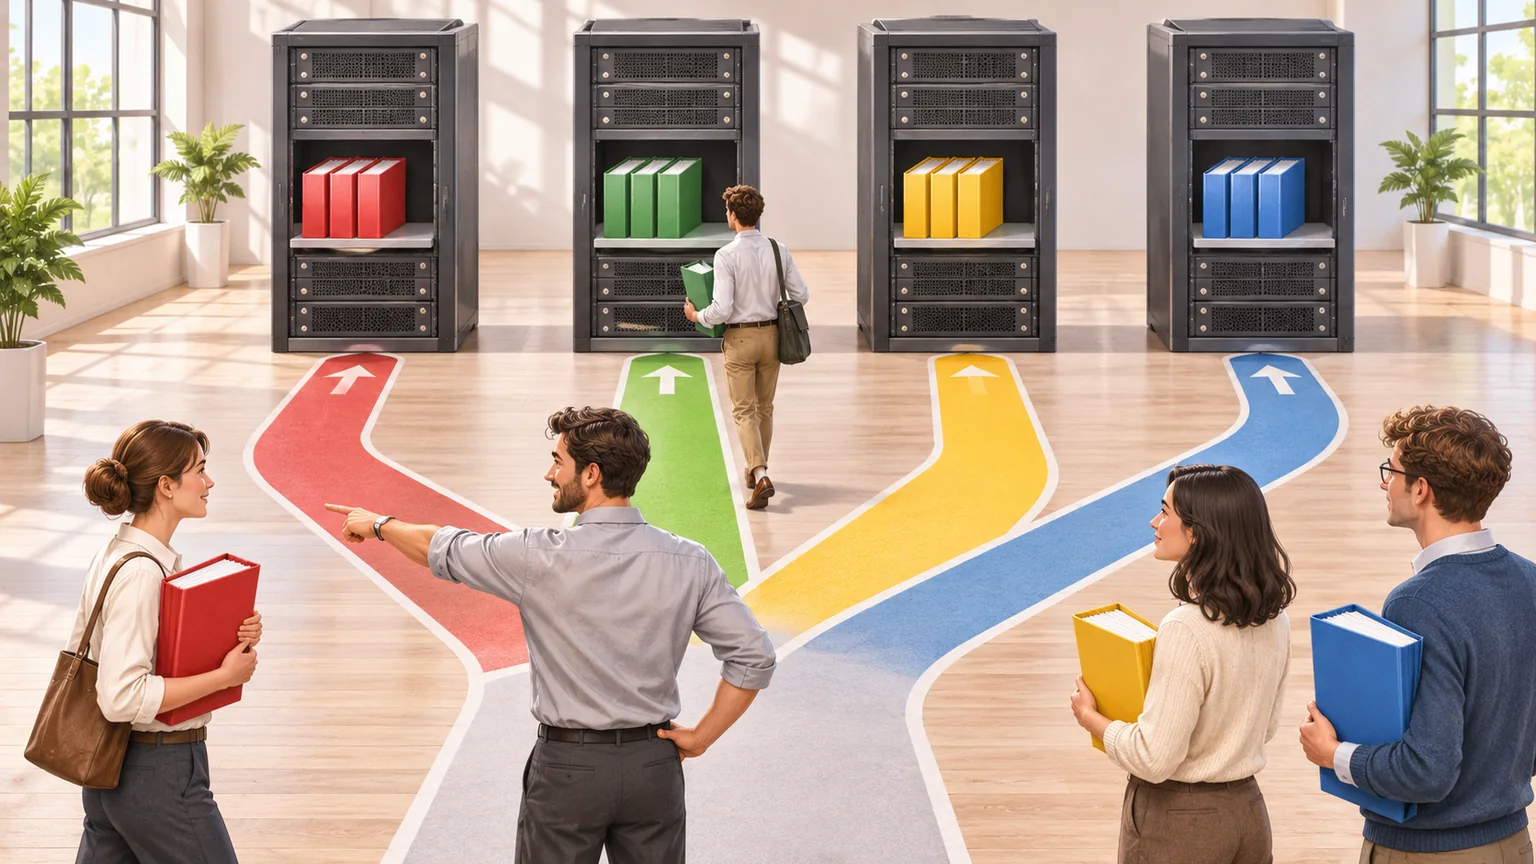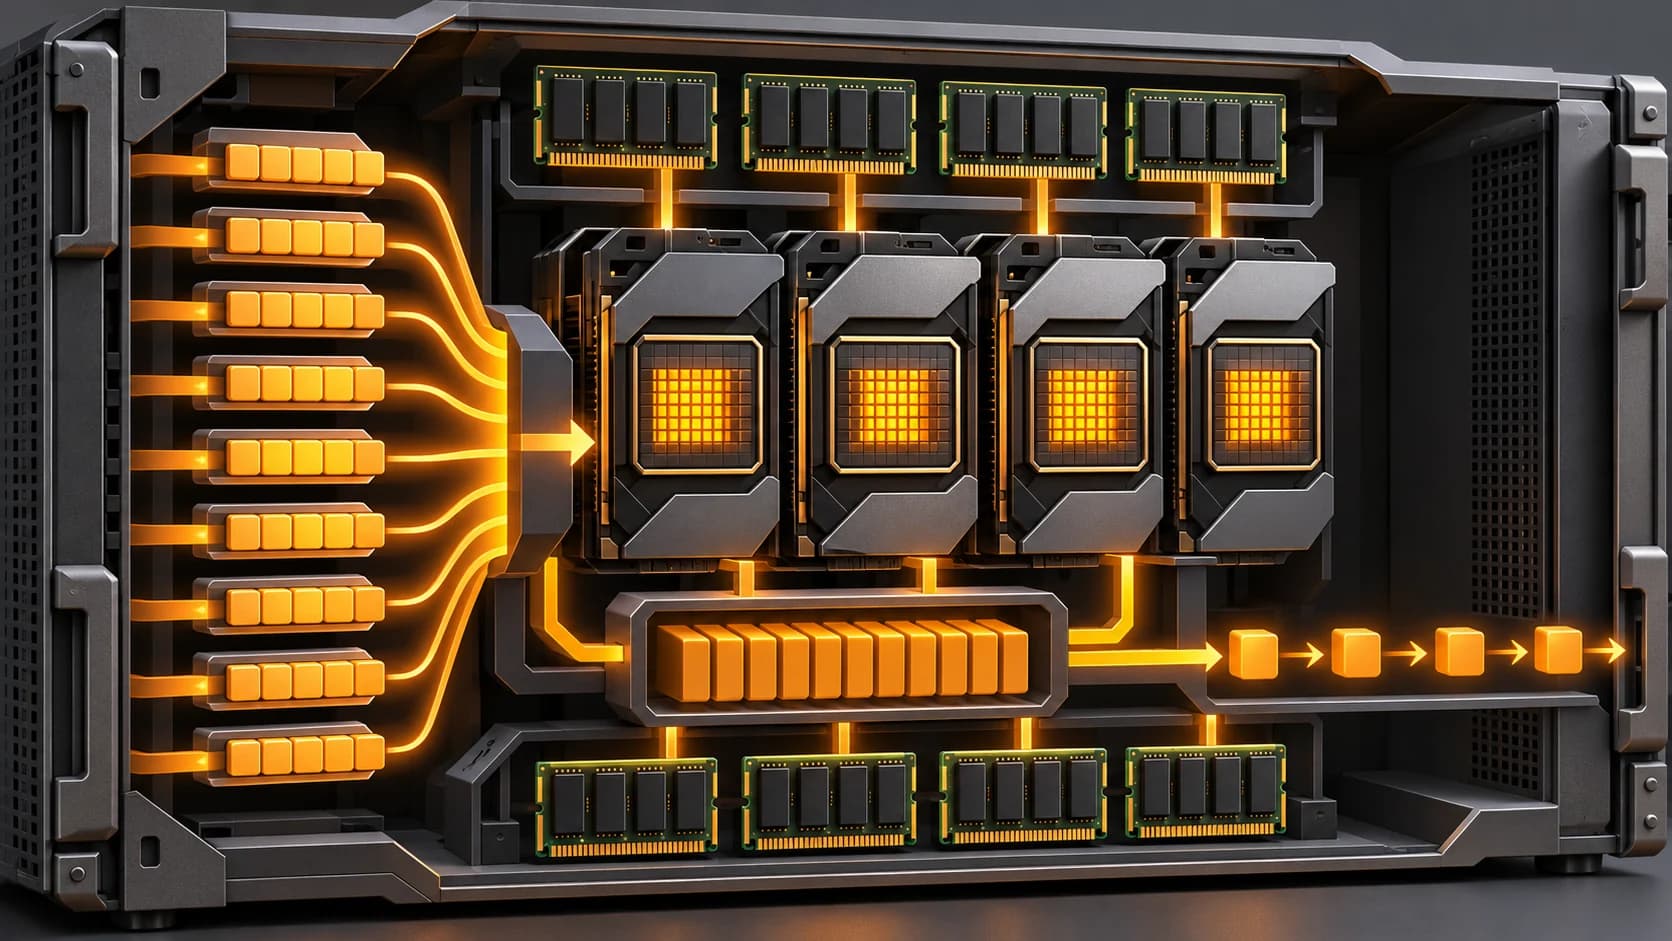
Ускорение инференса LLM начинается с определения узкого места: чтение входа, генерация, память, очередь или обмен между GPU. Движок управляет исполнением модели, выделением памяти и планированием запросов. Один и тот же метод может повысить общую пропускную способность и одновременно ухудшить задержку отдельного пользователя, поэтому выбирать настройки нужно под измеряемую цель.
Материал подготовила AI студия Владимира Ломтева 14 ноября 2026 года для разработчиков, инженеров платформ и руководителей технических команд. Это технический обзор механизмов и порядка оптимизации текстовых LLM по документации проектов. Собственные сравнительные замеры движков не проводились; универсального рейтинга скорости и гарантированных коэффициентов ускорения здесь нет. Конкретные параметры запуска сверяйте с закреплённой версией вашего сервера.
Содержание
- Что делает движок инференса
- Две фазы: prefill и decode
- Какие метрики ускорять
- Как выбирать между движками
- KV-cache: не пересчитывать прошлое
- PagedAttention: управление размещением кэша
- Continuous batching: заполнять вычислительный шаг работой
- Prefix caching: повторно использовать общий вход
- FlashAttention и вычислительные ядра
- Квантование: меньше данных, но другой путь вычислений
- Speculative decoding: предложения с проверкой
- Несколько GPU: разделение модели или дополнительные копии
- Разделение prefill и decode
- Порядок оптимизации работающего сервиса
- Частые ошибки при ускорении инференса
- Частые вопросы
Что делает движок инференса
Движок загружает веса, исполняет операции модели, поддерживает состояние генерации и использует вычислительные библиотеки выбранного оборудования. Серверный слой принимает сетевые запросы, объединяет их в работу планировщика и возвращает результат приложению. В одном проекте оба слоя могут поставляться вместе.
Полезно различать четыре объекта: модель, формат её артефактов, среду исполнения и пользовательский интерфейс. GGUF — формат файла, а не самостоятельный сервер. Open WebUI — интерфейс, а не замена GPU-вычислениям. Ollama предлагает удобный путь управления моделями и API, тогда как llama.cpp, vLLM, SGLang и TensorRT-LLM решают задачи исполнения с разными приоритетами.
Выбор не сводится к количеству звёзд проекта. Сначала проверяют поддержку архитектуры модели, оборудования и нужных функций. Затем — качество ответа и поведение при рабочей нагрузке. Обзор назначения основных вариантов уже есть в сравнении vLLM, Ollama, llama.cpp и SGLang; ниже внимание сосредоточено на механизмах ускорения.
Две фазы: prefill и decode
Во время prefill модель обрабатывает входной контекст и готовит состояния, необходимые для продолжения. Длинный документ может занимать значительное время ещё до появления первого символа ответа. Во время decode модель последовательно выбирает следующие токены, используя уже обработанный контекст.
Разделение объясняет, почему нельзя оценить сервис одной цифрой «токенов в секунду». Короткий вопрос с длинным ответом и длинный документ с короткой меткой создают разные профили работы. Метод, уменьшающий повторное чтение входа, может почти не изменить скорость выдачи длинного ответа. Архитектуру фаз и связь с памятью описывает NVIDIA в руководстве по оптимизации LLM-инференса.
Для диагностики добавьте третью составляющую — ожидание в очереди. Пользователь видит время от отправки запроса, а не от фактического начала вычислений. Быстрый decode не помогает, если запрос долго не допускается к исполнению.
Какие метрики ускорять
| Метрика | Что показывает | Когда особенно полезна |
|---|---|---|
| TTFT | Время до первого токена | Чаты, длинный вход, перегруженная очередь |
| TPOT или ITL | Время на последующие токены или интервалы выдачи | Удобство чтения потокового ответа |
| Полная задержка | Время до завершения запроса | Извлечение полей и автоматические процессы |
| Throughput | Объём успешно обработанной работы за время | Пакетные задания и общий ресурс сервера |
| Goodput | Работа, завершённая с выполнением выбранных SLO | Планирование производственной мощности |
| Доля ошибок | Отказы, тайм-ауты и некорректные результаты | Любая приёмка оптимизации |
В отчёте уточняйте определение метрики и границы измерения. Например, TTFT от клиента включает сетевые и серверные задержки; значение внутри движка может начинаться позже. Среднее дополняйте квантилями, чтобы не скрыть медленные запросы. Квантили разных составляющих нельзя просто складывать для получения квантиля полного времени.
Как выбирать между движками
| Вариант | Что исследовать в первую очередь | Основная проверка перед использованием |
|---|---|---|
| llama.cpp | GGUF, CPU/GPU-размещение, локальный сервер | Поддержка модели и backend, баланс памяти и скорости |
| Ollama | Быстрый запуск, загрузка и удержание модели, API | Реальное размещение модели и поведение под параллельной нагрузкой |
| vLLM | Планировщик, память KV-cache, многопользовательское обслуживание | Поддержка модели, формат весов, SLO на вашем потоке |
| SGLang | Повторяющиеся контексты, кэширование и серверные настройки | Эффект выбранной конфигурации на задержку и память |
| TensorRT-LLM | Оптимизация под поддерживаемый стек NVIDIA | Совместимость аппаратуры, модели и выбранного пути развёртывания |
Это карта экспериментов, а не рейтинг. Название движка не определяет победителя без версии, модели, оборудования и профиля запросов. В документации llama.cpp server описан собственный серверный путь; у SGLang есть руководство по настройке памяти и производительности.
Для честного сравнения сохраните одинаковые входные тексты, ограничения выхода и правила оценки. Проверьте токенизатор и chat template. Если один вариант использует квантизацию, другой — более точные веса, а третий — дополнительный draft, вы сравниваете конфигурации систем. Это допустимо, но должно быть явно указано.
KV-cache: не пересчитывать прошлое
KV-cache хранит ключи и значения механизма внимания для уже обработанных токенов. Он помогает продолжать генерацию без полного пересчёта соответствующих состояний прошлого контекста. Плата за это — память, которая зависит от архитектуры модели и длины активных последовательностей.
Размер файла весов не описывает всю потребность сервера в VRAM. Одновременно обслуживаемые диалоги требуют своих состояний. Увеличение контекста и параллельности может привести к нехватке памяти даже без изменения самой модели. Поэтому ускорение за счёт большого числа запросов нужно согласовывать с бюджетом KV-cache.
Некоторые архитектуры используют сжатые или гибридные состояния, поэтому простая формула для обычного attention неприменима ко всем моделям. Сначала прочитайте конфигурацию архитектуры, затем используйте оценки движка и фактические измерения. При необходимости начинайте с отдельного расчёта памяти модели.
PagedAttention: управление размещением кэша
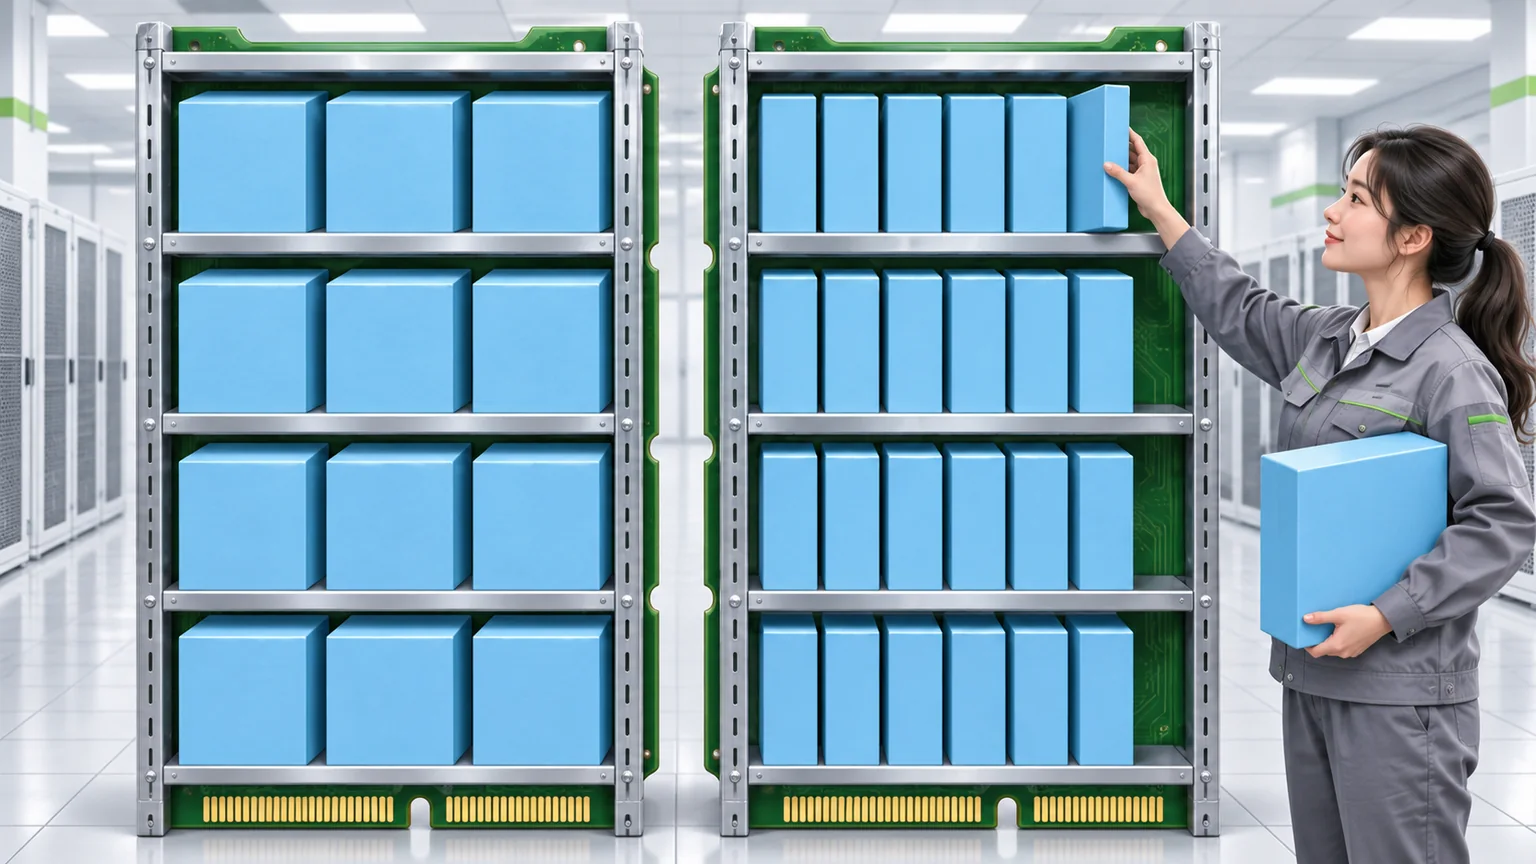
PagedAttention организует работу с KV-cache через блоки, позволяя логической последовательности использовать физически несмежную память. Идея связана с управлением памятью: не требуется резервировать один непрерывный участок под максимальную длину каждого запроса. Это помогает эффективнее использовать доступный ресурс при переменной длине последовательностей.
Не следует описывать PagedAttention как сжатие весов или универсальное сокращение вычислений модели. Его задача отличается от квантования. Оптимальное размещение кэша может позволить обслуживать больше работы, но само по себе не обещает одинакового ускорения каждого одиночного запроса. Механизм изложен в работе авторов PagedAttention.
При оценке эффекта смотрите на нагрузку, близкую к рабочей: разные длины диалогов, завершение запросов в разное время, повторяющиеся и уникальные входы. Набор из одинаковых коротких промптов может не показать проблемы, которые возникают в реальном чате.
Continuous batching: заполнять вычислительный шаг работой
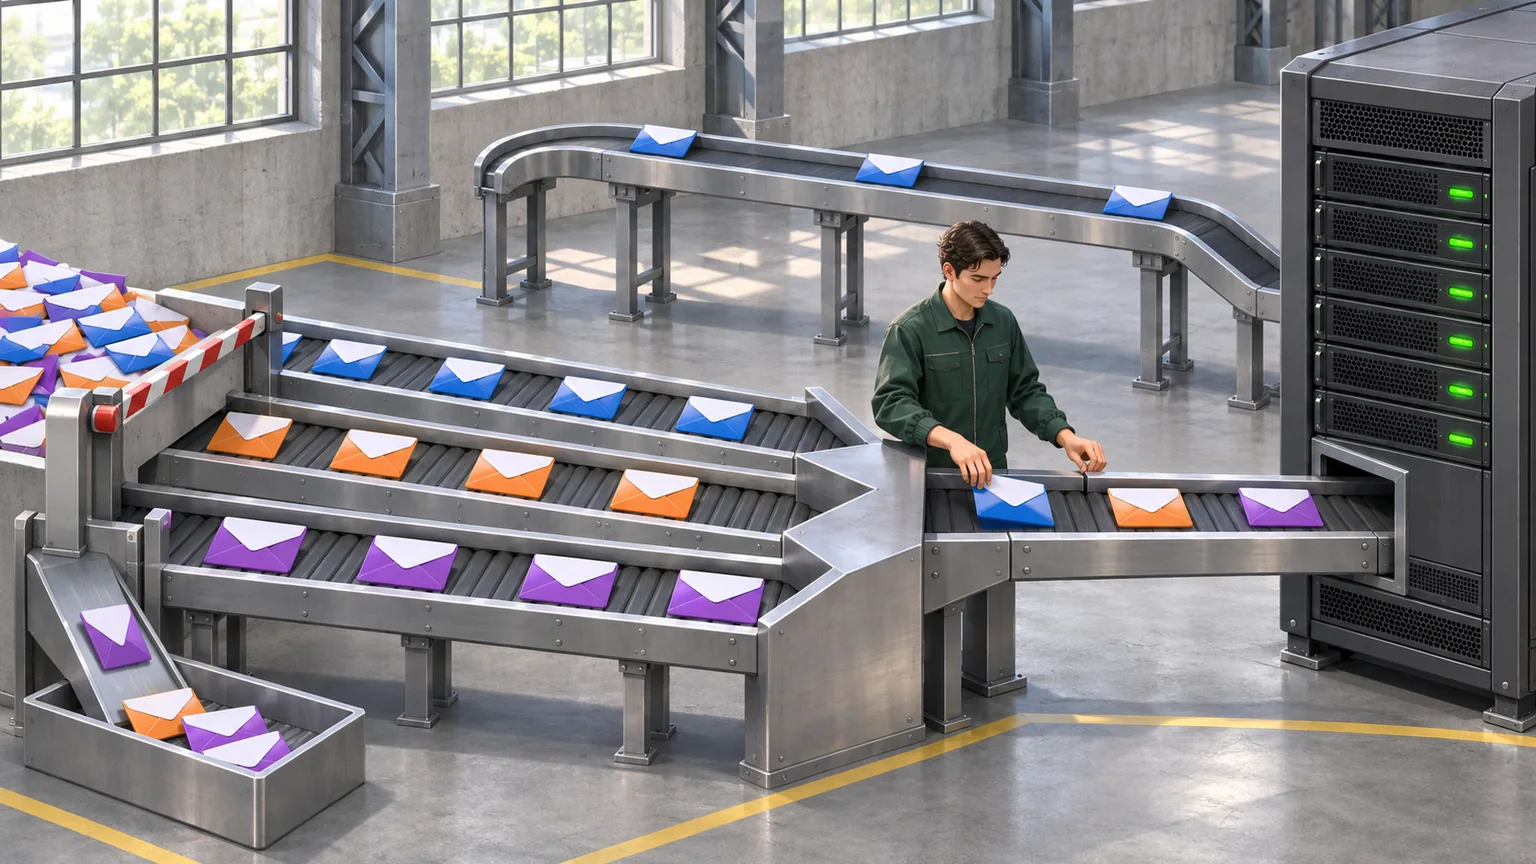
При обычной последовательной обработке новый запрос ждёт завершения предыдущего. Батчинг объединяет работу нескольких запросов. Непрерывный батчинг позволяет планировщику менять состав активной группы по мере завершения и поступления последовательностей, чтобы ресурс не простаивал из-за разных длин ответов.
Пользовательская параллельность и размер вычислительной группы связаны, но не тождественны. Можно принять много сетевых соединений и держать их в очереди. Можно увеличить допуск к исполнению и получить более высокий throughput, но одновременно повысить конкуренцию за память и время отдельных запросов.
Для ночной разметки архива допустима более длинная задержка ради общего объёма. Для голосового интерфейса пауза до ответа может быть критична. Поэтому настройку планировщика выбирают через целевое SLO, а не по максимальному числу одновременных запросов в конфигурации.
Prefix caching: повторно использовать общий вход
Если запросы начинаются с одинаковой последовательности токенов, сервер может повторно использовать вычисленные состояния общего префикса. Это полезно для длинной системной инструкции, повторных вопросов по одному документу и некоторых многошаговых сценариев. Документация vLLM Automatic Prefix Caching отдельно описывает область применения и ограничения.
Практическое следствие для приложения — стабильные части запроса стоит располагать осмысленно. Если перед общим документом каждый раз вставлять уникальное время или идентификатор, область совпадения может сократиться. При этом нельзя переставлять данные только ради кэша, если это меняет инструкции, порядок диалога или смысл задачи.
Отличайте prefix cache от кэша готовых ответов. Первый повторно использует вычисления входа и продолжает генерацию, второй возвращает сохранённый результат. Для готовых ответов отдельно нужны правила свежести данных, прав доступа и допустимости повторного использования.
FlashAttention и вычислительные ядра
FlashAttention меняет организацию вычисления внимания и обмена с памятью, используя разбиение работы на блоки. Его цель — уменьшить дорогие перемещения данных для поддерживаемых условий. Это оптимизация алгоритма исполнения attention, а не новая обученная языковая модель. Механизм изложен в исходной работе FlashAttention.
Наличие слова FlashAttention в описании сервера не доказывает, что конкретный запрос использует нужный backend. Выбор зависит от оборудования, точности, архитектуры и версии библиотек. Логи запуска и профилирование полезнее предположения «функция включена по умолчанию».
Кроме attention на скорость влияют матричные операции, fusion ядер, компиляция и накладные расходы запуска. Для небольшого потока стоимость подготовки может быть заметнее выигрыша от оптимизации. Для постоянно работающего сервиса полезно отдельно измерять холодный запуск и установившийся режим.
Квантование: меньше данных, но другой путь вычислений
Квантование уменьшает точность представления определённых чисел. Оно может относиться к весам, активациям или KV-cache; это разные объекты с разными последствиями. Компактные веса позволяют разместить модель на меньшем объёме памяти, однако реальная скорость зависит от поддержки соответствующих вычислительных ядер.
Если формат приходится преобразовывать во время работы, выигрыш по объёму не обязательно превращается в выигрыш по задержке. Сравнивайте пары «формат плюс backend» на одном задании и отдельно контролируйте качество. Особенно внимательно проверяйте извлечение чисел, русский язык, формат JSON и вызовы инструментов.
Для подготовки артефактов есть отдельная инструкция по квантованию и GGUF. В плане оптимизации разумно сначала выяснить, ограничивает ли вас память. Если сервер и так помещается, а задержка вызвана очередью внешнего инструмента, смена точности весов не устранит исходную причину.
Speculative decoding: предложения с проверкой
Speculative decoding использует механизм предложения нескольких будущих токенов и их проверки основной моделью. Предложения могут формироваться отдельной моделью или архитектурно связанным способом. Выигрыш зависит от стоимости предложения, доли принятых токенов и режима нагрузки. Понятие не означает, что сервер без проверки выдаёт ответ более слабой модели.
В документации vLLM по speculative decoding описаны поддерживаемые варианты и ограничения. Конкретный набор функций меняется между выпусками, поэтому переносить конфигурацию из случайного примера без проверки версии нельзя.
Рассматривайте метод как отдельный эксперимент. Зафиксируйте память, TTFT, время генерации и качество до изменения. Добавьте механизм предложения, повторите тот же поток и сравните. Если дополнительная модель отнимает память у рабочих последовательностей, выигрыш одиночного ответа может сопровождаться потерей общей мощности.
Несколько GPU: разделение модели или дополнительные копии
Tensor parallelism распределяет части операций модели между ускорителями. Pipeline parallelism делит исполнение по стадиям. Реплики позволяют обслуживать независимые запросы отдельными копиями модели. Для MoE дополнительно существует expert parallelism, связанный с размещением экспертов.
Одна большая модель, которая не помещается на устройство, и много коротких независимых запросов требуют разных решений. В первом случае разделение помогает разместить вычисление. Во втором несколько отдельных копий иногда лучше соответствуют задаче, но это следует проверить. Число GPU само по себе не задаёт результат.
Учитывайте межсоединение: обмен между устройствами и узлами входит в стоимость шага. Дополнительный GPU не превращается автоматически в такое же количество дополнительной скорости. Подходы и ограничения описаны в руководстве vLLM по параллелизму и масштабированию.
Разделение prefill и decode
При раздельном обслуживании фазы обработки входа и генерации размещают на разных ресурсах. Это позволяет управлять их очередями и профилями мощности отдельно. Одновременно появляется необходимость передавать состояния, согласовывать планирование и наблюдать больше компонентов.
Такой подход имеет смысл рассматривать после измерений, когда смешанный поток действительно мешает выполнять SLO. Для небольшого сервиса сложность может превысить практическую пользу. В документации TensorRT-LLM Disaggregated Serving показана архитектура передачи KV-cache между фазами.
Не начинайте оптимизацию с распределённой системы, если ещё не проверены длина входа, параметры одного сервера и фактическая очередь. Разделение фаз не исправляет неудачную модель, лишние документы в промпте или бесконечные повторы на уровне приложения.
Порядок оптимизации работающего сервиса
- Зафиксируйте артефакты модели, движок, оборудование и текущие настройки.
- Выберите метрику и предел: например, задержку первого токена при согласованной нагрузке.
- Разделите полное время на подготовку данных, очередь, prefill, decode и внешние операции.
- Проверьте длину контекста, ненужный выход и повторные запросы приложения.
- Изменяйте один существенный фактор за эксперимент.
- Повторяйте тест на прогретом и холодном состоянии с одинаковыми правилами кэширования.
- Проверяйте корректность ответов, отказы и память вместе со скоростью.
- Сохраняйте конфигурацию победившего варианта и условия отката.
Для записи эксперимента используйте шаблон: «гипотеза → изменение → контрольный поток → метрики → качество → решение». Пустые поля заполняются фактическими данными; заранее придуманного процента ускорения в протоколе быть не должно. Для серверной части подойдёт vLLM Benchmark CLI, для пользовательского пути нужен дополнительный замер приложения.
Частые ошибки при ускорении инференса
Сравнение разных моделей под видом сравнения движков скрывает причину результата. Повторный тест с уже прогретым кэшем может выглядеть как ускорение после настройки. Измерение только успешных запросов скрывает потери из-за тайм-аутов. Одинаковый предел выхода не гарантирует одинаковую фактическую длину ответа.
Другая ошибка — считать потоковую выдачу ускорением вычислений. Streaming помогает раньше показать уже готовую часть, но не обязательно уменьшает полное время генерации. Это полезное изменение интерфейса, которое нужно измерять отдельно от производительности модели.
Наконец, не переносите верхнеуровневый результат вендорского теста на свою систему. Сохраняйте модель, длины последовательностей, batch, точность, оборудование и режим кэша. Без этих условий число не помогает выбрать архитектуру.
Частые вопросы
Какой движок инференса самый быстрый?
Ответ определяется моделью, оборудованием и нагрузкой. Сравнивайте совместимые конфигурации на одном потоке запросов, фиксируя качество, TTFT, полную задержку и throughput.
Можно ли ускорить LLM без замены GPU?
Иногда да: сократить лишний контекст, ограничить выход, исправить очередь, использовать повторяющиеся префиксы и выбрать поддерживаемый формат весов. Сначала нужно установить причину задержки.
Квантование всегда уменьшает качество?
Оно меняет числовое представление и может влиять на результат; степень влияния зависит от метода, модели и задачи. Приёмка на рабочих примерах важнее общего утверждения о числе бит.
Больше запросов одновременно означает быстрее?
Не обязательно. Общий throughput может вырасти, а задержка одного запроса — увеличиться. Приёмку проводят по выбранным SLO и учитывают отказы.
Стоит ли включать все оптимизации сразу?
Нет: тогда сложно установить источник изменения и совместимость функций. Сначала нужна стабильная базовая конфигурация, затем последовательные эксперименты.
Как AI студия Владимира Ломтева помогает с локальной LLM
AI студия Владимира Ломтева может связать развёртывание модели с аудитом процесса, подготовкой контрольных данных и интеграцией в рабочую систему. Для задачи ускорения это означает определить пользовательский критерий, проверить подходящий вариант исполнения и организовать тестирование перед запуском. Эти действия не предполагают заранее обещанного коэффициента ускорения.
Первый шаг — описать один процесс, текущую задержку, состав данных и критерий приемлемого ответа. Обсудить задачу.
С чего начать ускорение
Начните с карты времени и памяти одного рабочего запроса. Для длинного повторяющегося входа исследуйте prefill и кэш; для большой очереди — допуск и batching; для нехватки памяти — контекст, состояния и поддерживаемые способы квантования; для распределённого запуска — обмен между устройствами.
Выбирайте движок по совместимости и результатам своего теста. Успешная оптимизация сохраняет требуемое качество и улучшает выбранную метрику при оговорённой нагрузке. Она должна оставлять воспроизводимую конфигурацию и понятный путь возврата.