Оценка сложности задач и проектов начинается с разделения пяти вещей: функционального размера, сложности реализации, трудозатрат, календарного срока и неопределённости. Один показатель не заменяет остальные. Для обоснованного решения полезно сопоставить требования, поведение интерфейса, свойства существующего кода и возможности команды, а затем построить прогноз выполнения.
COSMIC помогает измерить функциональный размер, IFPUG SNAP дополняет картину нефункциональными требованиями. Cognitive Complexity и Cyclomatic Complexity показывают разные свойства кода. Модель состояний раскрывает сценарии и переходы, матрица экранов помогает сравнивать реализацию, Story Points поддерживают командное планирование, а эвристики Nielsen выявляют проблемы удобства. Их можно использовать совместно, если не складывать несопоставимые единицы в один «объективный балл».
Это подробное руководство для разработчиков, аналитиков, тимлидов, руководителей проектов и заказчиков. Основные примеры относятся к фронтенду: формам, личным кабинетам, редакторам, импорту данных и интеграциям. Принципы применимы шире, но отраслевые нормативы и сметное ценообразование здесь не рассматриваются.
Материал подготовлен для сайта AI-студии Владимира Ломтева. Описание методологий проверено по первоисточникам 29 октября 2026 года. Предлагаемые матрицы и сквозной пример — учебные инструменты статьи. Они не являются результатом исследования, реальным клиентским кейсом или формально выполненным измерением COSMIC/SNAP.
Содержание
- Что именно оценивают
- Сравнение восьми методов
- COSMIC
- IFPUG SNAP
- Cognitive Complexity
- Cyclomatic Complexity
- Состояния и statecharts
- Матрица экранов и компонентов
- Story Points и Planning Poker
- Эвристики Nielsen
- Сквозной пример проекта
- Прогноз сроков
- Шаблон оценки
- Частые вопросы
Что именно оценивают под словом сложность
В обсуждении разработки «сложная задача» может означать совершенно разные ситуации. Требований много. Требований мало, но нужно изобрести алгоритм. Алгоритм известен, но код запутан. Код прост, но доступ к внешней системе появится только после согласования. Для управления это разные проблемы.
Пока участники не договорились о значении оценки, одинаковое число создаёт ложное согласие. Разработчик подразумевает техническую трудность, руководитель — срок поставки, заказчик — цену. Ошибка проявляется позже, когда выясняется, что проверка, интеграция или подготовка данных не вошли в обещание.
Размер, сложность, усилия, срок и риск
Размер описывает объём заданных требований в выбранной системе измерения. Сложность реализации — особенности, из-за которых решение трудно спроектировать, написать, проверить или сопровождать. Трудозатраты — объём человеческой работы. Срок — календарное время до согласованного результата. Неопределённость — недостаток знания о требованиях, решении и условиях выполнения.
Риск связан с возможными событиями и их последствиями. Например, неизвестный контракт API — неопределённость, а вероятность того, что его изменение потребует переделки формы, можно рассматривать как отдельный риск. Не стоит прятать всё это в один произвольный коэффициент.
| Характеристика | Рабочий вопрос | Возможный результат |
|---|---|---|
| Функциональный размер | Какие функции должна выполнять система? | Размер по выбранному методу и его правилам |
| Нефункциональные требования | Какие дополнительные свойства результата обязательны? | Согласованные требования и применимые измерения |
| Сложность решения | Что трудно реализовать и почему? | Перечень технических факторов и архитектурных решений |
| Трудозатраты | Какой объём работы нужен для готового результата? | Диапазон усилий с оговорённым составом |
| Срок | Когда результат может быть поставлен? | Прогноз с зависимостями и условиями |
| Неопределённость | Чего пока не знаем? | Вопросы, проверки и план уточнения |
| Риск | Что может изменить прогноз? | Событие, последствия и действие команды |
Простой пример: заменить текст на кнопке обычно невелико по реализации. Но если текст участвует в согласуемом юридическом уведомлении, календарный срок может определяться внешним согласованием. Увеличивать из-за этого «сложность кода» бессмысленно. Нужно показать ожидание отдельной зависимостью.
Почему большое не всегда сложно
Сотня однотипных карточек, собираемых из готового шаблона, может потребовать больше контента, чем инженерного изобретения. Один визуальный редактор с отменой действий и совместным доступом может выглядеть компактно, но содержать сложное поведение.
Поэтому число экранов полезно для инвентаризации, но недостаточно для оценки проекта. Нужно понимать уникальность шаблонов, состояния, данные, взаимодействия и требования к качеству. На практике первым результатом оценки часто становится уточнённое описание объёма, а не число часов.
Сравнение методов оценки сложности
Таблица развивает исходный список методологий и показывает, какую управленческую задачу решает каждый подход. Методы выбраны по запросу пользователя; это сравнение по назначению и ограничениям, а не рейтинг точности. Универсального эксперимента, доказывающего превосходство одного подхода для всех проектов, статья не заявляет.
| Метод | Что измеряет или описывает | Применение к фронтенду | Чего сам по себе не даёт |
|---|---|---|---|
| COSMIC | Функциональный размер | Функциональные процессы и перемещения данных в заданной границе | Готовые часы, цену, сложность анимации |
| IFPUG SNAP | Нефункциональный размер в пределах правил метода | Применимые требования к интерфейсу и другим свойствам реализации | Универсальный учёт любых затрат проекта |
| Cognitive Complexity | Структурную трудность понимания потока управления | Сложные обработчики, условия, вложенные ветвления | Полную оценку архитектуры и будущей разработки |
| Cyclomatic Complexity | Линейно независимые пути в графе потока управления | Ветвления в проверках и логике | Полное число тестов и стоимость задачи |
| Модель состояний / statecharts | Состояния, события и переходы | Формы, импорт, сохранение, конфликты, отмена | Автоматическую норму времени на состояние |
| Матрица экранов и компонентов | Относительный профиль реализации по правилам команды | Сопоставление экранов и повторного использования | Стандартизованный межкомандный размер |
| Story Points / Planning Poker | Командную относительную оценку работы | Обсуждение объёма, сложности и неопределённости | Общую валюту для сравнения команд |
| Эвристики Nielsen | Потенциальные проблемы удобства | Ошибки, обратная связь, контроль и понятность | Трудоёмкость исправления найденной проблемы |
Определения опираются на COSMIC, IFPUG SNAP, SonarSource, Stately, Scrum Alliance и Nielsen Norman Group.
Полезнее выбирать метод под вопрос. Для закупки разработки может понадобиться сопоставимый размер требований и собственная модель стоимости. Для рефакторинга — анализ кода. Для формы с непонятным поведением — состояния. Для планирования итерации — командная декомпозиция и оценка готовых к обсуждению задач.
COSMIC: функциональный размер вместо подсчёта экранов
COSMIC измеряет функциональные пользовательские требования через перемещения данных. В модели различают Entry, Exit, Read и Write; одно учитываемое перемещение имеет размер один COSMIC Function Point, или CFP. Перед измерением задают цель, область, границы и функциональных пользователей. Подробности изложены в официальном описании процесса COSMIC.
Для фронтенда важна граница измерения. Взаимодействие с отдельным backend может проходить через границу как обмен с другим программным функциональным пользователем. Нельзя автоматически считать любой API-запрос чтением из постоянного хранилища внутри фронтенда. Правила Read/Write и границ раскрыты в Measurement Manual v5.0.
Что подготовить до измерения
В рабочем разборе сначала полезно описать пользовательский результат: найти запись, изменить данные, получить подтверждение. Затем выяснить, какие данные нужны, откуда они приходят и кто взаимодействует с измеряемой частью системы. После этого специалист применяет правила метода.
Для формы редактирования профиля это означает уточнить состав данных, событие запуска и ожидаемый результат операции. Изображение экрана без описания поведения недостаточно. Ошибки, подтверждения и обмен с сервисами требуют осмысленного анализа требований.
Здесь намеренно нет «формального расчёта CFP по кнопкам». Учебный список действий помогает подготовить материал для измерения, но ещё не является измерением. Чтобы результат назывался COSMIC-размером, необходимо соблюдать определения, правила уникальности и агрегации.
Где COSMIC полезен для проекта
Функциональный размер помогает обсуждать состав продукта отдельно от выбранного фреймворка. Например, команда может переработать реализацию, сохранив функциональные требования. Сравнение тогда не должно опираться только на количество новых строк кода.
Практическое применение в оценке бюджета требует исторической связи между измеренным размером и усилиями в сопоставимом контексте. Само значение CFP не сообщает, насколько готова дизайн-система, сколько интеграций нестабильно и сколько времени займёт приёмка.
Для интерфейса со сложной графикой стоит дополнительно описывать визуальные и поведенческие требования. Если их влияние не представлено в выбранной модели, маленький функциональный размер не должен становиться обещанием быстрой разработки.
Когда не стоит начинать с формального размера
Для небольшой команды и разовой правки стоимость подробного измерения может быть выше полезности решения. В таком случае достаточно явно записать сценарий, критерии приёмки и ограничения. Формальный метод разумно вводить там, где есть потребность в повторяемости и сопоставимости.
На раннем этапе требования могут быть недостаточно определены. Тогда результат должен отражать приблизительность и использованный способ оценки. Нельзя выдавать обзорный подсчёт по презентации за полноценное измерение подробных требований.
IFPUG SNAP: нефункциональный размер требований
SNAP расшифровывается как Software Non-Functional Assessment Process. IFPUG описывает его как дополнение функционального размера: оценку нефункциональных требований по собственным категориям и правилам. В официальном обзоре указаны четыре категории и четырнадцать подкатегорий. Описание SNAP от IFPUG.
Для фронтенда метод релевантен, в частности, из-за подкатегории User Interfaces и аспектов обработки данных в диалогах. Этому посвящён отдельный материал IFPUG об измерении интерфейсов. Однако наличие требования к интерфейсу ещё не определяет его размер: применимость и подсчёт устанавливают по руководству метода.
Как подготовить требования к обсуждению
Фраза «сделать качественно» не помогает оценке. Лучше записать наблюдаемые условия: поддерживаемые устройства, варианты ввода, требования к представлению результата, доступности и ограничениям среды. Затем определить, какие из них охватываются выбранным методом, а какие учитываются отдельно.
Например, заказчик хочет пользоваться таблицей с клавиатуры и сохранять контекст после ошибки. Одной отметки «нефункциональные требования» недостаточно: нужно описать поведение, критерий проверки и границы реализации. Не все такие требования обязательно превращаются в SNAP points одинаковым способом.
Для доступности полезен отдельный проверяемый базис. W3C WCAG Quick Reference помогает находить требования к фокусу, клавиатуре и другим характеристикам интерфейса. Это источник критериев, а не таблица часов и не автоматический калькулятор SNAP.
Почему SNAP не надо превращать в надбавку за сложный дизайн
Произвольное правило «красивый экран — плюс десять SNAP points» не относится к методу. Эстетическая насыщенность макета и формальные категории требований — разные вещи. Для сложной анимации может потребоваться отдельное техническое описание и проверка прототипом.
Так же неверно считать, что SNAP покрывает любое ожидание, согласование и организационный риск. Они влияют на проект, но не обязательно относятся к измеряемому размеру программных требований. Такие элементы должны оставаться в реестре зависимостей и прогнозе выполнения.
Как использовать вместе с функциональной оценкой
Храните результаты раздельно: функциональный размер, нефункциональный размер, дополнительные ограничения и модель усилий. Числа из разных методов нельзя складывать без собственной обоснованной модели преобразования. Сумма CFP и SNAP points не становится новой стандартной единицей.
Удобный результат для команды — связанный реестр требований. Каждое требование имеет источник, критерий приёмки и место в оценке. Это помогает не потерять работу и не посчитать одно и то же дважды.
Cognitive Complexity: насколько сложно понимать код
Cognitive Complexity — метрика SonarSource, приближающая структурную трудность понимания потока управления. В её правилах учитываются нарушения линейного чтения и вложенность; отдельные удобные конструкции обрабатываются по специальным правилам. Это не психологический тест разработчика и не измерение всех свойств архитектуры. White paper Cognitive Complexity.
Во фронтенде полезный объект анализа — обработчик, в котором одновременно проверяют права, валидируют данные, выбирают способ сохранения и управляют отображением сообщений. Метрика помогает найти такие места для разбора. Но итоговое решение о рефакторинге требует чтения кода и знания сценария.
Пример проблемы с вложенностью
Рассмотрим учебный фрагмент:
function canSave(user, draft, connection) {
  if (user) {
    if (user.canEdit) {
      if (draft.isValid) {
        if (connection.isOnline) {
          return true;
        }
      }
    }
  }
  return false;
}
Для простого правила такую вложенность можно заменить последовательными проверками или выразительным предикатом. Но в настоящей системе функция может отвечать ещё и за причины запрета. Сведение её к короткому логическому выражению способно скрыть важные различия между «нет прав» и «нет соединения».
Поэтому цель — сделать модель поведения понятной. Если интерфейс должен показать разные сообщения, отдельно опишите причины отказа и их приоритет. Уменьшение метрики без сохранения этого смысла не улучшает продукт.
В статье не приводится точный балл Cognitive Complexity для этого кода: он не проверялся конкретным анализатором. Для воспроизводимого значения нужно зафиксировать инструмент, версию и правила языка.
Что метрика показывает на существующем проекте
При доработке сложного модуля полезно посмотреть распределение проблем: один тяжёлый обработчик, несколько вложенных условий или разнесённые по компонентам зависимости. Само число не сообщает, какие требования затронет изменение.
Например, задача «добавить ещё один статус» может быть маленькой в хорошем модуле и дорогой в коде с дублированными проверками по всему приложению. В оценке стоит записать причину: изменение требует согласовать несколько мест и защититься от регрессий. Формулировка полезнее необъяснённой надбавки «за технический долг».
Чего нельзя выводить из Cognitive Complexity
Низкий показатель функции не подтверждает, что весь компонент легко поддерживать. Сложность может находиться в эффектах, асинхронных связях, неявных соглашениях и распределении состояния. Это отдельные предметы анализа.
Не следует и прогнозировать стоимость новой системы из желаемого среднего показателя. Код ещё не написан, структура не выбрана, а нормативной связи «балл — часы» нет. Для планирования полезнее исследовать рискованные участки и опираться на наблюдения своей команды.
Cyclomatic Complexity: ветвление и независимые пути
Cyclomatic Complexity, или цикломатическая сложность, связана с числом линейно независимых путей в графе потока управления. Классическая запись — V(G) = E − N + 2P, где E — рёбра, N — вершины, P — компоненты. На уровне функции анализаторы используют правила подсчёта ветвлений. Объяснение SonarSource.
В прикладной проверке важно знать правила языка: логические операции, варианты switch, обработка исключений и другие конструкции могут учитываться по-разному. SonarSource публикует определения метрик и языковые детали в документации SonarQube.
Пример для фронтенд-валидации
Представим функцию с тремя последовательными независимыми проверками:
function getError(form) {
  if (!form.name) return 'name_required';
  if (!form.email) return 'email_required';
  if (!form.acceptedTerms) return 'terms_required';
  return null;
}
В упрощённом подсчёте «база один плюс три ветвления» получается четыре. Это учебный расчёт для показанной структуры. Он не является отчётом инструмента и не переносится автоматически на всю форму.
Интерфейс может дополнительно иметь серверную проверку, повторную отправку, блокировку кнопки и доступное объявление ошибки. Эти требования не исчезают из-за небольшого числа у функции. И наоборот: ветвистый, но понятный справочник правил не обязательно требует переписывания.
Почему число путей не равно числу всех тестов
Независимые пути — характеристика графа управления. Полный тестовый набор зависит ещё от значений данных, границ, комбинаций условий, асинхронных событий и требований. Часть путей может быть недостижима при реальных ограничениях.
Поэтому фраза «сложность равна четырём, значит нужны ровно четыре теста» слишком сильна. Для конкретного критерия покрытия можно строить соответствующий набор, но нельзя из одной метрики вывести достаточность всей проверки продукта.
Для формы с суммами и валютами нужно тестировать содержательные ограничения, а не только ветви. Пустая строка, округление и формат числа могут попадать в одну ветвь, но создавать разные дефекты.
Как сочетать две метрики кода
Cyclomatic Complexity помогает увидеть ветвление, Cognitive Complexity — структуру, мешающую пониманию. Расхождение между ними полезно для обсуждения. Плоское перечисление вариантов и глубоко вложенный алгоритм могут требовать разных действий даже при похожем объёме.
В отчёте стоит назвать проблемную функцию, затрагиваемый сценарий и ожидаемое последствие для работы. Затем решить, нужен ли отдельный рефакторинг, локальное изменение или исследование. Метрика становится основанием для вопроса, а не автоматическим приговором.
Модель состояний и statecharts: сложность поведения
Модель состояний описывает, в каких режимах находится система и какие события вызывают переходы. Statecharts расширяют подход средствами вроде иерархии и параллельных областей. Это способ выразить поведение, а не готовая шкала трудозатрат. Введение Stately.
Для фронтенда такой разбор особенно полезен, когда одного макета недостаточно. Один экран импорта может быть пустым, загружать файл, показывать проверку, ждать решения по ошибкам и сообщать о завершении. Внешне экран один, но работа не ограничивается одним состоянием.
Сначала поведение, затем количество
Начните с вопроса, что пользователь может делать в каждом режиме. Можно ли отменить загрузку? Разрешено ли сменить файл после проверки? Что произойдёт при потере соединения? Сохранится ли выбор после обновления страницы?
Такие вопросы раскрывают требования до написания компонентов. Они полезны даже без специализированной библиотеки: модель можно вести таблицей переходов и обсуждать с аналитиком, дизайнером и тестировщиком.
Пример учебной таблицы:
| Состояние | Событие | Условие | Результат |
|---|---|---|---|
| Файл не выбран | Выбор файла | Формат допустим | Начать загрузку |
| Загрузка | Отмена | Операцию можно прервать | Завершить локальную попытку, вернуть выбор |
| Проверка | Получен результат | Ошибок нет | Открыть предпросмотр |
| Проверка | Получен результат | Есть исправимые ошибки | Показать список и допустимые действия |
| Предпросмотр | Подтверждение | Права и данные актуальны | Запустить импорт |
| Импорт | Потеря связи | Итог операции неизвестен | Проверить статус, исключить слепое дублирование |
Последняя строка особенно важна. Потеря соединения не доказывает, что сервер ничего не сделал. В требованиях нужно определить восстановление статуса, а не просто добавить красное уведомление.
Почему набор boolean-переменных скрывает сложность
Четыре независимых флага теоретически допускают 2⁴ = 16 комбинаций. Не все комбинации обязательно достижимы или осмысленны. Если приложение не должно одновременно быть «сохраняется» и «успешно сохранено», модель данных должна помогать исключать противоречие.
Это соответствует общему совету React о структуре состояния: избегать противоречивого и избыточного состояния. Но формула комбинаций — только арифметический верхний предел, а не число реальных экранов или обязательных тестов.
Для оценки важнее выявить допустимые сочетания и переходы. Параллельная загрузка справочника и редактирование текста отличаются от одной последовательной цепочки. Иерархия может сделать описание компактнее, но не отменяет проверку фактического поведения.
Что записывать как сложность
Полезный профиль включает число значимых режимов, переходы с условиями, асинхронность, отмену, повтор, восстановление, конфликт и параллельные действия. Отдельно записывайте неизвестные правила. Это помогает обнаружить работу, которая отсутствует на статичном макете.
Не устанавливайте универсальную цену за переход. Простое открытие подсказки и восстановление импорта после сбоя могут иметь одинаковую форму стрелки, но разную реализацию. Модель даёт структуру для декомпозиции и тестирования.
Матрица сложности экранов и компонентов
Матрица — практический инструмент команды для сравнения реализации по общим признакам. Она становится полезной, когда критерии описаны, примеры согласованы, а оценки связаны с последующими наблюдениями. Единой обязательной отраслевой шкалы для любой матрицы экранов нет.
Ниже предлагается учебная авторская матрица. Она не относится к COSMIC, SNAP или Scrum и не прошла эмпирическую калибровку. Её можно адаптировать для начала командного обсуждения, сохраняя отдельные факторы и неизвестные.
Какие факторы включить
| Фактор | Низкий уровень | Средний уровень | Высокий уровень |
|---|---|---|---|
| Уникальность представления | Готовый шаблон без изменений | Адаптация нескольких компонентов | Новая визуальная модель взаимодействия |
| Поведение | Простой последовательный сценарий | Несколько альтернатив и ошибок | Параллельность, конфликты, восстановление |
| Работа с данными | Один согласованный источник | Сопоставление нескольких наборов | Большой объём, сложные преобразования, согласованность |
| Интеграции | Проверенный контракт | Изменяемый контракт с доступным владельцем | Неизвестное поведение или несколько зависимых систем |
| Переиспользование | Компонент уже подходит | Требует расширения | Подходящего основания нет |
| Среды и качество | Согласованный базовый набор | Дополнительные устройства и условия | Сложные ограничения и проверки |
| Неопределённость | Правила и примеры известны | Есть уточняемые вопросы | Неизвестен принцип решения или критерий приёмки |
Матрица не должна награждать сложность. Она помогает понять, почему задача требует внимания и чем снизить риск. Если API неизвестен, полезным действием может стать проверка контракта, а не завышение числа во всех столбцах.
Нужен ли общий балл
Для начала достаточно профиля. Экран может быть простым визуально и сложным по интеграциям. Одно итоговое число скрывает эту разницу, тогда как решение команды зависит от неё.
Если требуется внутренний индекс, можно договориться о порядковой шкале, например 0–3 для наблюдаемых уровней. Но разница между уровнями не становится равной разнице часов. Значение «неизвестно» следует хранить отдельно, а не заменять нулём или максимальным баллом.
Веса и пороги — гипотезы команды. Их проверяют по выполненной работе. Нельзя объявить сумму «двадцать баллов» эквивалентом «десяти дней» без данных и описания применимости.
Как избежать двойного учёта
Поведение, валидация и число ошибок могут описывать одну и ту же работу. Если за каждое добавить независимую надбавку, оценка раздуется. Отдельные признаки полезны для обсуждения, но модель усилий должна объяснять, как они связаны.
Так же важно не считать общий компонент заново на каждом экране. Отдельно оцениваются создание или доработка общего основания, интеграция на конкретной странице и проверка контекста. Повторное использование снижает часть работы, но не обнуляет её автоматически.
Как калибровать матрицу
После завершения задачи сравните исходный профиль с фактом. Что оказалось главным: дизайн, данные, контракт, регрессия или неучтённое состояние? Было ли требование известно во время оценки? Это разные причины отклонения.
Если новые признаки не помогают объяснять решения, матрицу стоит упростить. Полезность инструмента определяется качеством разговора и последующей проверкой, а не числом столбцов.
Story Points и Planning Poker: командная относительная оценка
Story Points используют для относительной оценки работы внутри команды. Они помогают обсуждать объём, сложность и неопределённость через сравнение с известными задачами. Это не стандартизованные человеко-часы. Scrum Alliance отдельно предостерегает от перевода по постоянному курсу и сравнения команд по velocity. Материал Scrum Alliance.
Planning Poker — способ провести обсуждение: участники независимо выбирают оценку, одновременно раскрывают выбор и разбирают расхождения. После уточнения можно оценить повторно. Процедуру описывает Mountain Goat Software.
Что даёт расхождение оценок
Если один участник видит маленькую доработку, а другой — большой объём, полезно выяснить предпосылки. Первый мог предполагать готовый компонент. Второй — помнить о старом механизме сохранения. Третий — учитывать мобильную версию и регрессию.
Такое расхождение не нужно немедленно усреднять. Оно показывает разные модели задачи. После обсуждения может выясниться, что требуется два варианта оценки: расширение имеющегося решения и разработка нового основания.
Команда также может обнаружить, что задача пока непригодна для содержательной оценки. Тогда разумный результат — конкретный вопрос или исследование. Большое число не должно маскировать отсутствие понимания.
Как выбрать опорные задачи
Возьмите завершённые задачи с понятным составом результата. Важно помнить не только кодирование, но и проверку, исправления и обязательную интеграцию. Сравнивайте новый элемент с несколькими такими примерами.
Опорная задача должна быть узнаваемой для команды. Если её выполнял один человек в неизвестных условиях год назад, общая память может быть ненадёжной. Полезно сохранять краткое описание, критерии готовности и важные ограничения.
При изменении состава команды или технологии старые ориентиры нужно пересмотреть. Сохранение прежних чисел ради красивого графика не обеспечивает сопоставимости.
Почему points не стоит использовать как KPI
У разных команд могут отличаться шкалы и правила включения работ. Рост суммы points не доказывает рост полезного результата. Если число становится целью, участники получают стимул менять оценивание вместо процесса поставки.
Для обсуждения результата лучше отдельно смотреть выполненные продуктовые цели, качество и фактическую поставку. Относительная оценка остаётся внутренним инструментом планирования. Она не сообщает, кто из разработчиков «работает вдвое эффективнее».
Story Points не обязательны для Scrum
Scrum не сводится к points и покеру. В Scrum Guide описываются работа с Product Backlog, уточнение и оценивание его элементов, но конкретная шкала не предписывается. Это прямо разбирает Scrum.org в материале о мифе обязательных Story Points, а исходные правила доступны в Scrum Guide.
Если задачи достаточно малы и сопоставимы, команда может строить прогноз по завершённым элементам. Если элементы сильно различаются, сначала потребуется работа с декомпозицией. Выбор инструмента определяется контекстом, а не требованием непременно заполнить поле points.
Эвристическая оценка Nielsen: проблемы удобства
Эвристическая оценка проверяет интерфейс на потенциальные проблемы удобства. Среди принципов Nielsen — понятный статус системы, соответствие языку пользователя, контроль действий, последовательность, предотвращение ошибок, поддержка распознавания, эффективность, умеренность представления, помощь при ошибках и справка. Это ориентиры экспертного разбора. Десять эвристик Nielsen.
Метод можно применять к прототипу и готовому продукту. Он помогает находить вероятные проблемы, но не заменяет исследование с реальными пользователями. NN/g описывает подготовку, независимую проверку и объединение находок в руководстве по проведению оценки.
Как UX-проблема превращается в задачу разработки
Представим импорт, в котором после нажатия кнопки ничего не меняется. Эксперт фиксирует отсутствие обратной связи. Затем команда уточняет решение: показать ход загрузки, состояние серверной обработки, возможность отмены или только сообщение о принятом задании.
Это разные объёмы. Формулировка «исправить видимость статуса» не определяет трудозатраты, пока не выбрано поведение и не понятен контракт сервера. Эвристика обнаружила проблему; оценка реализации начинается следующим шагом.
Другой пример — неудобная ошибка в форме. Иногда достаточно переписать текст. Иногда нужно сохранить введённые данные, вернуть фокус в поле и изменить серверный ответ. Одинаковая пользовательская жалоба не означает одинаковую инженерную задачу.
Важность проблемы и стоимость исправления
Храните их раздельно. Очень неприятный дефект может исправляться небольшой правкой. Малозаметная проблема может требовать существенной перестройки. Приоритет решения зависит от последствий для пользователя и продукта, а оценка работы — от выбранного изменения.
Полезный реестр содержит сценарий, наблюдение, предполагаемое последствие, доказательства и варианты решения. Если последствие пока только гипотеза эксперта, так и укажите. Это помогает выбрать, где нужен пользовательский тест, а где достаточно согласованной очевидной правки.
Где эвристики полезны в оценке проекта
Разбор до разработки помогает уточнить критерии приёмки. Вместо «форма готова, когда отправляет данные» появляется понятный результат с ошибками, восстановлением и доступной обратной связью. Так обнаруживается работа, которую иначе добавили бы после демонстрации.
Это не повод безгранично расширять проект. Каждая новая находка должна пройти решение по объёму: обязательна ли она сейчас, входит ли в исходные критерии или требует отдельного изменения. Оценка остаётся связанной с согласованным результатом.
Как оценивать фронтенд до появления кода
Метрики готового кода помогают при изменении существующего приложения. Для нового интерфейса на первом плане требования, макеты, сценарии и ограничения. Не нужно придумывать будущую Cyclomatic Complexity для каждого компонента.
Разберите интерфейс в нескольких представлениях: пользовательский путь, каталог экранов и шаблонов, данные и интеграции, состояния и критерии качества. Разные представления показывают разные пропуски. Противоречие между ними — полезная находка оценки.
Что спрашивать у дизайнера и аналитика
Уточните пустые и ошибочные состояния, длинные тексты, ограничения данных, роли и поведение на небольшом экране. Определите, что происходит после обновления страницы, возврата назад и повторного нажатия. Для сложных сценариев опишите отмену и восстановление.
Макет успешного сценария — только часть контракта. Если в нём нет ошибки, это не значит, что её не надо реализовывать. Но и разработчик не должен молча изобретать поведение, а затем предъявлять его как неизбежное расширение работ.
Визуальная сложность требует своего разбора
Анимация, нестандартная типографика, сложные сетки, масштабирование и рисование могут увеличивать работу без большого количества бизнес-функций. Для таких задач полезен технический прототип с заранее выбранным вопросом: проверяет ли он плавность, совместимость, способ ввода или точность отображения.
Результат прототипа должен уменьшать конкретную неизвестность. «Попробовать библиотеку» слишком широко. «Проверить, поддерживает ли она нужное выделение объектов на целевых устройствах» уже помогает будущему решению.
Не переносите удачный демонстрационный пример библиотеки на весь проект. Потребуются реальные данные, оформление, доступность, интеграция и проверка. Повторное использование — предпосылка, которую нужно подтвердить.
Сквозной пример: оценка импорта каталога
Представим вымышленный проект: пользователь загружает каталог товаров, сопоставляет столбцы, смотрит ошибки и подтверждает импорт. Проект и оценки ниже созданы для объяснения метода. Это не клиентский кейс, не замер производительности и не расчёт формального функционального размера.
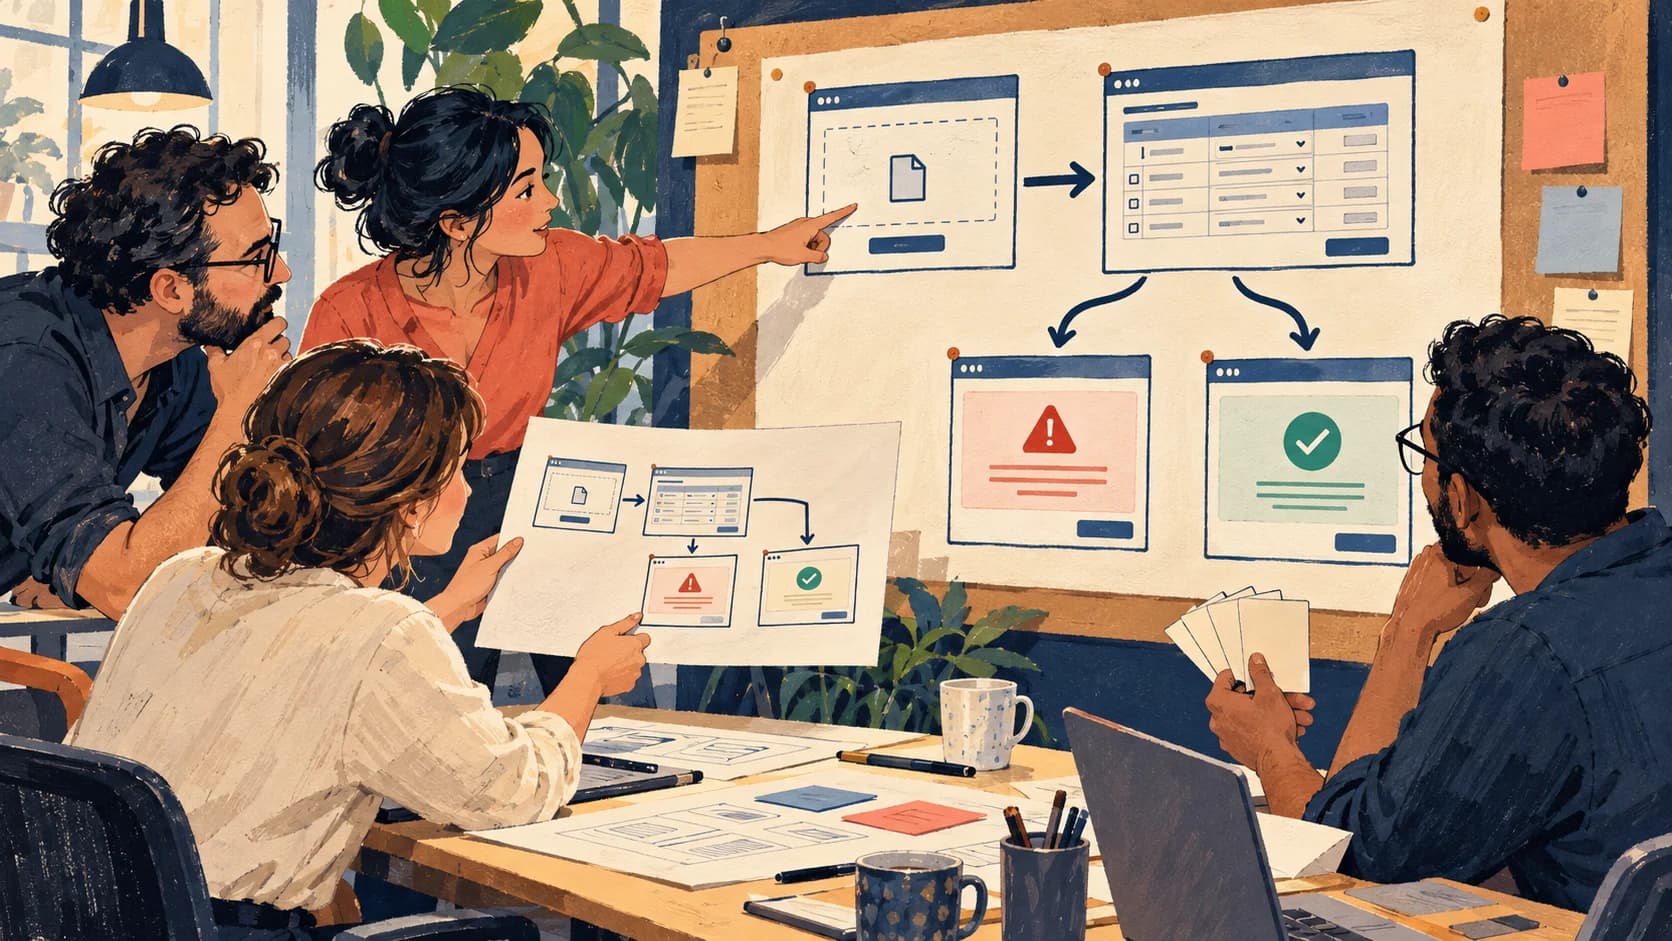
На рабочей встрече команда сопоставляет прототип шагов импорта с диаграммой состояний и карточками оценки. Так статичный экран связывается с поведением, интеграциями и критериями готовности. Каждый метод отвечает на свою часть вопроса.
Сначала фиксируем границы результата
В первую версию включены загрузка согласованного формата, сопоставление полей, предпросмотр, сообщение об ошибках и получение итогового статуса. Поддержка произвольных источников, сложное объединение дублей и совместное редактирование не обещаны. Это выбранные условия учебного примера, а не универсальная спецификация импорта.
Нужно уточнить ограничения файла, поведение при частичной ошибке и способ восстановления после разрыва связи. Пока их нет, оценка остаётся условной. Запись вопроса полезнее незаметного предположения, что сервер «как-нибудь разберётся».
Затем рассматриваем каждый подход
| Подход | Что команда выясняет в учебном импорте | Результат для оценки |
|---|---|---|
| COSMIC | Где граница измеряемого ПО, какие функциональные процессы и данные заданы | Основание для формального измерения при необходимости |
| SNAP | Какие применимые нефункциональные требования к диалогам и среде согласованы | Основание для измерения по правилам SNAP, без самодельных points |
| Statecharts | Загрузка, проверка, исправление, подтверждение, выполнение, восстановление | Таблица режимов, событий и переходов |
| Матрица | Новизна сопоставления колонок, сложность данных и интеграции | Относительный профиль реализации |
| Story Points | Как подготовленные задачи соотносятся с опорными задачами команды | Командная оценка после уточнения |
| Nielsen | Понимает ли пользователь статус и путь исправления | Требования к обратной связи и восстановлению |
| Метрики кода | Как устроен существующий модуль загрузки, если его меняют | Область анализа и возможного рефакторинга |
Эта таблица не складывается в общую сумму. Она показывает, какие артефакты нужны для решения. Если функциональный размер не требуется, команда может не выполнять формальное измерение, сохранив полезный разбор требований.
Декомпозиция по поставляемым результатам
Полезно выделить базовую загрузку с показом статуса, сопоставление полей, представление ошибок и подтверждение операции. Каждая часть должна иметь проверяемый результат. Разделение только на «написать компонент», «написать CSS» и «потом протестировать» хуже показывает готовность пользовательского сценария.
При этом общие зависимости учитываются явно. Контракт задания, механизм проверки статуса и обработка отмены могут использоваться несколькими частями. Их нельзя незаметно посчитать полностью в каждой задаче.
Рискованную интеграцию стоит проверить раньше, если она определяет архитектуру. Это не обязательно означает реализовать весь backend до интерфейса. Нужно получить достаточное основание для следующего решения.
Что меняет дополнительное требование
Предположим, после первоначального разбора добавили восстановление незавершённого импорта на другом устройстве. Визуально новый экран может не понадобиться. Но меняются хранение состояния, идентификация задания, права доступа и восстановление статуса.
Это хороший пример изменения сложности без роста числа макетов. Исходная оценка не была автоматически неверной, если такого требования не существовало. Нужно зарегистрировать изменение и пересмотреть затронутые части.
Если же восстановление было явно записано с самого начала, но команда его пропустила, это причина улучшить процесс оценки. Для обучения важно различать изменение объёма и ошибку анализа.
Как перейти от сложности к трудозатратам и срокам
Сложность помогает объяснить работу, но прогноз требует дополнительных данных. Нужны состав результата, доступная команда, сопоставимые завершённые задачи, зависимости и условия приёмки. Без этого «точная оценка» часто оказывается просто подробным числом.
Для функционального размера возможна модель на основе наблюдаемой производительности. COSMIC рассматривает связь размера и усилий через производительность в официальном введении в метод. Но применять чужой коэффициент без проверки контекста нельзя: сопоставимость измерения и условий работы имеет значение.
Прогноз по аналогам
Выберите завершённые задачи с похожим результатом и условиями. Сравнивайте не только тип экрана, но и новые компоненты, интеграции, качество требований, проверки и зависимости. Если аналог отличался, объясните ожидаемое влияние.
Полезно хранить несколько примеров, а не единственный «идеальный случай». Один удачный быстрый релиз может не отражать обычный процесс. Также нужно отделять время активной работы от ожидания, если это позволяет система учёта.
Не требуется создавать громоздкую базу ради первой оценки. Начните с небольшой согласованной истории и перечня отличий. Если подходящих данных нет, так и запишите: прогноз экспертный, основания ограничены, проверка намечена после первого результата.
Человеко-часы не равны календарным часам
Рассмотрим условный арифметический пример. Работа A занимает 12 часов, а после неё можно параллельно выполнить B за 8 часов и C за 6 часов. Общий объём — 26 человеко-часов. При идеальных условиях и доступности разных исполнителей длительность цепочки составляет 20 рабочих часов: 12 + max(8, 6).
Это учебный расчёт. В нём нет переключений, коммуникации, ожиданий и ограничений рабочего графика. Если все части делает один человек, предположение о параллельности не выполняется. Деление суммы на количество сотрудников не восстанавливает правильный срок автоматически.
Для проекта нарисуйте зависимости и укажите доступность исполнителей. Задачи, которые требуют одного специалиста или одного тестового стенда, могут конкурировать за ресурс. Этот эффект не виден в сумме баллов сложности.
Что включать в трудозатраты
Определите границу готовности: анализ, реализация, ревью, тесты, исправления, интеграция и выпуск могут входить в одну оценку или учитываться отдельно. Важно, чтобы правило было явным. Иначе команды сравнивают разные объёмы под одинаковым названием.
Повторяющиеся общепроектные работы лучше показывать отдельными элементами: настройка среды, сборка, мониторинг, миграция, подготовка данных, приёмка. Если их скрыть внутри каждой задачи, легко получить и пропуск, и двойной учёт.
Не всё должно оцениваться с одинаковой детализацией. Для раннего решения достаточно грубого диапазона и главных ограничений. Для близкой поставки требуется более конкретное описание.
Диапазон и условия вместо ложной точности
Диапазон полезен, если понятно, что определяет его границы. Нижняя граница может предполагать готовый контракт и переиспользование, верхняя — ограниченную доработку согласованного компонента. Неизвестная архитектура может выходить за этот диапазон и требовать отдельного исследования.
Не называйте экспертный интервал статистическим доверительным интервалом без модели и данных. Также нельзя присвоить ему вероятность только потому, что числа выглядят разумно. В коммуникации нужно различать экспертное предположение и эмпирический прогноз.
Когда имеются подходящие данные потока, применяют вероятностное прогнозирование. Scrum.org разбирает Monte Carlo forecasting. Такой прогноз зависит от исходной истории и предположений о будущем; он не отменяет изменения объёма, команды и способа поставки.
Что означают P50 и P85
В прогнозном распределении P50 и P85 обозначают соответствующие квантили результата. Для даты завершения смысл нужно объяснять через использованную модель: какая доля смоделированных исходов укладывается в неё. Без калибровки нельзя обещать, что фактические проекты будут попадать в границы с такой же частотой.
Руководителю полезнее видеть выбранный уровень осторожности, входные данные и последствия изменения объёма, чем одно «вероятное число» без основания. В этой статье моделирование сроков не выполнялось, поэтому конкретные даты и вероятности проекта не приводятся.
Как оценивать проект целиком
Проект — это не просто сумма экранов. Есть общая архитектура, интеграции, общие компоненты, миграция, проверка сквозных сценариев и переход к эксплуатации. Зависимости между частями способны определять календарный результат сильнее, чем сложность отдельной функции.
Начните с карты результатов и границ. Затем выделите общие основания и части, которые можно поставлять независимо. Отдельно отметьте решения, от которых зависит много других задач. Их полезно проверять до детальной оценки всего хвоста работ.
Разделите постоянную и повторяемую работу
Создание общего механизма загрузки — одна работа, его применение в конкретной форме — другая. То же относится к дизайн-системе, авторизации, обработке ошибок и инфраструктуре тестов. Повторное использование требует соответствия требованиям и проверки контекста.
Для проекта с несколькими командами добавьте интерфейсы ответственности: кто меняет контракт, кто обеспечивает тестовые данные, кто принимает общий результат. Неясность владения может создавать ожидание даже при технически простых частях.
В оценке полезно иметь отдельный список координационных задач и зависимостей. Это делает прогноз объяснимым без искусственного повышения технических баллов всех экранов.
Учтите интеграционное качество
Компоненты могут работать отдельно и не образовывать готовый сценарий. Проверка прав, форматов данных, повторов и ошибок необходима на границах. Она должна присутствовать в плане поставки.
Приёмка также требует конкретного основания: кто проверяет, какие данные используются, какое поведение считается достаточным. Если эти условия выясняются в конце, проблема выглядит как «недооценённая разработка», хотя часть причины находится в неописанном процессе готовности.
Не переносите простую сумму на архитектурный риск
Если требуется неизвестный способ совместного редактирования или обработка необычного объёма данных, имеет смысл отдельно проверить решение. Добавление условных процентов к каждому экрану не даёт понимания, выдержит ли архитектура требования.
Результат исследования может сузить варианты, подтвердить подход или показать необходимость изменить требования. Любой из этих результатов полезен для оценки, если вопрос исследования был выбран заранее.
Неопределённость, риски и исследования перед оценкой
Неизвестность стоит называть предметно. «Много рисков» не помогает следующему действию. «Неизвестно, возвращает ли сервис устойчивый идентификатор задания после повторного запроса» уже позволяет назначить проверку и владельца.
Разделяйте требования, техническое решение, внешние зависимости и организационные условия. Для каждого типа неизвестности подходит свой способ уточнения. Вопрос к владельцу продукта не всегда решается техническим прототипом, а совместимость библиотеки не выясняется дополнительным обсуждением макета.
Что должно быть результатом spike
Исследовательская задача, часто называемая spike, должна отвечать на ограниченный вопрос. Например: поддерживает ли библиотека нужное редактирование таблицы с клавиатуры на целевых устройствах? Выход — наблюдения, ограничения и рекомендация по следующему шагу.
Не обещайте, что после исследования неизвестность исчезнет полностью. Можно определить критерий завершения: проверен штатный и проблемный сценарий, зафиксированы ограничения и выбран вариант для дальнейшей реализации. Это делает работу обозримой.
Также важно не выдавать прототип за производственный компонент. Демонстрация идеи может не включать доступность, стабильную обработку ошибок, поддержку и эксплуатацию. Если код будет переиспользован, оцените его доведение до нужного качества отдельно.
Резерв должен иметь объяснение
Резерв полезнее связывать с рисками и уровнем обязательств. Для одного проекта главный риск — изменяющиеся требования, для другого — интеграция с внешним владельцем. Одинаковая надбавка ко всем задачам не показывает ни причины, ни возможного действия.
Не добавляйте несколько резервов на одну причину: высокий балл неопределённости, увеличение hours, отдельный процент риска и ещё общий запас. Такая конструкция выглядит осторожной, но может многократно учитывать одно событие.
Условия пересмотра нужно согласовать заранее: изменение требований, подтверждение прототипа, новая версия контракта или смена команды. Пересмотр оценки при новых данных — нормальная часть процесса.
Шаблон оценки задачи для команды
Ниже — копируемый шаблон. Он не является формой обязательного стандарта. Используйте только поля, которые помогают вашему решению; для небольшой правки достаточно короткой записи.
| Поле | Что записать |
|---|---|
| Пользовательский результат | Что станет возможным после поставки |
| Границы | Что входит в текущую задачу и какие смежные результаты вынесены отдельно |
| Основание | Требования, макет, контракт, ссылка на обсуждение |
| Критерии приёмки | Проверяемые условия готовности |
| Данные и роли | Источники, ограничения, права |
| Состояния | Успех, пустой результат, ошибка, ожидание, повтор и отмена, если применимы |
| Компоненты | Что переиспользуется и что нужно создать |
| Качество | Доступность, устройства, производительность и другие согласованные требования |
| Неизвестные | Конкретные вопросы без предположений вместо ответа |
| Зависимости | Владелец, ожидаемый результат и влияние на срок |
| Аналоги | Завершённые задачи и существенные отличия |
| Выбранный метод | Что именно измеряется или оценивается и в каких единицах |
| Оценка | Значение или диапазон с условиями |
| Проверка | Ревью, тестирование, интеграция и выпуск в составе результата |
| Пересмотр | Событие, после которого оценка обновляется |
Для проекта добавьте общие компоненты, архитектурные проверки, сквозную приёмку и план поставки. Не копируйте один и тот же инфраструктурный объём во все карточки. Свяжите общие работы с зависимыми задачами.
Пример короткой записи
Учебная формулировка: «После загрузки согласованного файла пользователь видит результат проверки и может перейти к сопоставлению полей. Включены пустое состояние, ошибка формата и повтор выбора. Предполагается готовый контракт проверки; возобновление после перезагрузки вынесено отдельно. До оценки нужно подтвердить ограничение размера файла».
Здесь ещё нет числа, но уже есть объект оценки. После ответа на вопрос команда сможет сравнить задачу с аналогами или провести Planning Poker. Такой порядок уменьшает расхождение смыслов.
Пошаговый процесс оценки в команде
Рабочий процесс можно построить как последовательность решений. Не обязательно проводить отдельную встречу для каждого шага: важно сохранить сами результаты.
- Определите решение, ради которого нужна оценка. Выбор варианта, план итерации, прогноз релиза и предложение заказчику требуют разной детализации.
- Зафиксируйте результат и границы. Согласуйте критерии готовности и состав обязательной проверки.
- Разберите функции, данные и состояния. При необходимости подготовьте материал для COSMIC и SNAP.
- Оцените особенности реализации. Для существующего кода используйте метрики как сигналы, для нового — матрицу и прототипы.
- Выделите неизвестные и зависимости. Назначьте конкретные вопросы и проверки.
- Сравните с историей команды. Используйте аналоги или относительную оценку в согласованной шкале.
- Постройте прогноз. Учтите ресурсы, последовательность, ожидания и выбранный уровень осторожности.
- Вернитесь к оценке после выполнения. Разберите причины отклонения и улучшите основания следующего решения.
На выходе нужен не большой документ ради документа. Достаточно записи, по которой другой участник понимает, что обещано, на чём основано и что может измениться. Это делает оценку проверяемой.
Как использовать ИИ при оценке задач
ИИ можно применять для подготовки: извлечь из описания сценарии, предложить вопросы, сопоставить требования с макетами или собрать черновик таблицы состояний. Это помогает организовать обсуждение, если человек проверяет результат.
Не следует принимать число, выданное моделью, за измерение COSMIC или SNAP. Формальный расчёт требует правил, границы и прослеживаемого обоснования. Число без списка учитываемых элементов не становится объективным из-за уверенного объяснения.
Для метрик кода предпочтительнее воспроизводимый анализатор с зафиксированной конфигурацией. ИИ может помочь объяснить проблемный обработчик и предложить вариант рефакторинга. Но итоговый балл и сохранение поведения проверяются соответствующими инструментами и тестами.
Полезное задание для подготовки оценки
Можно сформулировать запрос так: «Выдели пользовательский результат, состояния, внешние зависимости и неизвестные. Не присваивай часы без аналогов. Для каждого предположения укажи, что нужно подтвердить». Такой черновик удобнее проверять, чем немотивированную смету.
Если используются внутренние документы, соблюдайте принятые правила доступа и обработки данных. Удобство инструмента не меняет принадлежность информации. Проверка требований остаётся ответственностью команды.
Типичные ошибки оценки
| Ошибка | Почему мешает | Как исправить |
|---|---|---|
| Один балл вместо всех характеристик | Размер, риск и срок смешиваются | Хранить профиль и прогноз отдельно |
| Количество экранов как вся оценка | Теряются состояния и интеграции | Сопоставить макеты со сценариями |
| Курс points в часы | Скрывает различия задач и контекста | Использовать историю команды и явную модель прогноза |
| CFP плюс SNAP points плюс code complexity | Складываются разные единицы | Связать показатели с требованиями без самодельного общего стандарта |
| Низкая сложность функции как гарантия лёгкой задачи | Распределённая логика остаётся за кадром | Анализировать сценарий и зависимости |
| Неизвестное записано как ноль | Недостаток данных выглядит простотой | Отдельный статус вопроса и проверка |
| Максимальный балл для любой неизвестности | Теряются причины и возможность уточнения | Называть предмет и влияние неизвестности |
| Несколько запасов на одну причину | Возникает двойной учёт | Проследить каждый резерв до основания |
| Только успешный сценарий | Ошибки и восстановление появляются поздно | Заранее описать состояния |
| Деление суммы на число людей | Игнорируются зависимости и доступность | Построить последовательность и ресурсный план |
| Отсутствие сравнения с фактом | Ошибки воспроизводятся | Разбирать причины, а не только отклонение числа |
Почему увеличение детализации не всегда улучшает точность
Разбиение большой неизвестной задачи на десятки неизвестных частей может дать красивую таблицу, но не новые знания. Если все строки зависят от неподтверждённой технологии, сначала нужно проверить её применимость.
Подробность полезна, когда раскрывает состав и границы. Лишние десятичные знаки не повышают надёжность. Показывайте точность, соответствующую доступным основаниям.
Как проверять качество самой оценки
После выполнения полезно сравнивать не только прогноз и факт. Выясните, что изменилось: объём, критерии готовности, доступность людей, внешний контракт или понимание существующего кода. Каждая причина требует своего улучшения.
Если оценка была верна при заявленных условиях, а условия изменились, это нужно отразить в истории. Если работа существовала в требованиях, но не попала в разбор, улучшайте анализ. Если команда систематически забывает выпуск и приёмку, уточните границу готовности.
Какие данные сохранять
Сохраните исходный объём, предположения, выбранный метод, прогноз, существенные изменения и фактический результат. Желательно знать, когда возникли новые сведения. Это позволит не переписывать историю оценки задним числом.
Сами наблюдения не обязаны превращаться в индивидуальный контроль разработчиков. Для обучения команды важны причины на уровне задачи и процесса. Сравнение людей по несопоставимым задачам даёт мало полезного для следующего прогноза.
Когда пересматривать систему критериев
Если критерий всегда получает одинаковое значение и не влияет на решения, возможно, его можно убрать. Если постоянные отклонения связаны с пропущенным фактором, добавьте конкретное наблюдаемое поле.
Не меняйте шкалу только ради красивого совпадения с прошлыми результатами. Новое правило должно помогать будущим решениям. Проверяйте его на новых завершённых работах и сохраняйте версию матрицы.
Частые вопросы
Какой метод оценки сложности самый точный?
У методов разные объекты. COSMIC измеряет функциональный размер, SNAP — нефункциональный размер в рамках правил, метрики анализируют код, statecharts описывают поведение. Точность прогноза работы зависит от требований, данных и модели перехода к усилиям и срокам.
Можно ли оценить проект только по макетам?
Макеты помогают составить инвентарь. Для обоснованной оценки нужны сценарии, состояния, данные, интеграции и критерии готовности. Статичный успешный экран обычно не отвечает на все эти вопросы.
COSMIC — это количество пользовательских действий?
Нет. Метод использует функциональные процессы и перемещения данных в заданной границе по собственным правилам. Список кликов может быть материалом анализа, но не равен формальному размеру CFP.
SNAP учитывает любую сложность вёрстки?
Не автоматически. Требование должно соответствовать области и правилам метода. Произвольный коэффициент за визуально насыщенный дизайн не является SNAP-измерением.
Можно ли сложить COSMIC и SNAP в одну оценку?
Результаты можно использовать как разные входы собственной модели усилий. Простая сумма единиц не образует стандартную меру. Нужно показать, как модель построена и где применима.
Чем Cognitive Complexity отличается от Cyclomatic Complexity?
Первая ориентирована на структурную трудность понимания потока управления, вторая — на линейно независимые пути. Они дают дополнительные сигналы, но не измеряют всю архитектуру и не задают часы разработки.
Сколько тестов нужно при заданной цикломатической сложности?
Из одной метрики нельзя вывести достаточный набор всех тестов. Важны критерий покрытия, данные, достижимость путей, асинхронность и продуктовые требования. Независимые пути — только часть картины.
Нужно ли внедрять XState ради оценки?
Нет. Сначала можно описать состояния и переходы таблицей. Выбор библиотеки — отдельное инженерное решение. Модель полезна ещё до реализации.
Можно ли использовать собственную матрицу сложности?
Да, если она явно названа внутренним инструментом, критерии определены, а неизвестные не скрываются. Её нельзя выдавать за валидированный стандарт или универсальную таблицу перевода в часы.
Один Story Point — это сколько часов?
Постоянного универсального курса нет. Для прогноза используют историю команды и выбранные предположения. Изменение контекста может потребовать пересмотра модели.
Planning Poker обязателен в Scrum?
Нет. Это один из способов обсуждения относительных оценок. Команда может выбрать другой подход, согласованный с работой и доступными данными.
Помогают ли эвристики Nielsen оценить трудозатраты?
Они помогают обнаружить проблему и уточнить требования. Трудозатраты оцениваются после выбора решения. Важность проблемы для пользователя не равна стоимости исправления.
Как оценивать задачу, если много неизвестного?
Назовите вопросы, влияющие на решение, и выберите способ их проверить. Дайте условную оценку только с явными предположениями. Если неизвестен сам принцип реализации, исследование может быть полезнее большого числа.
Нужно ли переоценивать задачи после начала работы?
Да, когда появились существенные новые сведения или изменились требования. Сохраните исходную оценку и причину изменения. Это позволяет учиться и корректировать прогноз, не переписывая историю.
Источники и границы применения
Определения методов опираются на первоисточники COSMIC, IFPUG, SonarSource, Stately, Scrum Guide, Scrum Alliance, Mountain Goat Software, React, W3C и Nielsen Norman Group. Ссылки приведены рядом с соответствующими утверждениями. Методики сравниваются по объекту, доступным входам, результату и ограничениям.
Учебный импорт, матрица факторов, шаблон карточки и арифметические примеры предложены для объяснения. Они не подтверждают конкретную производительность и не заменяют официальных руководств формального измерения. Команде следует проверять их пригодность на собственной работе.
Как подготовить оценку проекта со студией Владимира Ломтева
Для проектов с ИИ применимы направления студии по анализу процессов, подготовке данных, разработке MVP и тестированию интеграций. На этапе подготовки можно разобрать один пользовательский сценарий, описать данные и внешние зависимости, а затем определить критерии приёмки пилотного решения. Это конкретные основания будущей оценки, без обещания фиксированной точности или экономии.
Первый шаг — выбрать процесс и собрать его текущее описание: кто пользуется системой, какие данные доступны, какие ограничения обязательны и какой результат нужно принять. Если требуется ИИ-интеграция, полезно отдельно обозначить роль модели и действия, которые остаются под контролем человека. Обсудить задачу.
С чего начать оценку сложности задач и проектов
Начните с результата и границ, затем разберите данные, состояния и ограничения. Используйте COSMIC и SNAP там, где нужен формальный размер, метрики кода — для существующей реализации, statecharts — для поведения, матрицу — для относительного профиля, Story Points — для командного обсуждения, эвристики Nielsen — для проверки удобства.
После этого стройте прогноз усилий и срока на подходящих данных и явных предположениях. Сохраняйте неизвестные, зависимости и условия пересмотра. Полезная оценка позволяет объяснить решение, проверить его после выполнения и улучшить следующее планирование.