Apache Parquet — открытый бинарный колоночный формат файлов для хранения и чтения структурированных данных. Он сохраняет схему и типы полей, поддерживает сжатие и позволяет аналитическому движку выбирать нужные колонки. Parquet полезен для истории продаж, событий, выгрузок из учётных систем и наборов данных для машинного обучения. Его выбор особенно оправдан, когда одни и те же массивы регулярно фильтруют и агрегируют. Определение проекта Apache Parquet.
Представьте компанию, которая каждый день выгружает заказы. Руководителю нужны продажи по месяцам, аналитику — повторные покупки, ML-разработчику — история спроса. Если каждый процесс заново разбирает текстовые файлы и по-своему определяет типы, возникают лишние операции и расхождения. Parquet даёт общий формат подготовленного слоя, а смысл показателей, качество исходных данных и права доступа остаются задачами системы.
Руководство предназначено для аналитиков, разработчиков и руководителей, которые выбирают способ хранения аналитических данных. Разберём устройство файла, отличие от CSV и JSON, чтение через Python и SQL, партиционирование и границы применения. Настройка распределённого кластера и промышленного хранилища требует отдельного проекта.
Документация проверена 3 ноября 2026 года. Примеры PyArrow и DuckDB ниже действительно выполнены локально на шести вымышленных строках. Проверены запись, обратное чтение, фильтрация, SQL-агрегация и чтение набора с партициями. Скорость на больших объёмах, экономия места и работа в облачном хранилище не измерялись.
Содержание:
- Для каких задач бизнесу нужен Parquet
- Как работает колоночное хранение
- Из чего состоит файл: row group, column chunk и page
- Зачем Parquet нужны метаданные и footer
- Схема и типы: что сохраняется вместе с данными
- NULL, вложенные объекты и совместимость читателей
- Parquet, CSV и JSON: какой формат выбрать
- Чем Parquet отличается от Arrow, базы данных и Iceberg
- Сжатие и кодирование: Snappy, Zstandard и словари
- Как фильтры помогают читать меньше данных
- Как открыть и прочитать файл Parquet
- Проверенный пример: запись Parquet через Python и PyArrow
- Что получилось при локальном чтении и SQL-запросе
- Партиционирование: когда одного файла становится мало
- Как выбирать размер файлов и избегать мелких партиций
- Как изменять схему и обновлять данные
- Где Parquet находится в ИИ- и ML-процессе
- Типичные ошибки и их исправление
- Частые вопросы о Parquet
Для каких задач бизнесу нужен Parquet
Смотрите на повторяющуюся работу с данными. Если сотрудники передают друг другу небольшую таблицу и редактируют её вручную, удобство обмена может оказаться важнее устройства хранения. Если из истории операций постоянно строят разные отчёты, становится полезен единый типизированный набор, который читают программно.
Например, у интернет-магазина есть события заказов, платежей и возвратов. Из них можно подготовить отдельные аналитические таблицы: позиции заказов, изменения статусов, дневные остатки. Parquet подходит для сохранения таких подготовленных выгрузок. При этом файл должен иметь понятную гранулярность: одна строка означает позицию заказа, событие или остаток на дату. Смешивание этих сущностей испортит расчёты независимо от формата.
| Задача | Какую роль может выполнять Parquet | Что нужно определить отдельно |
|---|---|---|
| Управленческая аналитика | Хранить историю операций для отчётов | Определения выручки, возвратов и периода |
| Прогноз спроса | Сохранять подготовленные признаки и целевые значения | Горизонт прогноза и доступность признаков на дату расчёта |
| Анализ событий | Содержать нормализованные события для выборок | Идентификатор события и правило устранения дублей |
| Обмен между обработчиками | Передавать таблицу с явными типами | Совместимость конкретных читателей и писателей |
| Архив аналитических срезов | Сохранять датированные наборы | Состав среза, срок хранения и порядок восстановления |
Это варианты архитектуры, а не результаты внедрения у клиентов. Для общей организации исходных данных полезен отдельный материал о подготовке данных для ИИ.
Как работает колоночное хранение
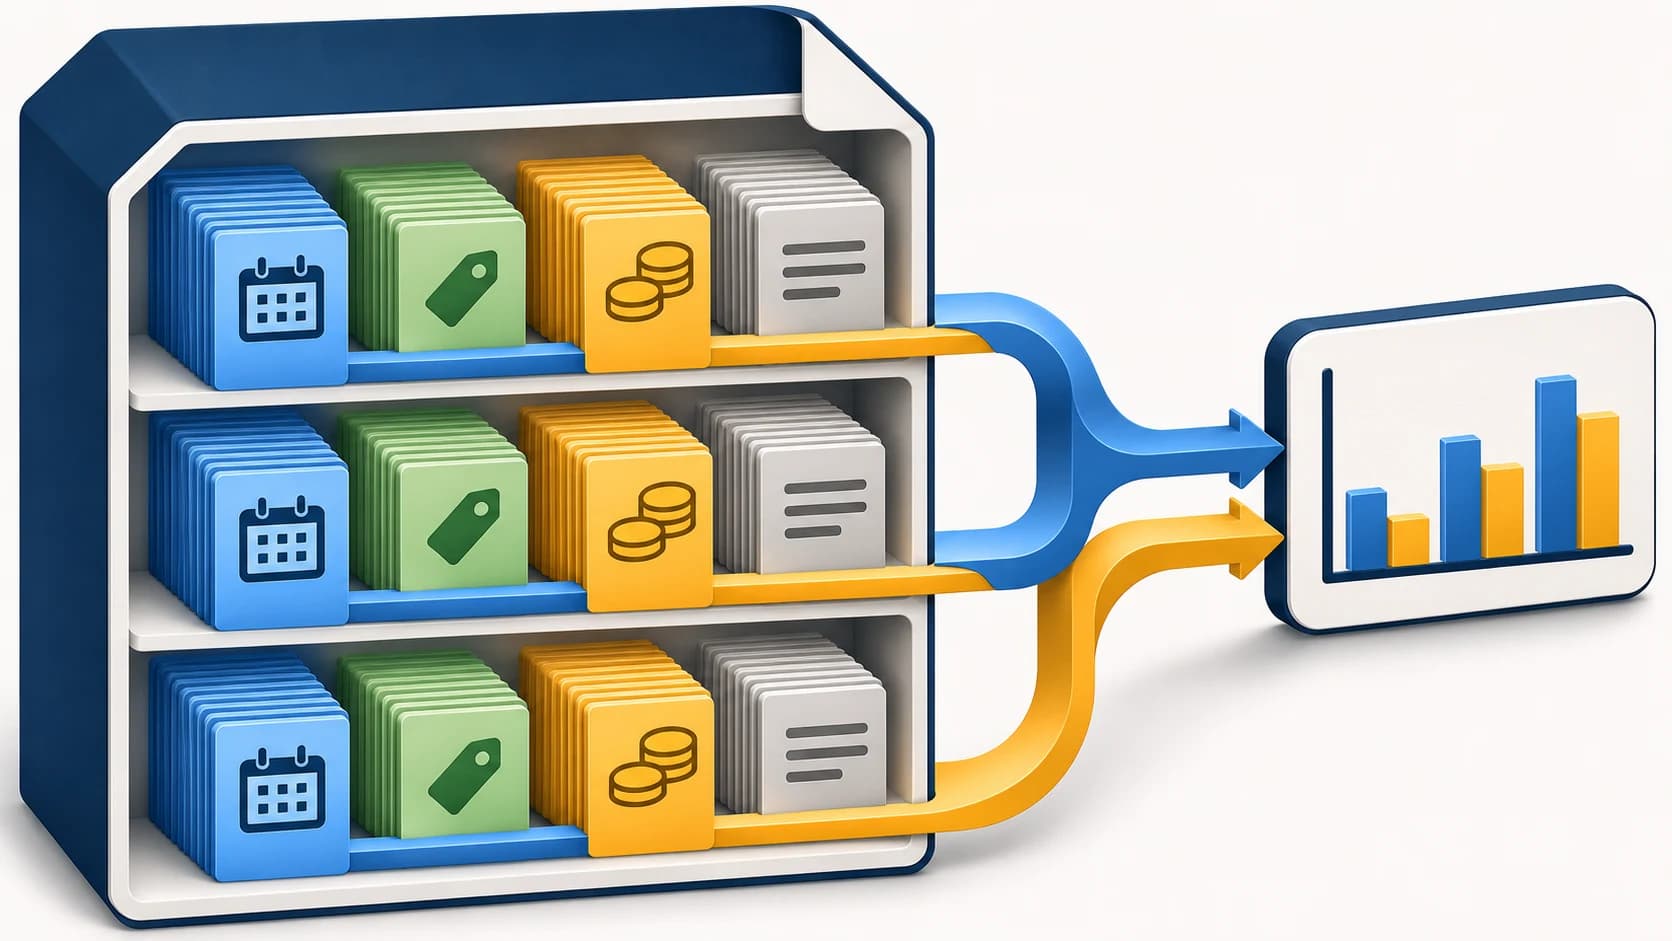
В привычной таблице мы видим строки: заказ, дата, товар, количество, сумма. При колоночном хранении значения одной колонки организованы вместе внутри соответствующих частей файла. Если отчёту нужны дата и сумма, движок может запросить эти поля без обязательного чтения всех текстовых описаний. Возможность выборочного чтения колонок используется, например, в PyArrow. Источник: чтение Parquet в Apache Arrow.
Предположим, в выгрузке есть длинный комментарий менеджера, адрес доставки и технический JSON. Для подсчёта количества заказов по датам они не нужны. Выбор только необходимых полей уменьшает объём данных, который требуется передать в последующую обработку. Если же запросу нужны все колонки и все строки, преимущество выборочного чтения сокращается.
Колоночная организация помогает объяснить, почему Parquet часто выбирают для аналитики. Но из неё нельзя вывести универсальное ускорение «в десять раз». На результат влияют сами данные, запрос, библиотека, сжатие, накопитель и расположение файлов. В этой статье нет сравнительного теста производительности.
Из чего состоит файл: row group, column chunk и page
В Parquet используются три основных уровня организации данных. Row group — группа строк. Внутри неё для каждой колонки находится column chunk, то есть блок значений этой колонки. Он состоит из pages, страниц данных. Страницы связаны с кодированием и сжатием, блок колонки — с чтением соответствующего поля. Такая иерархия определена в официальном описании понятий Parquet.
Представьте журнал заказов, разбитый на несколько последовательных групп. Каждая группа содержит свои даты, товары и суммы, но значения разных полей физически организованы отдельно. Читатель сначала определяет подходящие группы и поля, а затем декодирует нужные части. Это упрощённая модель для понимания, а не побайтовая схема конкретного файла.
Размер row group влияет на компромисс между последовательным чтением, использованием памяти и возможностью пропускать группы. Поэтому «файл большой» и «row group большой» — разные характеристики. В одном файле могут находиться несколько групп строк; в небольшом демонстрационном файле ниже их будет три.
Зачем Parquet нужны метаданные и footer
Метаданные описывают структуру файла и расположение частей данных. В обычной структуре Parquet служебная информация о файле записывается после данных, ближе к концу — в области, которую обычно называют footer. Читатель использует её, чтобы найти интересующие блоки колонок. Порядок размещения описан в спецификации файлового формата.
Из этого следует практический вывод: корректное завершение записи имеет значение. Наличие файла с расширением .parquet ещё не подтверждает, что набор готов для потребителей. Процесс публикации данных должен отделять запись от появления готовой версии в рабочем каталоге.
Метаданные файла и заголовки страниц выполняют разные функции. Первые помогают навигации по файлу, вторые участвуют в чтении и декодировании отдельных страниц. Источник: Metadata в Apache Parquet. При диагностике полезно сначала посмотреть схему, число строк и групп, а затем пытаться выгрузить всю таблицу в память.
Схема и типы: что сохраняется вместе с данными
У Parquet есть небольшой набор физических типов: целые числа, числа с плавающей точкой, логические значения и массивы байтов. На их основе строится представление данных в файле. Физические типы Parquet.
Логические типы уточняют смысл: строка, десятичное число, дата, временная метка. Например, для DECIMAL важны precision — общее количество цифр — и scale — число знаков после десятичной точки. Для временных меток важны единица измерения и семантика времени. Эти сведения описаны в спецификации логических типов.
В проекте стоит письменно определить схему до массовой записи. Идентификатор клиента может состоять только из цифр, но оставаться строкой. Цена требует согласованной точности, а дата операции — отличаться от времени её загрузки. Формат сохранит переданную ему структуру; смысл полей задаёт команда.
В учебном примере unit_price имеет тип decimal128(12, 2), SKU — строковый, order_date — дата. Это выбранная схема демонстрации. Она не устанавливает универсальные требования к бухгалтерским данным, валютам или товарным справочникам.
NULL, вложенные объекты и совместимость читателей
Отсутствующее значение нужно отличать от нуля, пустой строки и пустого списка. Для бизнеса разница существенна: цена неизвестна, товар бесплатный и поле не передано источником — разные ситуации. В примере одна цена равна нулю, другая отсутствует; после записи и чтения эти состояния должны сохраниться.
Parquet умеет представлять вложенные структуры и повторяющиеся значения. Для этого используются уровни определения и повторения, позволяющие описать наличие вложенных полей и элементы повторяющихся структур. Подробности приведены в Nested Encoding. Для первого аналитического набора удобнее начать с понятной плоской таблицы, если задача не требует списков и объектов.
Поддержка возможностей зависит от конкретной реализации. Фраза «обе системы умеют Parquet» не заменяет проверки десятичных полей, временных меток, вложенных типов и выбранного кодека. Apache публикует таблицу поддержки реализаций. Её полезно использовать для планирования, а окончательно проверять собственную пару «запись → чтение» на нужных версиях.
Parquet, CSV и JSON: какой формат выбрать
CSV удобен для простого табличного обмена, JSON — для сообщений и объектов с полями, Parquet — для программной аналитической работы с типизированными таблицами. Базовые свойства текстовых форматов описаны в документации CSV и спецификации JSON. Выбор зависит от потребителя. Если партнёр принимает только CSV по утверждённому шаблону, внутреннее использование Parquet не отменяет этот контракт обмена.
| Критерий | CSV | JSON | Parquet |
|---|---|---|---|
| Чтение обычным текстовым редактором | Удобно для небольших файлов | Удобно для отдельных объектов и небольших наборов | Нужен инструмент, понимающий бинарный формат |
| Типы полей | Обычно задаются правилами импорта | Есть базовые JSON-типы; бизнес-семантика задаётся отдельно | Схема и типы включены в формат |
| Выбор отдельных колонок при аналитическом чтении | Не основное свойство формата | Не основное свойство формата | Соответствует колоночной организации |
| Ручное редактирование | Возможно, но требует аккуратности | Возможно, но легко нарушить структуру | Обычно меняют через обработчик и повторную запись |
| Типичный участок процесса | Обмен таблицами | API и сообщения | Подготовленные аналитические наборы |
Таблица описывает обычные способы применения, а не запрет использовать другие варианты. CSV можно сжимать, JSON можно хранить построчно, для текстовых форматов можно строить дополнительные индексы. При сравнении реальных решений нужно учитывать весь процесс, а не только расширение файла.
Если исходный CSV уже потерял цифры идентификатора, конвертация не восстановит их. В таком случае сначала верните корректный источник. Этому посвящён разбор сохранения артикулов и цен при подготовке CSV для ИИ. Здесь основная задача другая: организация подготовленного набора и его аналитическое чтение.
Чем Parquet отличается от Arrow, базы данных и Iceberg
Apache Arrow и Parquet решают разные задачи представления данных. В нашем примере Arrow Table — таблица, с которой работает программа, а Parquet — формат, в который она записывается на диск. Между ними выполняются чтение и запись. Поэтому поддержка Arrow в библиотеке и наличие Parquet-файла — разные части одного процесса.
Parquet-файл также не заменяет целую СУБД. Чтобы выполнять SQL, нужен движок: например, DuckDB читает Parquet напрямую через read_parquet. Для приложения с частыми изменениями отдельных записей, конкурентными операциями и транзакционными требованиями выбор рабочего хранилища следует делать отдельно от формата аналитической выгрузки.
Apache Iceberg относится к уровню табличного формата: он описывает таблицы, снимки, метаданные и согласованные изменения поверх файлов данных. Parquet может быть форматом самих файлов внутри такой таблицы. Эти уровни рассматриваются в спецификации Iceberg. Обычная папка с Parquet-файлами сама по себе не приобретает свойства управляемой Iceberg-таблицы.
Практический выбор можно сформулировать так: сначала определите, какие операции должна поддерживать система. Затем выберите движок и способ управления таблицей. Формат файла будет частью решения, а не всей архитектурой.
Сжатие и кодирование: Snappy, Zstandard и словари
В Parquet кодирование данных и сжатие — разные механизмы. Словарное кодирование заменяет повторяющиеся значения ссылками на словарь; если словарь становится слишком большим, реализация может перейти к обычному кодированию. Это особенно понятно на примере колонки статуса заказа, где значения повторяются. Описание кодирований Parquet.
Кодек сжатия работает с данными страниц. Спецификация предусматривает несколько вариантов, включая Snappy, GZIP и Zstandard. Их характеристики связаны с компромиссом между размером и стоимостью обработки; доступность нужно проверять в инструментах чтения и записи. Спецификация сжатия.
В локальной демонстрации выбран compression="zstd". Это явная настройка воспроизводимого примера, а не доказательство, что Zstandard оптимален для любой нагрузки. На рабочем наборе сравнивайте время записи, размер, время нужных запросов и потребление ресурсов. Сравнение должно использовать одинаковые исходные данные и одинаковый смысл запросов.
Не рассчитывайте экономию только по одному очень маленькому файлу. У формата есть служебные структуры, и их доля меняется с объёмом и составом данных. Для решения о хранении важнее повторяемая рабочая нагрузка, чем красивый коэффициент из чужой презентации.
Как фильтры помогают читать меньше данных
Есть два полезных механизма. Projection pushdown означает передачу выбора колонок на уровень чтения. Predicate pushdown — передачу условий фильтра туда, где читаются данные. Если метаданные позволяют исключить часть групп строк, движок может не обрабатывать их полностью. Возможности зависят от читателя и конкретного условия; поддержка фильтров документирована в PyArrow read_table.
Смысл можно показать на датах. Если группа содержит только октябрьские заказы, а запросу нужен ноябрь, диапазон значений помогает понять, что эта группа не подходит. Если в каждой группе перемешаны даты за несколько лет, границы будут широкими и пропустить данные сложнее. Это причина согласовывать порядок записи с частыми фильтрами.
Сортировка перед записью и подбор row groups относятся к настройке набора. DuckDB отдельно объясняет, как порядок строк влияет на пропуск групп по статистике. Parquet Tips. Но само наличие WHERE ещё не доказывает, сколько байтов было прочитано: для такого вывода нужны план и измерения конкретного выполнения.
Как открыть и прочитать файл Parquet
Для начала нужны инструмент чтения и доступ к файлу. В Python удобно использовать PyArrow; SQL-пользователю может подойти DuckDB. В промышленном процессе следует закрепить версии и проверить поддержку схемы в конечном инструменте. Открытие в произвольном текстовом редакторе покажет бинарное содержимое, а не удобную таблицу.
Начинайте с метаданных: названия колонок, типы, число строк, количество групп. После этого прочитайте несколько нужных полей или ограниченную часть данных. Не преобразуйте весь большой файл в список Python-объектов только ради просмотра первых записей.
Для порционного чтения PyArrow предоставляет ParquetFile.iter_batches(): он возвращает последовательность пакетов записей. Это позволяет строить обработку без обязательного чтения всей таблицы одним вызовом. Возможности метода перечислены в справочнике ParquetFile. Дальнейшее накопление всех пакетов в одном списке снова потребует памяти, поэтому порционность нужно сохранять и в последующих этапах.
В демонстрации ниже to_pylist() безопасен по объёму именно потому, что возвращаются две учебные строки. Его использование здесь не является рекомендацией для полной выгрузки большого набора.
Проверенный пример: запись Parquet через Python и PyArrow
Ниже создаётся вымышленная таблица из шести позиций заказов. Поле quantity означает количество единиц в позиции, unit_price — цену одной единицы в рублях. Идентификаторы текстовые, цена десятичная, дата имеет календарный тип. Один заказ отменён, другая позиция ожидает обработки и не имеет цены.
Создайте отдельную рабочую папку. Для обычного Linux/macOS-окружения установка в виртуальное окружение выглядит так:
python3 -m venv .venv
.venv/bin/python -m pip install pyarrow==26.0.0 duckdb==2.0.0
Эти версии использованы при локальном запуске с Python 3.14.3. Команды установки выполнены в изолированном окружении; возможность установки на другой ОС и архитектуре здесь не проверялась. Актуальные требования следует сверять с документацией установки PyArrow. На Windows путь к интерпретатору виртуального окружения отличается.
Сохраните следующий код в demo_parquet.py. Он останавливается, если orders.parquet уже существует, чтобы случайно не заменить прежний пример.
from datetime import date
from decimal import Decimal
from pathlib import Path

import duckdb
import pyarrow as pa
import pyarrow.parquet as pq

# Запускайте в новой рабочей папке: существующий файл не перезаписываем.
path = Path("orders.parquet")
if path.exists():
    raise FileExistsError("Выберите новую папку или сохраните прежний orders.parquet")

schema = pa.schema([
    ("order_id", pa.string()),
    ("order_date", pa.date32()),
    ("sku", pa.string()),
    ("quantity", pa.int32()),
    ("unit_price", pa.decimal128(12, 2)),
    ("status", pa.string()),
])

data = {
    "order_id": ["o1", "o2", "o3", "o4", "o5", "o6"],
    "order_date": [date(2026, 10, 30), date(2026, 10, 31),
                   date(2026, 11, 1), date(2026, 11, 1),
                   date(2026, 11, 2), date(2026, 11, 2)],
    "sku": ["00123", "A-17", "00123", "000123456789012345", "A-17", "B-04"],
    "quantity": [2, 1, 1, 3, 2, 1],
    "unit_price": [Decimal("1299.90"), Decimal("2500.50"),
                   Decimal("1299.90"), Decimal("0.00"),
                   Decimal("2500.50"), None],
    "status": ["paid", "paid", "paid", "cancelled", "paid", "pending"],
}
table = pa.table(data, schema=schema)
pq.write_table(table, path, compression="zstd", row_group_size=2)

restored = pq.read_table(path)
assert restored.equals(table)
pf = pq.ParquetFile(path)
print("Строк:", pf.metadata.num_rows)
print("Row groups:", pf.metadata.num_row_groups)
print("Схема:", restored.schema)

selected = pq.read_table(
    path,
    columns=["order_id", "sku", "unit_price"],
    filters=[("order_date", ">=", date(2026, 11, 1)),
             ("status", "=", "paid")],
)
print("Выборка:", selected.to_pylist())

query = """
SELECT sku, SUM(quantity * unit_price) AS amount
FROM read_parquet('orders.parquet')
WHERE order_date >= DATE '2026-11-01' AND status = 'paid'
GROUP BY sku
ORDER BY sku
"""
with duckdb.connect() as con:
    print("SQL:", con.execute(query).fetchall())
Запуск:
.venv/bin/python demo_parquet.pyПараметры записи описаны в pyarrow.parquet.write_table. Значение row_group_size=2 здесь специально маленькое: оно позволяет увидеть три группы на шести строках. Переносить эту настройку в промышленную выгрузку не следует. Размер группы в этой функции задаётся числом строк, а не байтов.
Что получилось при локальном чтении и SQL-запросе
Обратное чтение дало таблицу, равную исходной по проверке restored.equals(table). Метаданные показали шесть строк и три row groups. Сохранились строковые SKU, дата, тип decimal128(12, 2) и отсутствующее значение цены. Это функциональная проверка конкретной пары библиотек и учебных данных, а не доказательство совместимости всех систем.
Фильтр выбрал оплаченные позиции с датой начиная с 1 ноября 2026 года. Из шести исходных записей вернулись o3 и o5. Условие использует order_date и status, хотя в возвращаемой таблице оставлены только order_id, sku и unit_price. Так разделяются поля для фильтра и поля результата.
Тот же файл прочитал DuckDB. SQL сгруппировал позиции по SKU и сложил произведения количества на цену. Прямое чтение Parquet в DuckDB не требует предварительно создавать постоянную таблицу базы.
| SKU | Сумма по условию примера, руб. | Из каких данных получена |
|---|---|---|
00123 |
1299,90 | Одна оплаченная ноябрьская позиция, количество 1 |
A-17 |
5001,00 | Одна оплаченная ноябрьская позиция, количество 2 |
Отменённая позиция не вошла из-за статуса. Позиция без цены тоже не вошла из-за статуса, поэтому этот запрос не проверяет отдельное правило работы агрегата с неизвестной ценой. В реальной аналитике такое правило нужно сформулировать явно: исключать запись, показывать предупреждение или вычислять другой показатель.
Важно и значение слова «сумма». Здесь нет скидок, налоговых расчётов, возвратов или нескольких валют. Результат нельзя автоматически назвать бухгалтерской выручкой. Для бизнес-определений полезен материал о семантическом слое ИИ-аналитика.
Партиционирование: когда одного файла становится мало
Партиционирование распределяет набор по частям на основе выбранных ключей. В распространённом Hive-подходе значение записывается в имени каталога: например, month=2026-11. Читатель, понимающий такую структуру, использует значение как поле набора. Этот подход описан в документации Hive Partitioning DuckDB.
Если большинство запросов относится к отдельному месяцу, такая организация может помочь отбирать нужные файлы. Если запросы всегда захватывают всю историю, дробление по месяцам само по себе не гарантирует пользу. Выбор ключа должен следовать типовым запросам и распределению данных.
Чтобы продолжить пример, добавьте следующий фрагмент в конец demo_parquet.py и запустите весь скрипт в новой пустой рабочей папке. Переменные table, data и pa создаются основным кодом, поэтому этот фрагмент не предназначен для отдельного запуска.
import pyarrow.dataset as ds

partitioned = table.append_column(
    "month",
    pa.array([day.strftime("%Y-%m") for day in data["order_date"]]),
)
ds.write_dataset(
    partitioned,
    base_dir="orders_by_month",
    format="parquet",
    partitioning=ds.partitioning(
        pa.schema([("month", pa.string())]), flavor="hive"
    ),
    existing_data_behavior="error",
)
dataset = ds.dataset("orders_by_month", format="parquet", partitioning="hive")
november = dataset.to_table(
    columns=["order_id", "sku", "unit_price"],
    filter=(ds.field("month") == "2026-11") & (ds.field("status") == "paid"),
)
print("Партиция:", sorted(november["order_id"].to_pylist()))
API записи и поведение при существующих данных определены в write_dataset. Здесь выбран режим existing_data_behavior="error": повторное использование непустого назначения требует отдельного решения. В локальной проверке появились каталоги двух месяцев; фильтр по ноябрю и оплаченному статусу снова вернул o3 и o5.
Это демонстрация семантики партиций. Не измерялось, сколько файлов и байтов читатель фактически пропустил, и не проверялась работа с удалённым объектным хранилищем.
Как выбирать размер файлов и избегать мелких партиций
Не делайте отдельный файл для каждой строки и отдельную партицию для каждого уникального заказа. Такой подход может создать множество объектов, которые затем придётся перечислять, открывать и обслуживать. Аналитическая задача обычно требует более крупной единицы обработки.
Вместо универсального «правильного размера» начните с вопросов: сколько данных поступает за период, какие фильтры используют отчёты, сколько параллельных читателей работает и какой запас памяти есть у обработчика. Затем сравните несколько вариантов на одной нагрузке. Меняйте по одному фактору, чтобы понять причину результата. Факторы производительности разбираются в руководстве DuckDB по файловым форматам; приведённые там результаты чужих нагрузок нельзя переносить на свои данные.
Row group и размер файла на диске регулируются разными параметрами; одинаковое число строк может занимать разное место из-за ширины полей и сжатия. Параметры вроде ROW_GROUP_SIZE в разных движках нельзя автоматически считать полностью одинаковыми по поведению. Ограничения конкретной реализации нужно читать в её документации.
Для рабочего набора полезны операции укрупнения мелких файлов, если это подтверждено наблюдениями. При их проектировании учитывайте потребителей: они должны видеть согласованную версию данных, а не случайную смесь старых и новых частей во время перезаписи.
Как изменять схему и обновлять данные
Схема может меняться: появилась валюта, новый статус, признак канала продаж. Добавление колонки и изменение смысла существующей — разные события. Особенно опасна ситуация, когда поле продолжает называться amount, но раньше означало сумму без доставки, а теперь включает её.
Зафиксируйте правила: какие поля обязательны, какие допускают отсутствие, как трактуется неизвестное значение, что считается совместимым расширением. Новую схему проверяйте на инструментах, которые действительно читают набор. Не полагайтесь только на успешное создание одного нового файла.
DuckDB предоставляет union_by_name, позволяющий объединять файлы с разным набором колонок по именам и заполнять отсутствующие значения NULL. Это документированная возможность читателя, а не универсальный механизм управления версиями схемы. Совместимость типов и бизнес-смысл всё равно требуют проверки. Источник: Parquet Tips.
Для простого периодического набора может хватить новой версии каталога с понятной датой публикации. Если нужны согласованные изменения таблицы, параллельные записи, снимки и удаление отдельных записей, рассматривайте подходящий табличный слой или СУБД. Постоянно усложняющийся самописный протокол обновления — повод пересмотреть архитектуру. Ограничения согласованности при работе с обычными файловыми наборами разобраны в документации Arrow Datasets.
Где Parquet находится в ИИ- и ML-процессе
В машинном обучении удобно разделить исходные события, подготовленные признаки и конкретные обучающие выборки. Parquet может хранить табличные результаты этих этапов. Рядом должны существовать сведения об источнике, периоде, версии преобразований и правиле формирования целевой переменной.
Например, для прогноза спроса важно знать, какие остатки и цены были доступны на момент прогнозирования. Случайное добавление будущих сведений в признаки создаст утечку целевой информации. Формат файла сам не обнаружит такую ошибку; её предотвращают правила построения выборки и проверки данных.
Для LLM-аналитики полезна другая граница: приложение выполняет разрешённый запрос к структурированному набору, а модель получает результат подходящего размера и объясняет его пользователю. Передавать целую историю заказов в текстовый контекст без необходимости обычно нецелесообразно. При этом право на выполнение запроса и доступ к колонкам должны определяться вне сгенерированного ответа.
Parquet также не является векторным индексом и не выполняет поиск по смыслу сам по себе. Он может быть частью хранения текстов, идентификаторов или подготовленных представлений, но поиск, актуальность корпуса и контроль доступа обеспечиваются отдельными компонентами. Поэтому выбор Parquet для слоя данных не решает весь проект корпоративного ИИ-ассистента.
Типичные ошибки и их исправление
| Ошибка | Как проявляется | Что изменить |
|---|---|---|
| Конвертировали данные без явной схемы | В разных файлах одна колонка получила разные типы | Определить схему и проверить чтение совместно |
| Проверили только число строк | Потеряны NULL, точность или смысл идентификатора | Сравнить типы, ключи и показательные значения |
| Читают все поля для одного показателя | В обработку попадают ненужные данные | Указать нужные колонки и исследовать план запроса |
| Создали слишком дробные партиции | Каталог состоит из множества мелких частей | Пересмотреть ключи и укрупнение на своей нагрузке |
| Публикуют каталог во время перезаписи | Потребители получают несогласованный срез | Разделить подготовку и публикацию версии |
| Принимают уменьшение файла за ускорение | Рабочий запрос всё ещё выполняется медленно | Отдельно измерить чтение, обработку и передачу результата |
| Считают бинарный файл защищённым | Доступны чувствительные поля | Настроить права и обработку данных в инфраструктуре |
Сжатие и бинарное представление не являются политикой доступа. Точно так же успешное чтение файла не подтверждает корректность показателя. Обе границы нужно учитывать при передаче набора между командами.
Частые вопросы о Parquet
Можно ли использовать Parquet без Hadoop и Spark?
Да. В этой статье файл создан и прочитан локально через PyArrow, а SQL выполнен в DuckDB. Наличие распределённого кластера не требуется для показанного сценария. Выбор кластера зависит от рабочей нагрузки и инфраструктуры.
Станет ли любой CSV меньше и быстрее после конвертации?
Такого обещания дать нельзя. Результат зависит от состава данных, кодека, размера набора и запроса. Нужно проверить собственную нагрузку. Здесь сравнительные размеры и время не измерялись.
Можно ли открыть Parquet в pandas?
У pandas есть интерфейс read_parquet; для него нужен поддерживаемый движок. Условия и параметры перечислены в официальной справке pandas. В локальном примере pandas не устанавливался и не проверялся: использовались PyArrow и DuckDB.
Можно ли исправить одну строку прямо в файле?
Для обычного прикладного процесса рассчитывайте на преобразование и повторную запись соответствующей части набора. Если задача требует частых изменений отдельных записей и согласованных транзакций, выбирайте подходящий уровень управления таблицей. Само расширение .parquet этих требований не реализует.
Сохраняет ли Parquet исходную бизнес-логику?
Он сохраняет представленные значения и структуру в рамках возможностей используемых инструментов. Но определения показателей, правила округления, фильтры отмен и распределение прав нужно документировать отдельно. Иначе два корректных SQL-запроса могут отвечать на разные вопросы под одним названием показателя.
Когда лучше оставить CSV?
Когда нужен небольшой понятный человеку файл, ручной обмен или обязательный шаблон внешней системы. Внутренний аналитический слой при этом может использовать Parquet, а на границе обмена формировать CSV. Эти решения можно сочетать в одном процессе.
Как AI студия Владимира Ломтева помогает построить слой данных для ИИ
В проекте важен путь от исходных операций к воспроизводимому набору для отчёта или модели. AI студия Владимира Ломтева может помочь подготовить данные и схему полей, связать источники с аналитическим или ИИ-процессом, настроить тестирование преобразований. Для задач прогнозирования к этому добавляется подготовка данных под выбранную ML-задачу.
Первый шаг — выбрать один процесс: например, ежемесячный анализ заказов. Определите текущий способ расчёта, источники, ограничения доступа и критерий результата. После этого можно обоснованно выбрать Parquet, способ обновления и инструменты чтения. Обсудить задачу.
Как принять решение о Parquet
Parquet стоит рассматривать для регулярно используемых аналитических таблиц, где важны явные типы, выбор колонок и совместимость обработчиков. Начните с одного набора и нескольких реальных вопросов к нему. Опишите схему, запишите данные, прочитайте их конечным инструментом и сравните значения и смысл результата.
Локальная демонстрация показывает, как устроить этот путь на небольшом примере. Для рабочего решения дополнительно нужны правила публикации версий, изменение схемы, доступ и измерения своей нагрузки. Такой порядок позволяет выбрать формат по задаче и избежать переноса демонстрационных настроек в промышленный процесс без проверки.