Если кэширование промптов Claude не даёт чтений из кэша, сначала разделите две ситуации: префикс вообще не записывается или записывается заново при каждом запросе. Их различают поля cache_creation_input_tokens и cache_read_input_tokens в usage. Затем проверяют длину общей части, положение cache_control, совпадение содержимого и интервал между запросами.
Материал подготовлен AIrassvet по официальной документации Anthropic, проверенной 21 октября 2026 года. Он предназначен разработчику интеграции и владельцу бизнес-процесса, у которого повторно обрабатываются обращения с одной длинной инструкцией. Речь о прямом Claude API: правила Bedrock, других провайдеров и настройки приложения Claude нельзя автоматически переносить сюда.
Это документированный порядок диагностики, а не отчёт о нашем запуске Claude. Сценарий поддержки и числа ниже условные; реальную экономию, совместимость вашей версии SDK и доступность аккаунта мы не измеряли.
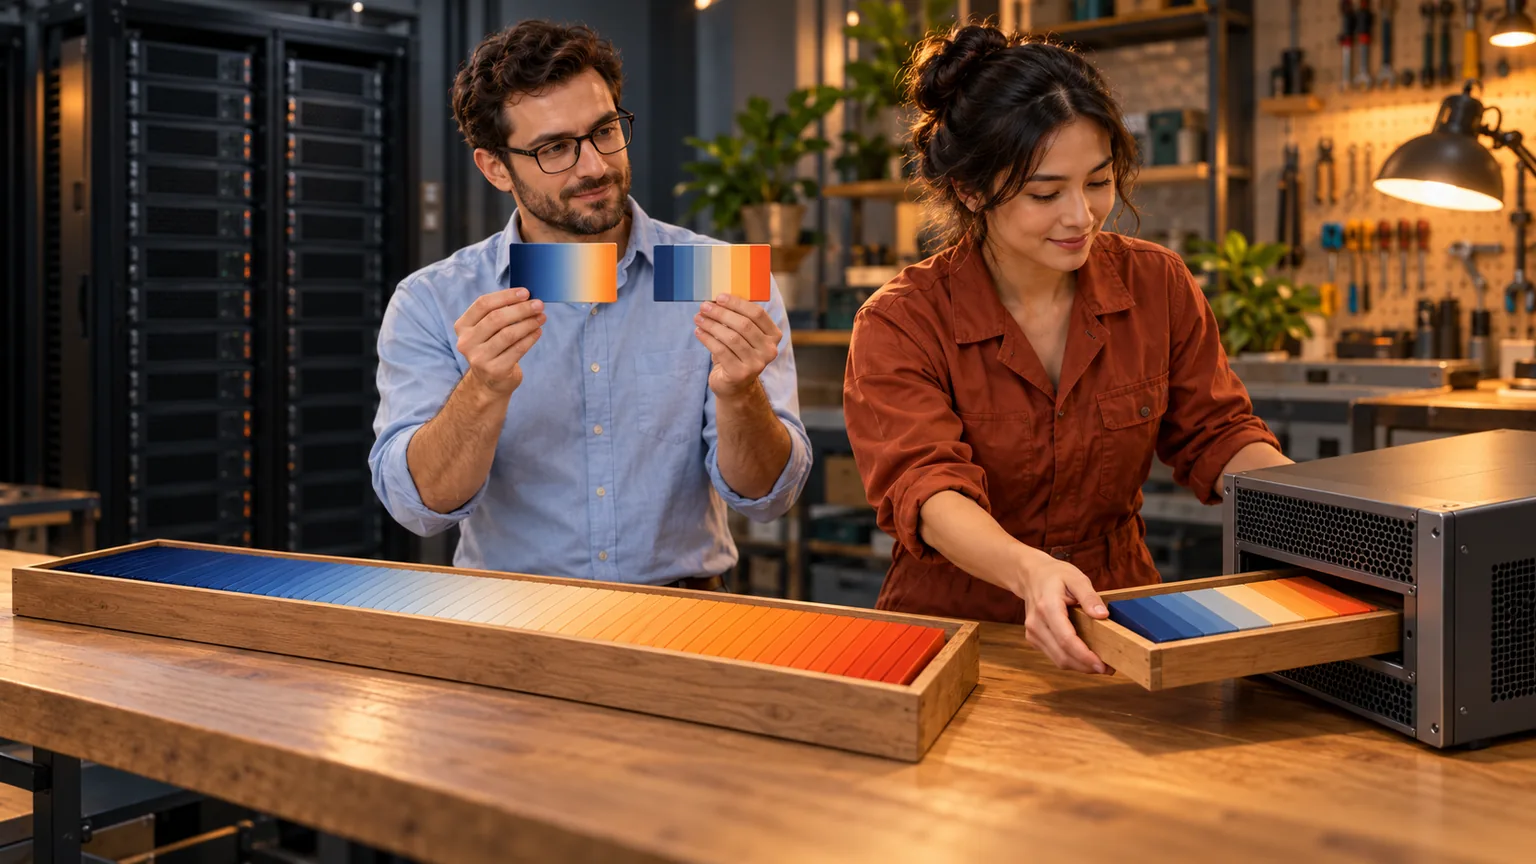
*Иллюстрация показывает общий префикс и изменяемое окончание запроса; это не интерфейс Claude и не результат испытания.*
Содержание
- Что именно должно переиспользоваться
- Симптом: оба счётчика равны нулю
- Симптом: запись есть каждый раз, чтения нет
- Симптом: иногда работает, иногда исчезает
- Симптом: длинный диалог теряет старую запись
- Как подтвердить причину и проверить исправление
- Почему попадание в кэш ещё не означает экономию
- Как AIrassvet помогает разобрать повторную обработку контекста
- С чего начать исправление
Что именно должно переиспользоваться
Prompt caching — повторное использование уже обработанного начала запроса, или префикса. Это не выдача сохранённого ответа на похожий вопрос. В Claude важны одинаковые блоки до выбранной границы включительно; совпадения по смыслу недостаточно. Порядок формирования префикса: определения инструментов tools, системные инструкции system, затем история messages. Источник: устройство кэширования Anthropic.
Представим службу поддержки поставщика оборудования. Каждое обращение обрабатывается с одинаковыми правилами классификации, описаниями категорий и примерами. Текст клиента меняется. Полезный общий префикс здесь заканчивается после правил и примеров, перед конкретным обращением.
Если дата, идентификатор заявки или персональный контекст стоят в начале инструкции, последующие одинаковые абзацы не образуют прежнего префикса. Переносить разрешённые переменные данные ближе к концу можно только с сохранением смысла и прав доступа: нельзя объединять разные клиентские инструкции ради попадания в кэш.
Симптом: оба счётчика равны нулю
Сначала откройте полный usage ответа. При потоковой выдаче эти поля находятся в событии message_start. Для обычного текстового запроса смотрите три составляющие входа:
| Поле usage | Что показывает | Как использовать при диагностике |
|---|---|---|
cache_creation_input_tokens |
Токены, записанные в кэш | Ненулевое значение подтверждает запись, а не экономию |
cache_read_input_tokens |
Токены, прочитанные из кэша | Ненулевое значение подтверждает переиспользование в данном запросе |
input_tokens |
Обычные входные токены вне чтения и записи кэша | Это не весь вход при включённом кэшировании |
Полный вход получают сложением этих трёх величин. Если чтение и запись равны нулю, кэш в этом запросе не использован; одна из вероятных причин — слишком короткая кэшируемая часть. Это диагностическая гипотеза, а не однозначное объяснение любого нуля. Источник: поля usage и ограничения.
Проверьте, включено ли кэширование и достигает ли префикс минимальной длины именно вашей модели. Например, текущая документация указывает 512 токенов для Claude Sonnet 5.5 и 4096 для Claude Haiku 4.5 в прямом API. Короткий префикс с cache_control может обработаться без кэша и без ошибки. Универсального порога для всех Claude нет. Источник: минимальная длина.
Считать нужно общую часть до границы, а не только весь запрос. Длинное письмо после короткой инструкции само по себе не делает эту инструкцию пригодной для кэширования. Эндпоинт подсчёта токенов помогает оценить размер, но не выполняет кэширование и не доказывает попадание. Подсчитайте подготовленный общий контекст для выбранной модели, затем проверьте реальные поля usage при создании сообщения. Источник: token counting.
Не дописывайте бессмысленные абзацы ради порога. Если общей полезной части мало, оставьте обычный запрос: затраты на раздувание контекста и сопровождение тоже имеют значение.
Симптом: запись есть каждый раз, чтения нет
Для независимых обращений проверьте, не оказалась ли граница после переменного текста. Anthropic записывает префикс в позиции cache_control. Поиск назад ищет ранее записанные позиции; он не создаёт автоматически отдельную запись на конце любой стабильной части. Поэтому отметка после меняющегося обращения может давать новую запись без переиспользования общих правил. Источник: поиск префикса и типичная ошибка.
Для нашего вымышленного сценария исправление выглядит так:
- Отделите постоянные правила классификации от текста обращения и времени его получения.
- Поместите постоянные инструкции и примеры в стабильные блоки; сохраните одинаковые определения инструментов перед ними.
- Поставьте явный
cache_controlна последний стабильный блок. - Передавайте новую заявку после этой границы и сравните
usageпоследовательных запросов.
Ниже пример устройства запроса, не готовое тело API и не результат выполненного теста. Надпись «граница кэша» означает положение параметра на последнем стабильном блоке, а не текст, который нужно отправлять модели:
tools: неизменные определения инструментов
system: общие правила + категории + примеры [граница кэша]
messages: текст конкретного обращения
Сам параметр на этом блоке выглядит так:
{"cache_control": {"type": "ephemeral"}}Этот фрагмент нужно включить в полноценный запрос своей интеграции. Размер общего префикса, модель и реальные ответы остаются предметом вашей проверки.
Автоматическое кэширование с cache_control на верхнем уровне удобно для растущего диалога: граница перемещается вслед за историей. Для независимых заявок с разными окончаниями явная граница на общих правилах даёт более понятный контроль. Выбирайте по структуре задачи, а не по принципу «автоматическое всегда лучше». Источник: автоматическое и явное кэширование.
Симптом: иногда работает, иногда исчезает
Сначала сопоставьте время начала запросов. Обычный TTL — время жизни кэша — составляет 5 минут; чтение обновляет его. По документации отсчёт идёт от начала запроса, который записал или прочитал запись, а не от завершения ответа. Если генерация заняла почти весь этот интервал, пауза пользователя после ответа может оказаться достаточной для истечения записи. Источник: время жизни кэша.
При более редком повторении общего контекста рассмотрите ttl: "1h" внутри cache_control. Часовая запись оплачивается иначе; более длинный срок имеет смысл оценивать по частоте повторов и текущим тарифам. Он не исправляет меняющийся префикс. Не включайте регулярные пустые запросы для поддержания кэша, не посчитав их стоимость и необходимость. Источник: часовой TTL.
Вторая причина — параллельный холодный старт. Запись становится доступной после начала первого ответа. Если отправить всю пачку одновременно, первые запросы могут не прочитать ещё не появившуюся запись. Для диагностической проверки сначала отправьте один запрос, дождитесь начала ответа, затем запускайте остальные. Это документированное условие доступности записи, не обещание стопроцентного попадания. Источник: параллельные запросы.
Третья причина — изменение конфигурации. Сравнивайте одну модель, один workspace, одинаковые tools, system, настройки tool_choice, thinking и output_config.effort. Изменение инструмента в начале влияет на следующие уровни префикса. Не отключайте нужную проверку или инструмент только ради кэша: иногда промах — нормальная цена необходимого изменения. Источник: инвалидация.
Симптом: длинный диалог теряет старую запись
Если история растёт, а начало остаётся прежним, проверьте расстояние до предыдущей записанной позиции. Документация описывает окно поиска назад до 20 позиций на границу, считая саму границу первой. В прямом Claude API последовательные блоки tool_use учитываются одной позицией, как и последовательные tool_result; считать просто количество вызванных функций неверно. Источник: окно поиска.
Когда предыдущая запись оказывается вне окна, дополнительная явная граница ближе к нужному месту может сохранить доступный путь переиспользования. Её следует предусмотреть так, чтобы там успела появиться запись. Добавление отметки задним числом не создаёт уже существовавший кэш в прошлых запросах.
Это отдельный случай растущей истории. Для независимых обращений со стабильной инструкцией сначала исправляйте границу до переменного текста; не усложняйте схему несколькими отметками без обнаруженной причины.
Как подтвердить причину и проверить исправление
В прямом Claude API есть cache diagnostics: сравнение структуры двух запросов. По текущей документации первый запрос должен включать diagnostics с previous_message_id: null, чтобы сохранить диагностический отпечаток. В следующем указывают id предыдущего ответа в diagnostics.previous_message_id. Отсутствие объекта в первом запросе означает отсутствие его отпечатка для такого сравнения. Источник: порядок включения диагностики.
Диагностика помогает локализовать расхождение модели, инструментов, системного текста или истории. При этом отсутствие расхождения не доказывает чтение из кэша: структурное сравнение независимо от реального попадания. Окончательный признак переиспользования — cache_read_input_tokens из ответа. Истечение TTL тоже нельзя опровергнуть одним совпадением структуры. Источник: диагностика вместе с usage.
Предлагаемая проверка исправления — на двух обезличенных или искусственных обращениях с одними правилами:
- Зафиксируйте модель, workspace, инструменты и точную версию общего текста. Уберите из сравнения посторонние изменения конфигурации.
- Выполните первый запрос с выбранной границей; сохраните
usage, время начала и идентификатор ответа. Запись может быть ненулевой, если этот префикс ещё не прогрет. - После начала первого ответа выполните второй в пределах TTL. Меняйте только обращение после общей границы. Ожидаемый признак успешного переиспользования — ненулевое чтение общей части.
- Если чтение не появилось, вернитесь к длине префикса, границе, структуре и времени. Не объявляйте исправление по одному исчезновению ошибки API.
- Проверьте, что классификация всё ещё соответствует правилам. Хороший показатель кэша сам по себе ничего не говорит о правильности ответа.
Это план для вашей среды, здесь он не выполнялся. Не сохраняйте API-ключи и тексты клиентов в общедоступные логи; одного идентификатора и чисел для первичного сравнения часто достаточно. Общие принципы наблюдаемости разобраны в статье о мониторинге LLM и ИИ-агентов.
Почему попадание в кэш ещё не означает экономию
Условный второй запрос вернул чтение 3000 токенов, запись 0 и обычный вход 200. Полный вход — 3200 токенов, доля прочитанного входа — 3000 / 3200 = 93,75%. Это арифметический пример интерпретации счётчиков, а не наш результат и не скидка на весь счёт.
Оплата зависит также от записи, генерации ответа и тарифов выбранной модели. Чтение длинного префикса может сочетаться с дорогим длинным ответом. При редком повторении стоимость первоначальной записи может не окупиться. Поэтому сравнивайте суммарные расходы на одинаковое число полезных обращений при одинаковых требованиях к качеству, а не только долю чтения. Источник: тарифы кэширования.
Более широкие решения — маршрутизация моделей, длина контекста и распределение расходов — описаны в материале о контроле затрат при росте токенов. Здесь задача уже: объяснить конкретный промах и подтвердить переиспользование общей части.
Как AIrassvet помогает разобрать повторную обработку контекста
В рамках аудита процесса и интеграции ИИ можно поставить три конкретные задачи: выделить общий контекст и переменные данные обращений; определить состав технических показателей для проверки переиспользования; проверить интеграцию и качество классификации после изменения структуры запроса. Это работы из направлений подготовки данных, интеграции и тестирования, перечисленных на сайте AIrassvet.
Первый шаг — выбрать один поток обращений, описать исходные расходы, источники данных, ограничения и критерий готовности. Результат такого разбора должен помочь принять решение об изменении структуры или сохранении текущего подхода; процент экономии заранее неизвестен. Обсудить задачу.
С чего начать исправление
Начните с пары реальных usage, а не с увеличения TTL. Два нулевых счётчика направляют к включению кэша и длине общей части; постоянная запись без чтения — к изменяемому префиксу и границе; нерегулярные промахи — к времени, параллельности и конфигурации. В длинной истории дополнительно проверьте окно поиска.
Готовность подтверждают чтение общей части в подходящем повторном запросе и сохранение качества задачи. После этого считайте расходы целого процесса. Так кэширование становится проверяемым изменением интеграции, а не обещанием скидки за один параметр.