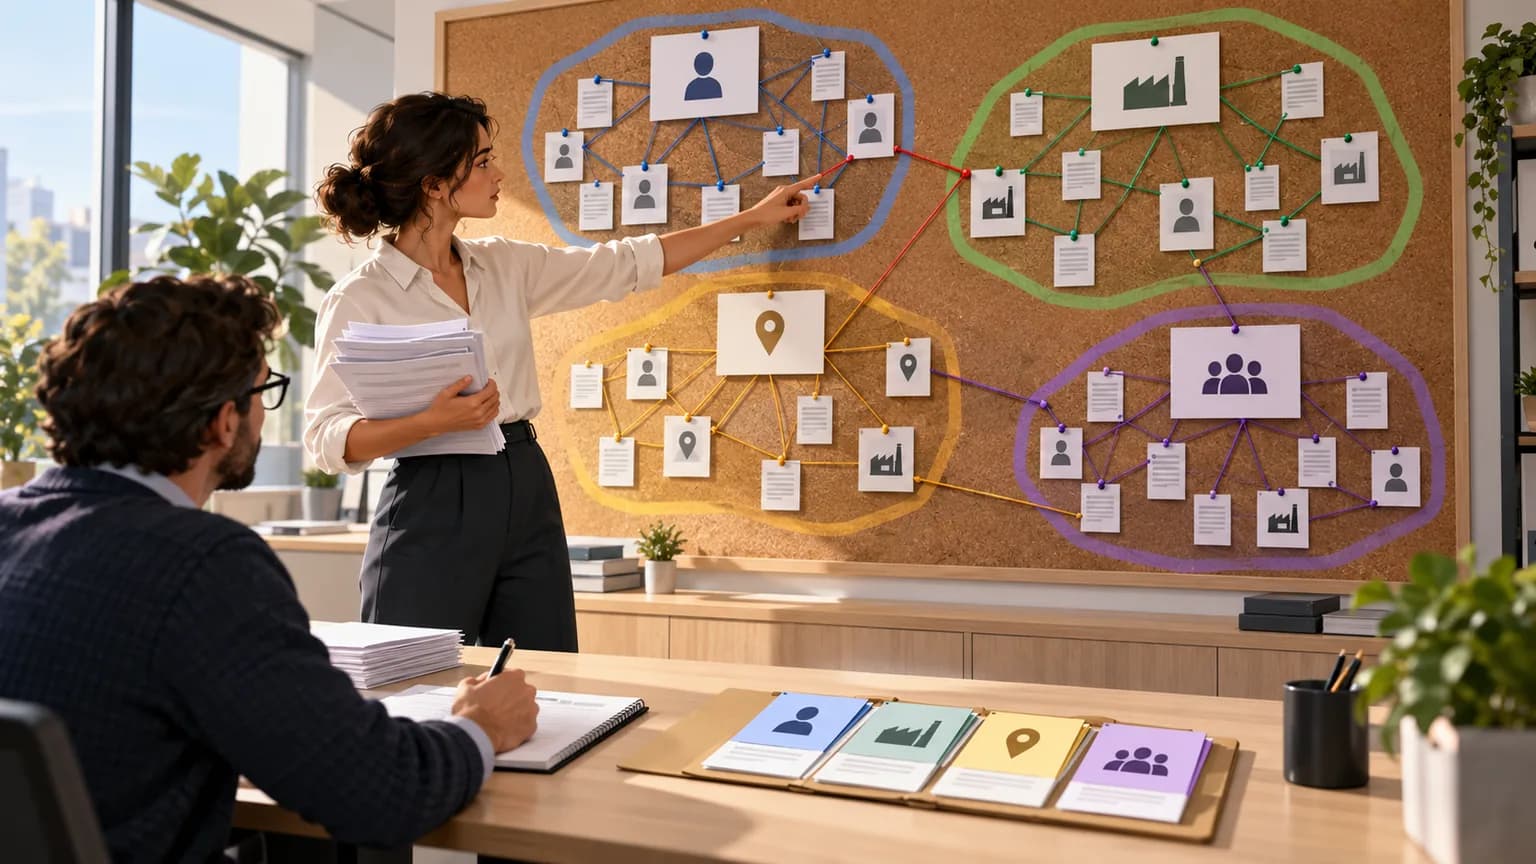
GraphRAG — это подход к RAG, в котором языковая модель сначала строит из документов граф знаний: сущности, связи между ними и сводки по группам связанных сущностей. При ответе система опирается не только на похожие фрагменты текста, но и на этот граф, поэтому лучше отвечает на вопросы «по всему корпусу», например «какие основные темы в переписке проекта».
Материал подготовлен AIrassvet 25 октября 2026 года для руководителей, ИТ-директоров и владельцев баз знаний, которые выбирают архитектуру ИИ-поиска по документам компании. Он опирается на статью Microsoft Research о GraphRAG, документацию и репозиторий проекта, публикацию Microsoft о LazyGraphRAG и статью о LightRAG. Собственных замеров мы не проводили: все цифры приведены по первоисточникам с указанием условий. В статье мы объясняем принцип работы, ограничения и критерии выбора, но не разбираем установку конкретной библиотеки, настройку промптов и выбор графовой СУБД.
Содержание
- Кратко
- Что такое GraphRAG
- Чем GraphRAG отличается от обычного RAG
- Как GraphRAG строит граф знаний
- Как GraphRAG отвечает на вопросы
- Что показало исследование Microsoft
- Где GraphRAG полезен бизнесу
- Ограничения: когда GraphRAG не нужен
- GraphRAG, LazyGraphRAG и LightRAG: в чём разница
- Как решить, нужен ли вам GraphRAG
- Глоссарий
- Первоисточники и метод проверки
Кратко
- Что это: RAG, который перед ответом строит граф знаний из ваших документов и готовит сводки по группам связанных сущностей.
- Зачем: обычный векторный RAG хорошо находит конкретный фрагмент, но плохо отвечает на вопросы о корпусе в целом и на вопросы, где нужно связать разрозненные факты.
- Чем подтверждено: в статье Microsoft Research на двух корпусах примерно по 1 млн токенов глобальный поиск GraphRAG выигрывал у векторного RAG по полноте ответа в 72–83% сравнений.
- Чем платите: индексация требует много вызовов языковой модели; авторы прямо предупреждают, что она может быть дорогой, и советуют начинать с малого.
- Когда не нужен: если пользователи задают точечные вопросы вида «какой срок поставки в договоре № 15», обычный или гибридный поиск дешевле и прямее.
Что такое GraphRAG
Чтобы понять GraphRAG, нужны три термина.
RAG (retrieval-augmented generation, генерация с дополненным поиском) — схема, в которой модель перед ответом получает найденные фрагменты из документов компании. Подробно архитектуру мы разбирали в статье про RAG-систему для бизнеса.
Граф знаний — структура из узлов и рёбер. Узлы — сущности: люди, компании, продукты, места, документы. Рёбра — связи между ними: «поставляет», «подписал», «упоминается вместе с». Граф хранит не текст целиком, а то, кто с кем и как связан.
Сообщество в графе — группа сущностей, которые тесно связаны между собой сильнее, чем с остальными. Например, поставщик, его договоры, ответственный менеджер и претензии по этим договорам.
GraphRAG соединяет эти идеи. В документации Microsoft его описывают как структурированный иерархический подход к RAG в противовес «наивному» семантическому поиску по фрагментам текста. Модель извлекает из текста граф, система делит граф на сообщества разного уровня, а модель пишет по каждому сообществу краткую сводку. Эти сводки и сам граф затем используются при ответе.
Проект открыт Microsoft Research: статья «From Local to Global: A Graph RAG Approach to Query-Focused Summarization» появилась на arXiv 24 апреля 2024 года, код опубликован на GitHub под лицензией MIT, первый релиз — в июле 2024 года.
Чем GraphRAG отличается от обычного RAG
Обычный, или базовый, RAG разбивает документы на фрагменты, превращает их в векторы и ищет фрагменты, похожие на вопрос. Как устроено хранение таких векторов, мы объясняли в статье о векторных базах данных. Документация GraphRAG называет две ситуации, где такой подход работает плохо: когда ответ требует «соединить точки» через общие признаки разрозненных фактов и когда нужно целостно понять большую коллекцию документов.
| Критерий | Векторный RAG | GraphRAG |
|---|---|---|
| Что хранит | Фрагменты текста и их векторы | Фрагменты, сущности, связи, сообщества и их сводки |
| Как готовит индекс | Нарезка и векторизация, без генерации текста | Модель читает каждый фрагмент и извлекает сущности и связи, затем пишет сводки |
| Лучшие вопросы | Точечные: найти условие, цифру, пункт | Обзорные и связующие: темы, участники, цепочки связей |
| Прямота ответа | Выше: в исследовании Microsoft векторный RAG давал самые прямые ответы | Ответы полнее и разнообразнее, но длиннее |
| Обновление | Добавили документ — пересчитали его векторы | Нужно обновить граф, сообщества и сводки |
| Стоимость индексации | Низкая | Высокая: много вызовов модели |
Важно: GraphRAG не отменяет векторный поиск. Локальный режим GraphRAG по-прежнему использует исходные фрагменты текста, а в библиотеку встроен и «базовый» векторный режим для сравнения.
Как GraphRAG строит граф знаний
Документация Microsoft описывает индексацию так. Мы пересказываем шаги и поясняем, что происходит на каждом.
- Нарезка на текстовые единицы. Корпус делится на фрагменты (TextUnits). Они нужны и для анализа, и для ссылок на источник в ответе. Размер фрагмента влияет на стоимость: в статье отмечено, что более длинные фрагменты требуют меньше вызовов модели. Как выбирать размер, мы разбирали в материале о чанкинге документов.
- Извлечение сущностей, связей и утверждений. Языковая модель читает каждый фрагмент и выписывает сущности, связи между ними и ключевые утверждения.
- Кластеризация графа. Граф делится на иерархию сообществ алгоритмом Лейдена: от крупных групп верхнего уровня до мелких.
- Сводки по сообществам. Модель пишет краткое описание каждого сообщества снизу вверх: сначала мелкие группы, затем крупные. Так появляется «карта» корпуса на нескольких уровнях детализации.
- Векторы для поиска. Для фрагментов и сущностей строятся векторные представления, чтобы находить точку входа в граф по вопросу пользователя.
Масштаб на примере из статьи: корпус расшифровок подкаста объёмом около 1 млн токенов превратился в граф из 8 564 узлов и 20 691 ребра. Индексация с фрагментами по 600 токенов заняла 281 минуту на виртуальной машине с 16 ГБ памяти через API gpt-4-turbo.
Как GraphRAG отвечает на вопросы
В документации описаны четыре режима поиска. Выбор режима — ключевое решение при проектировании, потому что режимы сильно различаются по цене и по типу вопросов.
| Режим | Как работает | Для каких вопросов |
|---|---|---|
| Global Search | Обходит сводки сообществ по схеме map-reduce: каждая сводка даёт частичный ответ, затем частичные ответы сводятся в итоговый | «Какие основные темы?», «Что объединяет жалобы клиентов за год?». Документация называет режим ресурсоёмким |
| Local Search | Находит сущности из вопроса, расходится к их соседям и добавляет исходные фрагменты текста | Вопросы о конкретной сущности: поставщике, продукте, человеке |
| DRIFT Search | Локальный поиск плюс сведения о сообществах; уточняет вопрос через дополнительные подвопросы | Вопросы о сущности, где важен более широкий контекст |
| Basic Search | Обычный векторный поиск top-k фрагментов | Точечные вопросы и сравнение с базовым RAG |
На практике это значит, что «GraphRAG» — не одна кнопка. Для системы, где большая часть вопросов точечные, а обзорные встречаются редко, может хватить локального режима и редких глобальных запросов.
Что показало исследование Microsoft
Авторы сравнивали GraphRAG с векторным RAG и с суммаризацией исходного текста без графа на двух наборах данных:
- расшифровки подкаста Behind the Tech — около 1 млн токенов;
- новостные статьи с сентября 2013 по декабрь 2023 года — около 1,7 млн токенов.
Вопросы были «обзорными»: о темах, тенденциях и выводах по корпусу в целом. Ответы попарно сравнивала другая языковая модель (подход LLM-as-a-judge) по критериям полноты, разнообразия, полезности для читателя и прямоты.
Основные результаты по статье (версия 2 от 19 февраля 2025 года):
- Полнота. Глобальные подходы выигрывали у векторного RAG в 72–83% сравнений на подкасте и в 72–80% на новостях.
- Разнообразие. Выигрыш составил 75–82% и 62–71% сравнений соответственно.
- Прямота. По этому контрольному критерию лучшим оказался векторный RAG: его ответы самые короткие и конкретные.
- Экономия контекста. Сводки верхнего уровня потребовали более чем на 97% меньше токенов на запрос, чем суммаризация исходного текста, и всё равно выиграли у векторного RAG по полноте в 72% и по разнообразию в 62% сравнений.
Авторы сами указывают ограничения: проверены только два корпуса около 1 млн токенов, обобщение на другие домены требует дополнительных исследований, а частота выдумок в ответах не сравнивалась. Для бизнеса это означает: результаты показывают потенциал на обзорных вопросах, но не гарантируют выигрыша на ваших документах.
Где GraphRAG полезен бизнесу
Ниже — типы задач, где по описанию метода граф даёт преимущество. Это наши примеры применения, а не задокументированные кейсы.
- Аналитика обращений и отзывов. «Какие темы жалоб растут и какие продукты в них упоминаются вместе?» — обзорный вопрос по тысячам текстов.
- Переписка и документы крупного проекта. «Кто участвовал в согласовании изменений и какие решения из этого вышли?» — нужна цепочка связей между людьми, письмами и протоколами.
- Проверка контрагентов и due diligence. Связи между компаниями, учредителями, договорами и судебными делами естественно ложатся в граф.
- Исследования рынка и конкурентов. Свести десятки отчётов в карту игроков, продуктов и тенденций.
- Техническая документация с перекрёстными ссылками. Узлы, компоненты, регламенты и инциденты, которые ссылаются друг на друга.
Общий признак: ценность ответа не в одном найденном абзаце, а в связях между многими документами.
Ограничения: когда GraphRAG не нужен
Стоимость индексации. В README репозитория прямо написано, что индексация GraphRAG может быть дорогой операцией, и рекомендовано начинать с малого. Модель читает каждый фрагмент, поэтому затраты растут вместе с объёмом корпуса. Точную сумму для вашего архива можно получить только пилотом на части документов.
Частые обновления. Если документы меняются ежедневно, граф, сообщества и сводки нужно поддерживать в актуальном состоянии. Для быстро меняющихся баз знаний это отдельная инженерная задача.
Качество извлечения зависит от промптов. Документация предупреждает, что «из коробки» GraphRAG может давать не лучшие результаты, и настоятельно советует настроить промпты под свои данные. Для русскоязычных документов, отраслевой терминологии и сокращений это особенно важно: ошибки извлечения сущностей переходят в граф.
Точечные вопросы. Если пользователь ищет конкретный пункт договора или артикул, граф не нужен. Здесь эффективнее гибридный поиск и reranker.
Статус проекта Microsoft. На 25 октября 2026 года README репозитория microsoft/graphrag сообщает, что проект в основном находится в режиме поддержки: новые функции не разрабатываются, выпускаются исправления ошибок и обновления зависимостей. Сам код также помечен как демонстрация методологии, а не официально поддерживаемый продукт Microsoft. Для промышленной системы это аргумент заранее продумать, кто будет сопровождать выбранную реализацию.
GraphRAG, LazyGraphRAG и LightRAG: в чём разница
У идеи графового RAG есть несколько реализаций. Сравним три, о которых есть первоисточники.
| Критерий | GraphRAG (Microsoft) | LazyGraphRAG (Microsoft) | LightRAG (HKUDS) |
|---|---|---|---|
| Как строит индекс | Модель извлекает сущности и связи, пишет сводки сообществ | Без модели: извлечение именных групп методами NLP; все вызовы модели откладываются до запроса | Модель извлекает сущности и связи; граф объединён с векторными представлениями |
| Заявленная стоимость индексации | Высокая, по README | По данным Microsoft, как у векторного RAG и 0,1% от полного GraphRAG | Позиционируется как более быстрая и дешёвая альтернатива GraphRAG |
| Обновление данных | Требует пересчёта структур | Индекс дешёвый, пересчитать проще | Заявлены инкрементальное добавление и выборочное удаление документов |
| Хранилища | Файлы и поддерживаемые хранилища | — | Neo4j, PostgreSQL и другие; хранилища по умолчанию авторы называют неподходящими для продакшна |
| Доступность | Открытый код, MIT, режим поддержки | По заметке Microsoft от 6 июня 2025 года — в составе Microsoft Discovery и Azure Local (публичное превью) | Открытый код, MIT |
По LazyGraphRAG Microsoft также сообщает о стоимости запроса более чем в 700 раз ниже глобального поиска GraphRAG при сопоставимом качестве ответов на обзорные вопросы. Это данные самого разработчика, независимой проверки мы не нашли.
У LightRAG есть практическая деталь: модель эмбеддингов нужно выбрать до индексации, а её смена требует пересчитать векторы для фрагментов, сущностей и связей. Как выбирать такую модель, мы описали в чек-листе выбора модели эмбеддингов.
Как решить, нужен ли вам GraphRAG
Мы предлагаем пройти пять вопросов по порядку. Это наша схема рассуждения, а не стандарт отрасли.
- Какие вопросы задают пользователи? Соберите 30–50 реальных вопросов и разметьте их: точечный, о конкретной сущности, обзорный. Если обзорных почти нет, начните с векторного или гибридного RAG.
- Нужны ли связи между документами? Если ответ обычно лежит в одном документе, граф избыточен. Если нужно связать людей, договоры и события из разных источников — это аргумент за граф.
- Как часто меняются документы? Ежедневные изменения повышают стоимость поддержки графа. Архив и редко обновляемые регламенты — удобнее.
- Какой бюджет на индексацию? Проведите пилот на части корпуса и посчитайте фактические вызовы модели. Без пилота оценка стоимости будет догадкой.
- Где должна работать модель? Индексация отправляет в модель весь корпус. Если документы нельзя передавать во внешний сервис, нужна модель на собственных серверах.
Если ответы указывают на граф, начните с гибрида: векторный или гибридный поиск для точечных вопросов и граф для обзорных. Сравнивайте варианты на одном наборе контрольных вопросов.
Глоссарий
- RAG — генерация ответа моделью с опорой на найденные фрагменты документов.
- Граф знаний — сеть сущностей (узлов) и связей между ними (рёбер).
- Сущность — объект, о котором идёт речь в тексте: человек, организация, продукт, место, событие.
- Сообщество — группа тесно связанных сущностей в графе.
- Алгоритм Лейдена — метод поиска сообществ в графе, который GraphRAG использует для иерархической кластеризации.
- Сводка сообщества — краткое описание группы сущностей, написанное моделью на этапе индексации.
- Глобальный поиск — ответ по сводкам сообществ обо всём корпусе.
- Локальный поиск — ответ о конкретной сущности через её соседей в графе и исходные фрагменты.
- Токен — единица текста, которую обрабатывает языковая модель; по токенам считают объём корпуса и стоимость вызовов.
Первоисточники и метод проверки
Мы проверили каждое утверждение о GraphRAG по первоисточникам 25 октября 2026 года:
- Edge D. et al. From Local to Global: A Graph RAG Approach to Query-Focused Summarization, arXiv:2404.16130, версия 2 от 19.02.2025 — описание метода, наборы данных, результаты и ограничения;
- Документация GraphRAG и описание режимов поиска — шаги индексации и четыре режима;
- Репозиторий microsoft/graphrag — лицензия MIT, предупреждение о стоимости, статус режима поддержки;
- Microsoft Research: LazyGraphRAG: setting a new standard for quality and cost, 25.11.2024 — данные о стоимости приведены по публикации разработчика;
- Guo Z. et al. LightRAG: Simple and Fast Retrieval-Augmented Generation, arXiv:2410.05779, и репозиторий LightRAG — архитектура, хранилища, обновления, лицензия.
Мы не запускали GraphRAG на собственных данных. Сценарии применения и схема из пяти вопросов — наша редакционная интерпретация. Стоимость индексации в рублях не приводим: она зависит от модели, объёма корпуса и настроек.
Как AIrassvet помогает внедрить RAG на графе знаний
Выбор между векторным, гибридным и графовым RAG лучше делать на ваших вопросах и документах, а не по общим обзорам. На сайте AIrassvet среди направлений указаны RAG-системы и корпоративные базы знаний, развёртывание LLM на серверах заказчика, а также аудит процессов, подготовка данных, разработка MVP и тестирование. Для этой задачи это означает:
- аудит вопросов пользователей и корпуса: какая доля вопросов обзорная и где действительно нужны связи между документами;
- подготовку документов и прототип базы знаний, в котором векторный поиск и граф сравниваются на одном наборе контрольных вопросов;
- развёртывание языковой модели в контуре компании, если документы нельзя отправлять во внешний сервис на индексацию.
Первый шаг — выбрать один процесс, где сотрудники ищут ответы в документах, и зафиксировать текущий результат, источники данных, ограничения и критерий приёмки.
Итог: GraphRAG нужен для вопросов о связях, а не для поиска абзаца
GraphRAG строит из документов граф знаний и сводки по группам связанных сущностей. В исследовании Microsoft это дало более полные и разнообразные ответы на обзорные вопросы, чем векторный RAG, но ценой дорогой индексации и менее прямых ответов.
Если ваши пользователи спрашивают «что происходит в целом» и «как это связано», граф стоит проверить пилотом на части корпуса. Если они ищут конкретные пункты и цифры, начните с векторного или гибридного поиска и вернитесь к графу, когда появятся обзорные вопросы.