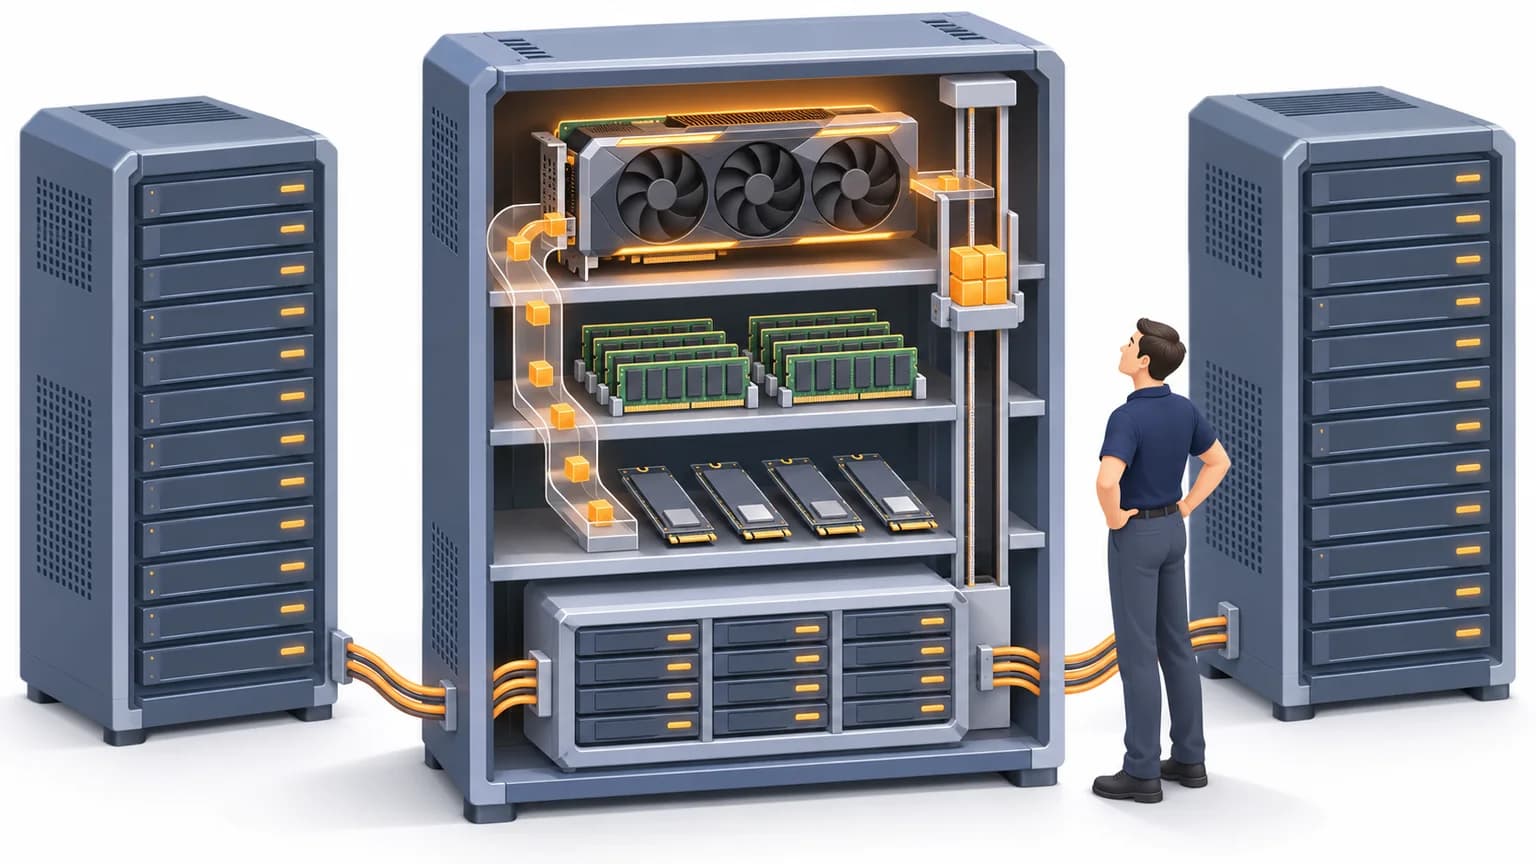
Выгрузка KV-кэша переносит состояния уже обработанных токенов из видеопамяти в оперативную память, на локальный NVMe или в общее хранилище, чтобы при повторе того же контекста не пересчитывать prefill заново. Она помогает в многоходовых диалогах, агентах и RAG с повторяющимися документами. Для потока уникальных коротких запросов выгода близка к нулю, а память и шина PCIe расходуются.
Материал подготовила AI студия Владимира Ломтева 16 ноября 2026 года для инженеров, которые эксплуатируют vLLM, SGLang или NVIDIA Dynamo на своих серверах. Мы сверили флаги с документацией vLLM, LMCache, SGLang и Dynamo и с заметками к выпуску llama.cpp v1.0.0. Собственных замеров на GPU не проводили. Цифры ускорения ниже принадлежат авторам указанных источников, а расчёты памяти — условные примеры.
Содержание
- Почему KV-кэш не помещается в видеопамять
- Иерархия памяти: от GPU до общего хранилища
- Когда выгрузка помогает, а когда нет
- Встроенная выгрузка в vLLM
- LMCache: отдельный слой управления кэшем
- SGLang HiCache: три уровня в одном движке
- Dynamo KVBM: выгрузка в кластере NVIDIA Dynamo
- Кэш экспертов MoE в llama.cpp 1.0 — это не KV-кэш
- Как выбрать инструмент
- Как проверить эффект на своей нагрузке
- Безопасность и изоляция
- Частые вопросы
Почему KV-кэш не помещается в видеопамять
Во время генерации модель хранит для каждого токена ключи и значения внимания — это и есть KV-cache. Его объём растёт с длиной контекста и числом одновременных диалогов. Для модели с GQA объём на один токен считается так:
2 × число слоёв × число KV-голов × размер головы × байт на значение
Условный пример для конфигурации, типичной для 8B-моделей: 32 слоя, 8 KV-голов, размер головы 128, хранение в FP16 (2 байта). Получаем 2 × 32 × 8 × 128 × 2 = 131 072 байта, то есть 128 КиБ на токен. Сессия с контекстом 32 768 токенов займёт 128 КиБ × 32 768 = 4 ГиБ. Сто таких сессий потребуют 400 ГиБ — больше, чем есть в любой одиночной видеокарте. Как к этому добавляются веса и служебная память, разобрано в статье «Сколько VRAM нужно для LLM».
Когда видеопамять заканчивается, движок вытесняет старые блоки. Если пользователь вернётся к диалогу через минуту, его история пройдёт prefill заново. На длинных контекстах это секунды задержки и занятый GPU. Выгрузка сохраняет вытесненные блоки ниже по иерархии памяти и возвращает их при повторном обращении.
Иерархия памяти: от GPU до общего хранилища
| Уровень | Где лежит кэш | Кто может его использовать | Типичная роль |
|---|---|---|---|
| L1 | Видеопамять GPU | Только этот экземпляр движка | Активные запросы и горячие префиксы |
| L2 | Оперативная память сервера | Только этот экземпляр | Недавно вытесненные диалоги и общие системные промпты |
| L3 локальный | NVMe или файловая система узла | Процессы на узле, если хранилище общее | Длинная история, редкие повторы |
| L3 общий | Mooncake, 3FS, Redis, S3 и другие | Несколько серверов | Повторное использование между репликами |
Чем ниже уровень, тем больше объём и тем дороже обращение. Загрузка блока из оперативной памяти идёт через PCIe, с NVMe — ещё и через файловую систему. Выгрузка выгодна, пока загрузка готового кэша быстрее, чем повторный prefill того же текста. Для длинных повторяющихся контекстов это обычно так, для коротких — не всегда.
Когда выгрузка помогает, а когда нет
Выгрузка оправдана, если:
- пользователи возвращаются к длинным диалогам после паузы, за которую кэш успевает вытесниться из GPU;
- агенты много раз вызывают модель с растущей историей шагов и инструментов;
- много запросов начинается с одного длинного системного промпта или одних и тех же документов RAG;
- движок часто вытесняет запросы под нагрузкой, и пересчёт съедает заметную часть GPU.
Выгрузка почти не поможет, если:
- запросы уникальные и короткие, повторного использования нет;
- оперативной памяти на сервере мало, и кэш будет вытесняться из L2 раньше, чем понадобится;
- узкое место — генерация длинных ответов (decode), а не prefill;
- приложение меняет начало промпта в каждом запросе, например вставляет текущее время в первую строку, и префиксы не совпадают.
Прежде чем включать выгрузку, проверьте по метрикам, что проблема действительно в повторном prefill. Как читать очередь и вытеснения, описано в статье об очереди запросов к LLM.
Встроенная выгрузка в vLLM
В vLLM есть собственный механизм выгрузки в оперативную память. По справочнику аргументов, --kv-offloading-size задаёт размер буфера выгрузки в ГиБ. По умолчанию значение не задано, и выгрузка выключена. --kv-offloading-backend выбирает реализацию: native (по умолчанию) или lmcache.
vllm serve Qwen/Qwen3-8B \
  --host 127.0.0.1 --port 8000 \
  --api-key "$VLLM_API_KEY" \
  --kv-offloading-backend native \
  --kv-offloading-size 64
Здесь 64 ГиБ оперативной памяти выделены под кэш одной реплики. Это условное значение: оставьте запас для системы, процессов загрузки модели и других сервисов на сервере.
Команда vLLM описала механизм в блоге от 8 января 2026 года. По их данным, функция появилась в версии 0.11.0 и заметно ускорилась в 0.12.0. На Llama-3.1-8B-Instruct и H100 загрузка кэша из оперативной памяти сократила время до первого токена одиночного запроса в 2–22 раза в зависимости от длины промпта. На промахах кэша влияние минимальное, потому что копирование с GPU в RAM идёт асинхронно. Это результат авторов на их железе, на другой модели и сервере эффект будет другим. Там же перечислены ограничения: CPU-бэкенд работает только с CUDA-совместимыми устройствами, гибридные модели пока не оптимизированы, а результат зависит от размера блока модели.
LMCache: отдельный слой управления кэшем
LMCache описывает себя как слой управления KV-кэшем для масштабируемого инференса. Он работает отдельно от движка и поддерживает оперативную память, локальный диск и удалённые хранилища: Redis/Valkey, Mooncake, InfiniStore, S3-совместимые хранилища, NIXL и GDS.
В кратком руководстве LMCache показан режим с отдельным процессом-сервером. Сначала запускают сервер кэша:
lmcache server \
  --host localhost --port 5555 \
  --l1-size-gb 20 --eviction-policy LRU --chunk-size 16
Затем vLLM подключают к нему через --kv-transfer-config:
vllm serve Qwen/Qwen3-8B --port 8000 \
  --kv-transfer-config '{"kv_connector":"LMCacheMPConnector","kv_role":"kv_both","kv_connector_extra_config":{"lmcache.mp.host":"localhost","lmcache.mp.port":5555}}'
В документации отмечено, что размер блока 16 взят для демонстрации, а значение по умолчанию — 256. LMCache стоит выбирать, когда кэш нужен нескольким экземплярам движка или нужен сетевой уровень. Для одной реплики с выгрузкой только в RAM проще встроенный механизм vLLM.
SGLang HiCache: три уровня в одном движке
В SGLang иерархический кэш называется HiCache. По руководству по настройке HiCache его включают флагом --enable-hierarchical-cache. Размер пула в оперативной памяти задают кратно пулу GPU через --hicache-ratio или в гигабайтах через --hicache-size, который переопределяет коэффициент. Третий уровень подключают через --hicache-storage-backend: в примерах встречаются file, fast_file, hf3fs, mooncake, nixl, aibrix и dynamic.
python3 -m sglang.launch_server \
  --model-path Qwen/Qwen3-8B --host 127.0.0.1 --port 30000 \
  --enable-hierarchical-cache \
  --hicache-ratio 2 \
  --hicache-write-policy write_through \
  --hicache-storage-backend fast_file
Из документации важно запомнить три правила:
- уровни L1 и L2 принадлежат одному экземпляру, общим может быть только L3; увеличение
--hicache-ratioрасширяет личный кэш экземпляра, а не общий; - попадания из хранилища сначала копируются в пул оперативной памяти, поэтому он должен быть больше пула GPU, иначе попадания отбрасываются и промпт пересчитывается;
- бэкенд
fileпо умолчанию пишет в локальный каталог/tmp/hicacheи служит минимальной эталонной реализацией; для локального NVMe рекомендованfast_file, для общего хранилища —hf3fsилиmooncakeс прямым вводом-выводом.
Dynamo KVBM: выгрузка в кластере NVIDIA Dynamo
В NVIDIA Dynamo за выгрузку отвечает KVBM. В руководстве KVBM он описан как компонент для выделения, управления и удалённого обмена блоками KV, который работает как слой памяти и кэш со сквозной записью для vLLM и TensorRT-LLM. Поддерживаются выгрузка только в RAM, в RAM и на диск, а также экспериментальный режим только на диск.
Размеры уровней задают переменными окружения DYN_KVBM_CPU_CACHE_GB и DYN_KVBM_DISK_CACHE_GB, а vLLM подключают через --kv-transfer-config с DynamoConnector и модулем kvbm.vllm_integration.connector. В документации есть прямое предупреждение: если кэш в оперативной памяти меньше кэша на устройстве, KVBM не даст выигрыша. Поэтому RAM-уровень должен быть не меньше KV-пула GPU, а дисковый — не меньше RAM-уровня.
Кэш экспертов MoE в llama.cpp 1.0 — это не KV-кэш
В выпуске llama.cpp v1.0.0 от 13 ноября 2026 года появился кэш экспертов MoE в оперативной памяти с настраиваемой долей CPU. В llama_context_params добавлены moe_cache_size и moe_cache_cpu_share, эксперты, не попавшие в кэш, выполняются на CPU, а для замещения используются политики LRFU и ClassLRU.
Название похоже, но механизм другой. Этот кэш держит в быстрой памяти часто используемых экспертов, то есть веса модели, а не состояния токенов. Он нужен, когда большая MoE-модель целиком не помещается в видеопамять. В том же выпуске появился KV-кэш в FP8 (-ctk/-ctv f8_e4m3) — это другой способ уменьшить именно KV-кэш, о нём мы пишем отдельно.
Как выбрать инструмент
| Ситуация | Что попробовать первым |
|---|---|
| Одна реплика vLLM, длинные диалоги, много свободной RAM | Встроенная выгрузка vLLM (native) |
| Несколько реплик vLLM должны делить кэш | LMCache с общим бэкендом |
| Сервис на SGLang | HiCache: сначала L2, затем fast_file на NVMe |
| Кластер на NVIDIA Dynamo | KVBM с правилом размеров RAM ≥ GPU, диск ≥ RAM |
| Большая MoE-модель не помещается в VRAM на llama.cpp | Кэш экспертов MoE, а не выгрузка KV |
Не включайте одновременно несколько механизмов выгрузки на одном движке, если документация прямо не описывает такую связку. Каждый управляет блоками по-своему, и результат будет трудно объяснить.
Как проверить эффект на своей нагрузке
- Запишите базовую линию. Без выгрузки измерьте p50 и p95 времени до первого токена, долю занятого KV-кэша и число вытеснений на реальной смеси запросов.
- Подготовьте сценарий повторов. Для многоходового чата отправьте первый ход, дождитесь вытеснения из GPU, затем второй ход с той же историей. Для RAG используйте повторяющийся набор документов.
- Включите один механизм. Сравните время до первого токена на повторных обращениях и на новых запросах отдельно.
- Следите за ресурсами. Использование RAM, ввод-вывод NVMe и загрузку PCIe. Если оперативная память в пике заканчивается, система начнёт свопить, и выгода исчезнет.
- Проверьте качество. Ответы с кэшем и без него для одного и того же запроса при нулевой температуре должны совпадать или различаться только в пределах обычного шума движка.
- Зафиксируйте решение. Оставьте выгрузку, если повторные обращения ускорились, а новые запросы не стали медленнее.
Безопасность и изоляция
KV-кэш содержит производное представление пользовательского текста. Если вы выгружаете его на диск или в общее хранилище, к нему применимы те же правила, что и к самим данным:
- общий уровень между арендаторами должен учитывать изоляцию: запрос одного пользователя не должен получать блоки другого;
- каталог на NVMe с кэшем стоит шифровать и очищать при выводе сервера из эксплуатации;
- доступ к сетевому хранилищу кэша должен быть ограничен серверами инференса.
Работа с кэшем в распределённых конфигурациях требует обновлений движка. В разборе LMSYS от 26 октября 2026 года описаны исправленные в SGLang ошибки, при которых при раздельных prefill и decode чужой KV-кэш мог попасть в ответ другого пользователя; отдельный вариант был связан с выгрузкой HiCache на стороне decode. Держите движок на актуальной версии и читайте заметки к выпускам.
Частые вопросы
Ускорит ли выгрузка генерацию длинного ответа? Нет. Она экономит повторный prefill. Скорость генерации каждого следующего токена от неё не зависит.
Сколько оперативной памяти выделять? Не меньше, чем KV-пул на GPU, иначе по правилам Dynamo и SGLang выигрыша не будет. Дальше размер подбирают по тому, сколько диалогов и как надолго нужно удерживать.
Можно ли выгружать KV-кэш на обычный SSD? Можно, но выигрыш зависит от скорости диска. Для частых обращений лучше локальный NVMe, а SATA-диск может оказаться медленнее повторного prefill.
Нужен ли prefix caching для выгрузки? Выгрузка повторно использует блоки по совпадающим префиксам, поэтому оставляйте кэширование префиксов включённым, если документация вашей версии движка не говорит иного.
Как AI студия Владимира Ломтева помогает с выгрузкой KV-кэша
AI студия Владимира Ломтева разворачивает LLM на серверах компании и сопровождает их. Для выгрузки кэша это означает:
- проверить по метрикам, что задержка вызвана повторным prefill, а не очередью или генерацией;
- подобрать механизм выгрузки и размеры уровней под движок, память и диски сервера;
- провести сравнительное тестирование на реальных диалогах и документах до и после включения;
- настроить мониторинг памяти и правила хранения кэша вместе с требованиями к данным.
Первый шаг — выбрать один сценарий с длинным повторяющимся контекстом, записать текущее время до первого токена и цель, которой нужно достичь. Обсудить задачу.
Итог: выгрузка экономит повторный prefill
Выгрузка KV-кэша в RAM и на NVMe полезна, когда один и тот же длинный контекст возвращается после вытеснения из видеопамяти. Начните со встроенной выгрузки в оперативную память своего движка, измерьте эффект на повторных обращениях и только потом добавляйте диск или общее хранилище для нескольких реплик.