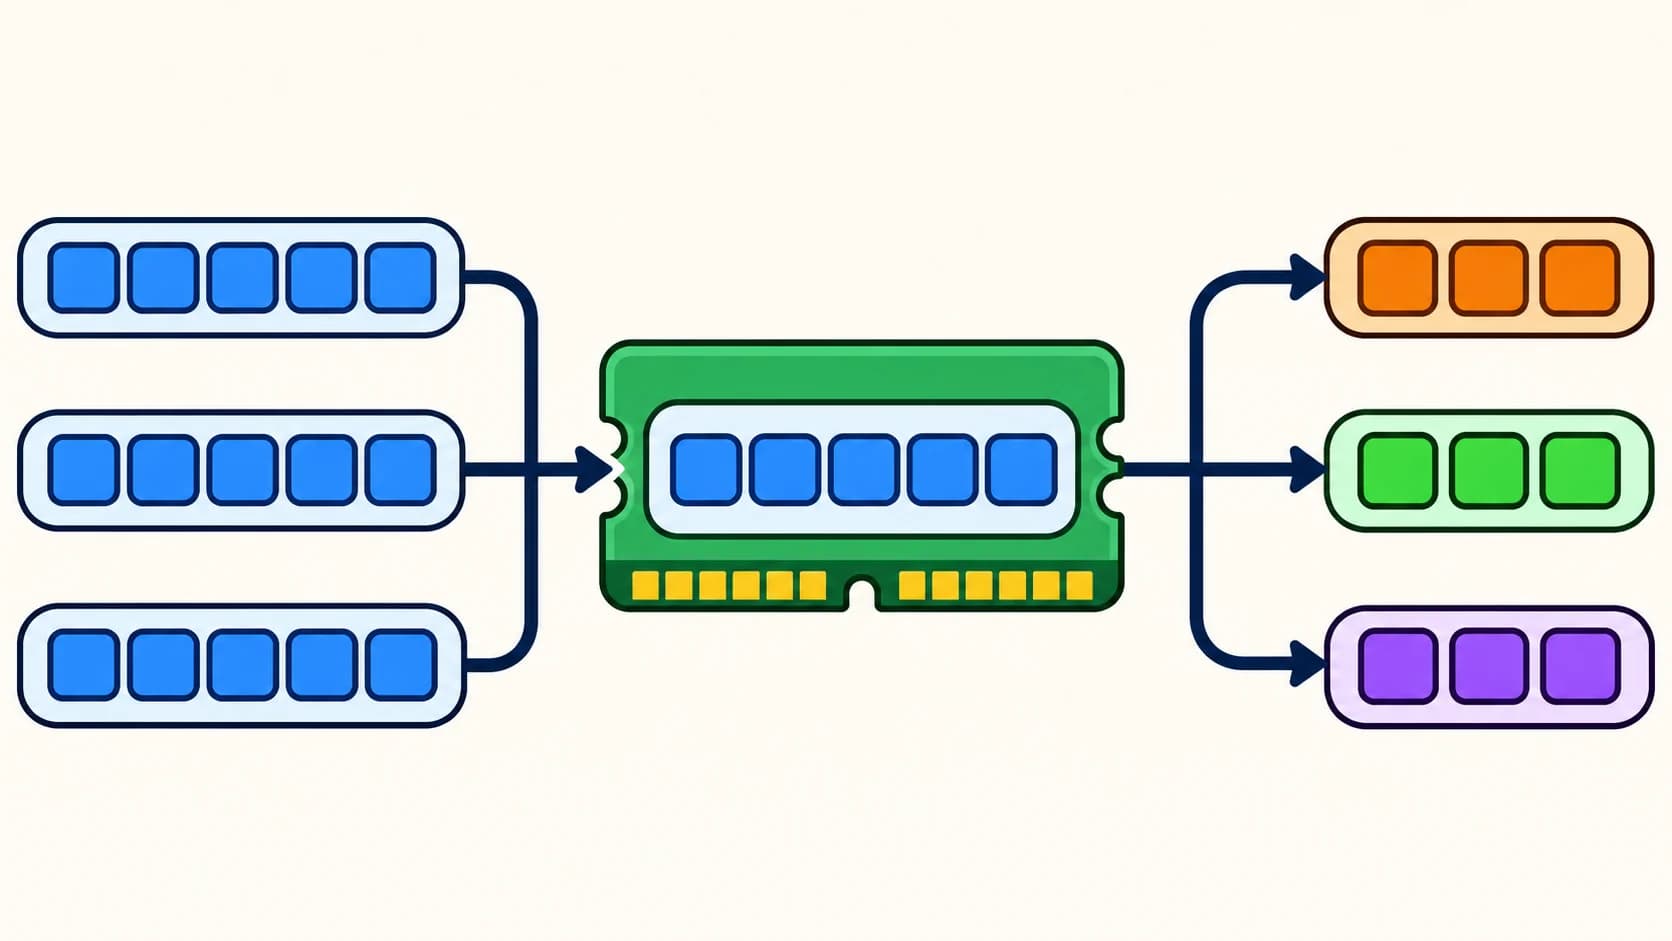
KV-cache сохраняет состояния уже обработанных токенов внутри генерации, а prefix caching позволяет повторно использовать подходящие состояния общего начала разных запросов. Это связанные, но разные механизмы. Они помогают уменьшать повторную работу, однако занимают память и не обещают одинакового ускорения любого ответа.
Материал подготовила AI студия Владимира Ломтева 14 ноября 2026 года для разработчиков RAG, чат-ботов и локальных LLM-сервисов. Это объяснение и протокол проверки по документации движков, без собственного бенчмарка и гарантированных процентов ускорения. Конкретные флаги, метрики и правила изоляции зависят от версии сервера. Кэширование готовых бизнес-ответов рассмотрено только для разграничения понятий.
Содержание
- Что хранит KV-cache
- Чем prefix caching отличается от обычного кэша
- Почему важны токены и порядок
- Какие сценарии подходят
- Когда кэш почти не решает проблему
- Как оценить память кэша
- Как проверить prefix caching на своём сервере
- Как считать эффект
- Как менять приложение ради повторяемости
- Изоляция пользователей и безопасность
- Шаблон протокола кэширования
- Частые вопросы
Что хранит KV-cache
В attention-модели для обработанных позиций формируются ключи и значения — K и V. Сохранение этих состояний позволяет использовать уже вычисленное при продолжении последовательности. Это отличается от хранения исходного текста или финального ответа в обычной базе данных.
Во время генерации новая позиция добавляет состояние. Поэтому длинный диалог требует больше памяти, чем короткий, при прочих равных. Одновременно активные запросы создают суммарную потребность, зависящую от архитектуры и стратегии runtime.
KV-cache не является универсальным механизмом долговременной памяти агента. После перезапуска или вытеснения состояние может отсутствовать, а приложение всё равно должно корректно сформировать запрос. Для бизнес-памяти нужны самостоятельные правила хранения данных и прав доступа.
Чем prefix caching отличается от обычного кэша
| Механизм | Что переиспользуется | Что продолжает вычисляться |
|---|---|---|
| KV-cache последовательности | Состояния уже обработанного контекста | Продолжение текущей генерации |
| Prefix caching | Подходящие состояния совпадающего начала запросов | Новый хвост и генерация ответа |
| Кэш готового ответа | Ранее сохранённый результат приложения | Зависит от схемы, иногда генерация пропускается |
| История диалога | Сообщения и данные приложения | Модель обрабатывает предоставленный контекст |
Смешение этих понятий приводит к неверным ожиданиям. Наличие prefix cache не означает, что сервер возвращает прошлый ответ. Сохранение истории не доказывает попадание в вычислительный кэш. А кэш готовых ответов требует проверки актуальности источников и разрешения повторного использования результата.
Механизм повторного использования общего входа описан в Automatic Prefix Caching vLLM. В SGLang используется собственная система организации кэша; параметры и ограничения нужно сверять с руководством по настройке SGLang.
Почему важны токены и порядок
Для вычислительного совпадения недостаточно похожего смысла. Существенна фактическая последовательность, которую получает модель после токенизации и применения шаблона диалога. Два визуально похожих промпта могут различаться пробелами, порядком полей или служебными токенами.
Если стабильную системную инструкцию предварять уникальным идентификатором, общее начало становится короче. Если история диалога полностью пересобирается с другим шаблоном, совпадение тоже может измениться. Поэтому при диагностике сохраняют итоговый формат входа, не раскрывая при этом секретные данные в общедоступном журнале.
Порядок данных выбирают прежде всего по смыслу. Не переносите пользовательскую инструкцию в позицию, где она получает другие полномочия, только ради кэша. Оптимизация не должна менять доверительную границу между системными правилами, документом и пользовательским текстом.
Какие сценарии подходят
Повторные вопросы по одному большому документу — естественный кандидат. Общая часть может быть значительной, а пользовательский вопрос меняется. Другой пример — устойчивые инструкции и определения инструментов для однотипного процесса.
В RAG повторяемость зависит от найденных фрагментов и их порядка. Если каждый запрос выбирает совершенно другой набор, выигрыш общего префикса может быть небольшим. Это не означает неисправности кэша: просто поток имеет другой профиль.
Для массовой разметки полезно проверить, насколько стабильна общая инструкция перед различающимися записями. Но если промпт короткий, накладные расходы и генерация могут занимать большую долю полного времени. Наличие повторяемости ещё не определяет экономический эффект.
Когда кэш почти не решает проблему
Если большую часть времени занимает длинная генерация, переиспользование входа может мало изменить полный ответ. Если задержка находится в OCR или внешнем инструменте, кэш модели не ускорит этот компонент. Поэтому сначала разделите пользовательское время на этапы.
При перегрузке очередь может оставаться основной причиной ожидания даже с высоким числом попаданий. При нехватке памяти сохранённые блоки могут вытесняться. Запрос, который пришёл после изменения модели или конфигурации, также нельзя считать эквивалентным прежнему только по тексту.
В распределённом сервисе важна маршрутизация к экземпляру, у которого есть нужное состояние. Балансировщик и политика размещения могут влиять на фактическую повторяемость. Это отдельный уровень архитектуры; сложность стоит добавлять после подтверждённого эффекта на одном экземпляре.
Как оценить память кэша
Для обычного attention число слоёв, KV-голов, размер головы, число токенов и байт на элемент определяют грубую оценку. Но для гибридных и сжатых архитектур формулу необходимо уточнять. Не переносите оценку одной модели на другую только по близкому количеству параметров.
Кэширование общего префикса и обслуживание активных последовательностей конкурируют за ограниченный ресурс согласно политике движка. Следите за доступным пулом, вытеснением и состоянием очереди. Если ради сохранения редко используемого префикса ухудшилась интерактивная нагрузка, конфигурацию нужно пересмотреть.
Квантование KV-cache — отдельный способ уменьшения состояния. Оно отличается от квантования весов и требует собственной проверки совместимости и качества. Документация vLLM Quantized KV Cache описывает поддерживаемые пути. Общие принципы сжатия разобраны в статье о квантизации LLM.
Как проверить prefix caching на своём сервере
Сначала зафиксируйте модель, токенизатор, шаблон, версию runtime и настройки кэша. Подготовьте разрешённый текст с длинной устойчивой частью и несколькими разными вопросами. Не используйте внутренний документ, если тестовая трассировка может отправить его наружу.
Проведите четыре сценария:
- Первый запрос с общей частью после согласованного сброса состояния.
- Повторный запрос с тем же началом и другим вопросом.
- Запрос, в котором изменён ранний элемент общей части.
- Поток с другой работой между повторами, чтобы увидеть влияние вытеснения.
Для каждого сохраните TTFT, полную задержку, длины входа и выхода, память и доступные метрики кэша. Ограничения генерации должны быть сопоставимы. Если ответы разной длины, не приписывайте всё различие полного времени механизму кэша.
На стороне vLLM определения метрик проверяйте по Production Metrics и фактическому /metrics. Названия и набор показателей меняются, поэтому лучше начать с наблюдаемого экспорта своей версии.
Как считать эффект
Для одного и того же показателя можно вычислить относительное изменение:
Сокращение времени = (время базы − время варианта) / время базыБазовое время должно быть положительным, а сравниваемые условия — описанными. Условный пример: 4 секунды до первого токена и 3 секунды в повторном сценарии дают сокращение на 25%. Это арифметический пример с вымышленными данными, а не измеренный результат vLLM или SGLang.
Одного повтора недостаточно для оценки устойчивости. Сохраните несколько запусков и объясните разброс. Для отчёта используйте реальные наблюдения, не выбирая только лучший результат. Сводный hit rate тоже нуждается в определении: он может относиться к запросам, блокам или токенам, и это разные знаменатели.
Как менять приложение ради повторяемости
Сначала устраните случайные изменения, которые не несут полезного смысла: уникальные служебные поля перед общим контекстом, нестабильный порядок одинаковых описаний, различающееся форматирование. Для каждого изменения проверьте, что итоговая задача и полномочия сообщений сохраняются.
Не удаляйте дату, если она влияет на корректность ответа. Не объединяйте контексты разных пользователей ради hit rate. Не сохраняйте результаты после изменения прав на документы только потому, что технический ключ совпадает.
Для готовых ответов нужен отдельный ключ актуальности: версия источника, модель, политика доступа и условия запроса. Это особенно важно при обновлении базы знаний. Правила выпуска документов разобраны в чек-листе обновления RAG в Qdrant.
Изоляция пользователей и безопасность
Кэш должен работать внутри разрешённой границы доверия. Проверьте, какие механизмы изоляции поддерживает закреплённая версия, как определяются арендаторы и какие данные доступны оператору. Не считайте любой общий сервер безопасным только потому, что модель локальная.
Не используйте наличие совпадения как разрешение на доступ к документу. Права проверяются приложением до передачи данных модели и при выдаче ответа. Разделение вычислений не заменяет авторизацию.
Не записывайте полные промпты в метки метрик. Это создаёт риск раскрытия и высокую кардинальность. Для диагностики лучше использовать ограниченные технические признаки, идентификаторы разрешённого теста и защищённый журнал с контролируемым сроком хранения.
Шаблон протокола кэширования
Модель, revision и шаблон диалога:
Движок, версия, параметры кэша:
Общая часть и правило изменения хвоста:
Процедура холодного состояния:
Длина входа и фактического выхода:
TTFT, полное время, память:
Метрика попаданий и её знаменатель:
Поведение под смешанной нагрузкой:
Проверка качества и изоляции:
Решение:
Этот шаблон помогает не смешивать ускорение первого токена с сокращением всей бизнес-операции. Если эффект отсутствует, сохранённый протокол всё равно полезен: он исключает неподходящую оптимизацию и направляет поиск к реальному узкому месту.
Механизмы, которые стоят за настройками сервера, разобраны в гиде по движкам и ускорению инференса. До выбора оборудования полезно пройти сравнение собственного инференса и API.
Частые вопросы
Кэш гарантирует одинаковый ответ?
Нет. Повторное использование состояний входа не является сохранением готового результата. Ответ зависит от продолжения и параметров генерации.
Prefix caching ускоряет длинный выход?
Он прежде всего относится к повторной обработке подходящего входа. Если доминирует генерация, общий эффект может быть небольшим.
Почему повторный запрос не быстрее?
Проверьте фактическое совпадение токенов, наличие состояния, вытеснение, маршрутизацию и долю времени других этапов. Короткий вход может давать слишком небольшой эффект для выбранного измерения.
Можно ли включить кэш и забыть о нём?
Нужно наблюдать память, нагрузку и качество после изменений. При обновлении модели, шаблона или структуры промпта прежний результат не следует считать автоматически действующим.
Как AI студия Владимира Ломтева помогает ускорить рабочий сценарий
AI студия Владимира Ломтева может связать аудит процесса с подготовкой данных, тестированием и развёртыванием LLM. Для повторяющегося контекста это означает определить реальный источник задержки, проверить подходящий вариант исполнения и интегрировать его с правилами доступа к данным.
Первый шаг — выбрать один процесс, записать текущую задержку и критерий корректного результата. Обсудить задачу.
Когда кэширование стоит применять
Используйте prefix caching как проверяемую оптимизацию для потока с устойчивым общим входом. Оценивайте время до первого токена, общую задержку, память и качество вместе. Если основная проблема находится в другом этапе, продолжайте диагностику, сохраняя воспроизводимые условия сравнения.