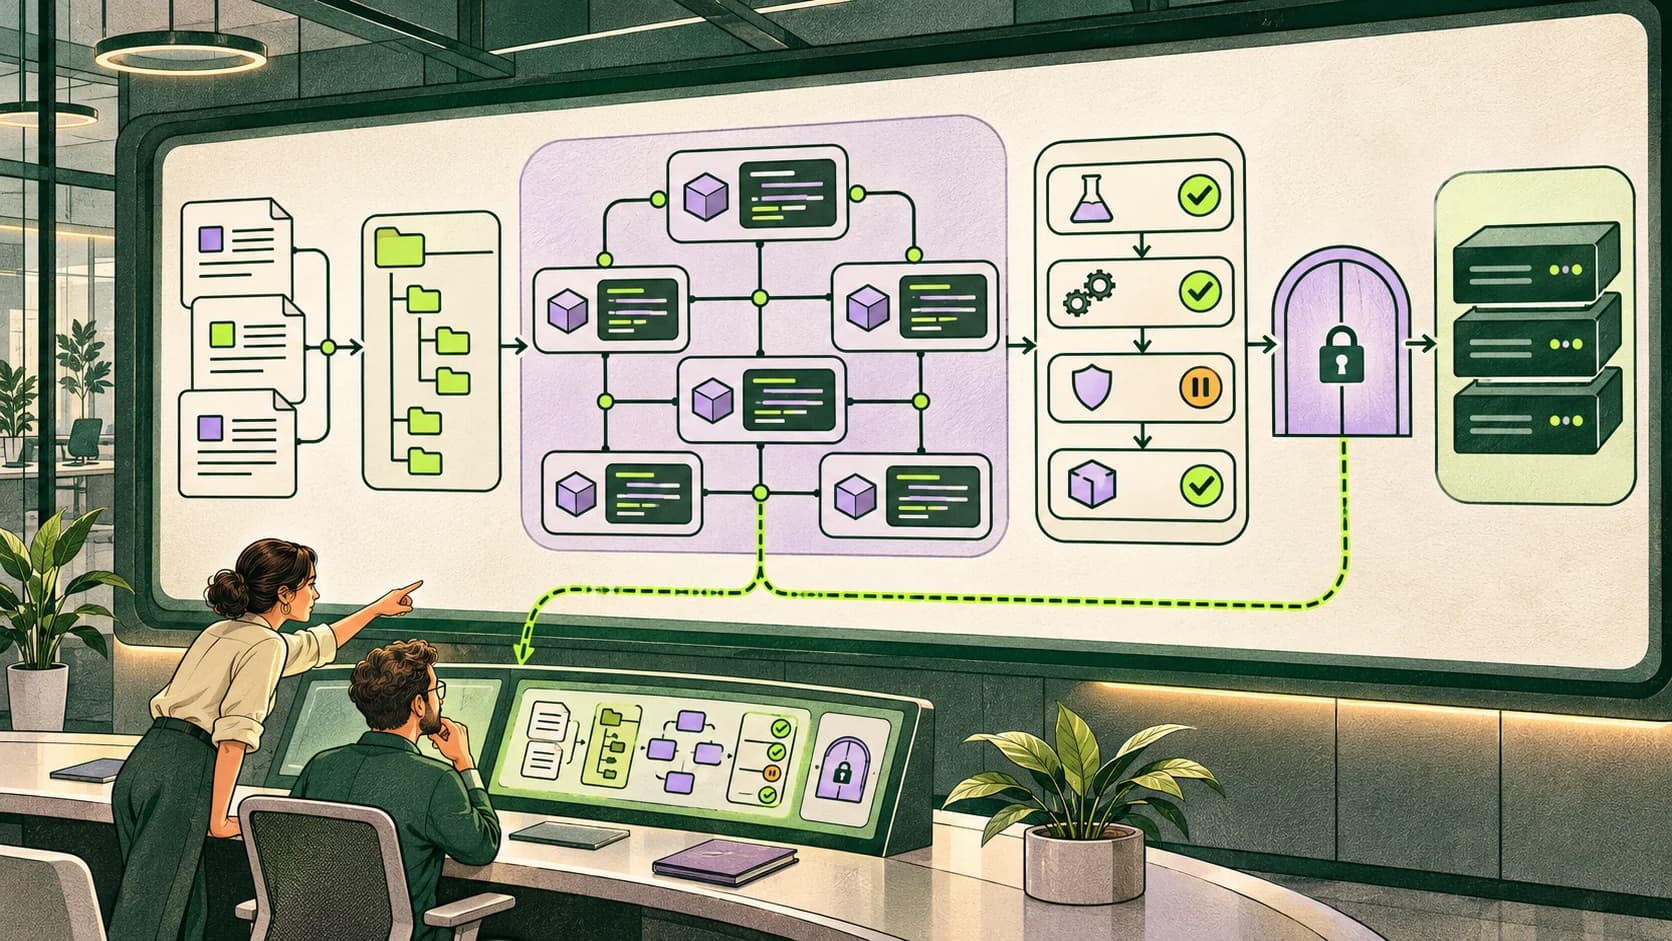
Dark Factory в разработке ПО — это организация работы, при которой ИИ-агенты получают задачу, исследуют систему, вносят изменения, проверяют результат и проходят предусмотренный путь поставки. Для существующего Enterprise-проекта приблизиться к этому режиму можно через подготовку контекста, машиночитаемые правила, независимую проверку и доступную агентам инфраструктуру. Покупка более сильной модели сама по себе эти условия не создаёт.
Материал подготовила AI студия Владимира Ломтева 12 ноября 2026 года по предоставленному транскрипту доклада «Конвертируем Enterprise-проект в Dark Factory» Родиона Мостового и Максима Ключникова, обсуждению после выступления и актуальным первоисточникам. Это самостоятельное практическое руководство для CTO, руководителей разработки, архитекторов, платформенных команд и владельцев корпоративных систем.
Мы разбираем переход существующего продукта к более автономной разработке. Описанные ниже схемы и сквозной пример — предлагаемые способы организации работы, а не выполненное редакцией внедрение. Собственных замеров производительности, стоимости или доли успешно решённых задач у нас нет. Где речь идёт об опыте и рекомендациях спикеров, это отмечено отдельно; доступ к критичному production не считается автоматическим следствием успеха на тестовом стенде.
Содержание
- Что такое Dark Factory и где проходит граница автономности
- Почему существующий Enterprise сложнее нового приложения
- Почему рейтинг модели не заменяет готовность проекта
- Архитектура агентной разработки: какие слои должны работать вместе
- Начните с продуктового контекста, а не с описания классов
- AGENTS.md и progressive disclosure: как дать карту большой кодовой базы
- Тезаурус проекта: почему словаря терминов недостаточно
- Неявные знания: что извлекать из Git, задач, обсуждений и встреч
- Как не превратить сгенерированную документацию во второй источник ошибок
- Missing change: как найти место, которое агент забыл изменить
- Граф вызовов, семантический поиск и эволюционные связи решают разные задачи
- Постановка задачи: намерение, ограничения и наблюдаемый результат
- Контур верификации: от статических правил до сквозного поведения
- AI QA и визуальные тесты: сценарий нужен до обхода интерфейса
- Тяжёлые проверки: зачем агенту CI и выделенные окружения
- Инфраструктурный фундамент: IaC, среды, резервирование и доставка
- Где нужен LLM, а где лучше детерминированный инструмент
- Как выглядит интерфейс, которым агент действительно может пользоваться
- Права агентов: разработчик, наблюдатель, оператор и поставка
- Наблюдаемость: как агенту найти причину до изменения кода
- Трассы приложения и история действий агента — разные данные
- Workflow для багфикса, новой функции и рефакторинга
- Собственный eval: оценивайте решённую задачу, а не совпадение патча
- Судьи на LLM, повторяемость и показатели качества
- Как ограничить циклы исправления и не получить бесконечный ремонт
- Технический долг: правила должны исполняться во время изменения
- ADR и история решений: зачем сохранять причину «странного» кода
- Legacy: когда нужна миграция, а когда лучше улучшить работу с текущей системой
- Как распространять скиллы в команде и не заморозить плохую практику
- Дорожная карта перехода: какие результаты получать по этапам
- Сквозной пример: изменение доступного остатка в существующем продукте
- Как понять, что проект ещё не готов к большей автономности
- Частые вопросы о Dark Factory в Enterprise
- Источники и границы этого руководства
Что такое Dark Factory и где проходит граница автономности
В докладе Dark Factory описывается как система, которая превращает исходный запрос в программный результат. Но между этими точками находится не одно действие «написать код», а весь производственный процесс: понять намерение, найти затронутые части системы, изменить реализацию, проверить поведение, подготовить поставку и получить обратную связь.
Термин не задаёт единственного обязательного продукта или общепринятого уровня зрелости. В одной команде автономность заканчивается готовым pull request, в другой — развертыванием в stage, в третьей допускается автоматическая поставка определённого класса изменений. Поэтому полезнее спрашивать не «есть ли у нас Dark Factory», а какие действия, в каком окружении и при каких ограничениях агент выполняет без человека.
Один из публично описанных подходов — Software Factory StrongDM. В его принципах выделены исходный замысел, проверочный контур и обратная связь, в том числе отдельные проверочные сценарии. Это описание конкретного подхода поставщика, а не доказательство готовности любого Enterprise к полностью автоматическому выпуску. Принципы StrongDM Software Factory.
Для практического разговора разделите несколько состояний:
| Состояние | Что делает агент | Где остаётся решение человека |
|---|---|---|
| Ассистирование | Объясняет код, ищет участки, предлагает исправление | Человек определяет и выполняет изменение |
| Подготовка изменения | Меняет код и запускает доступные проверки | Человек проверяет и принимает результат |
| Автономная работа в ограниченной среде | Доводит задачу до проверенного состояния в выделенном контуре | Человек задаёт границы и разрешает переход дальше |
| Автоматизированная поставка выбранных изменений | Проходит контролируемый pipeline по установленным правилам | Владелец процесса определяет допустимый класс операций и исключения |
Это рабочее разделение для планирования, а не сертификационная шкала. У одной системы разные подсистемы могут находиться в разных состояниях.
Почему существующий Enterprise сложнее нового приложения
Новый небольшой сервис можно спроектировать вокруг удобного для агента стека. В существующей корпоративной системе уже есть история: старые контракты, обходные решения, владельцы данных, особые права, несовпадающие термины и процессы, которые выходят за пределы одного репозитория.
Технически правильная функция может оказаться неправильным изменением продукта. Например, разработчик поменял способ расчёта доступного остатка, но не учёл резерв, карантин товара или ночной обмен с учётной системой. Компилятор доволен, локальные тесты проходят, а клиент видит обещание отгрузки того, что нельзя отгрузить.
В докладе эта сложность рассматривается через онбординг агента и подготовку инфраструктуры. Агенту нужно дать не только файлы, но и правила игры: что означают бизнес-понятия, какие ограничения нельзя нарушать, как проверить изменение и где получить достоверный сигнал о работе системы.
Поэтому начинать следует с конкретного процесса, а не с цели «автоматизировать весь монолит». Хороший стартовый объект — ограниченная операция с понятными владельцем, входом, результатом и способом проверки. Число строк кода само по себе не определяет ни риск, ни готовность к автономности.
Почему рейтинг модели не заменяет готовность проекта
Модель и окружение работают вместе. Под harness обычно понимают окружающую модель систему: доступные инструменты, способы чтения и изменения файлов, управление контекстом, исполнение команд, ограничения и обратную связь. Сравнение моделей без учёта этого слоя плохо объясняет, как поведёт себя агент в вашей компании.
Спикеры обсуждают Real-SWE как иллюстрацию сложности реальных корпоративных задач. Здесь важно не переносить проценты со слайда в универсальную вероятность успеха. На дату проверки первоисточник уже описывает Real-SWE 1.1: 25 задач и 18 моделей, а также прямо говорит об оценке сочетаний моделей и их штатных harness, а не моделей в изоляции. Это заявленные параметры конкретного набора. Первоисточник Specific Labs.
Такой результат нельзя преобразовать в утверждение «наша фабрика успешно выполнит такую же долю любых задач». Отличаться будут код, инструкции, зависимости, критерии оценки и доступная инфраструктура. Даже улучшение поиска нужных файлов ещё не означает улучшения всего пути до принятого изменения.
Практический вывод — сравнивать рабочие конфигурации на своих задачах. Более сильная модель может помочь, но плохой интерфейс логов, недоступный стенд или непонятное определение бизнес-термина остаются отдельными причинами ошибок.
Архитектура агентной разработки: какие слои должны работать вместе
Удобно разделить систему на несколько слоёв и для каждого назвать артефакт, который агент действительно может использовать. Следующая схема — редакционная организация идей доклада для практического применения.
| Слой | Что требуется подготовить | Какой вопрос это снимает |
|---|---|---|
| Продукт | Назначение, пользователи, нагрузка, ограничения | Зачем делается изменение? |
| Знания | Термины, инварианты, решения и источники | Что здесь считается правильным? |
| Навигация | Карта репозитория, инструкции, индекс документации | Где искать нужный контекст? |
| Проверка | Статические правила, тесты, сценарии и критерии | Как отличить работающий результат от правдоподобного? |
| Платформа | Воспроизводимые среды, доставка, данные, восстановление | Где и как проверить систему целиком? |
| Инструменты | Управляемые операции чтения и изменения | Какие действия доступны агенту? |
| Управление | Права, наблюдаемость, оценки и порядок эскалации | Что можно поручить автономно и когда остановиться? |
Слои связаны. Если нет определения доступного остатка, тест может закрепить неправильную формулу. Если тест верен, но прогоняется не в той конфигурации, он не подтверждает готовность поставки. Если агент может изменить и реализацию, и все критерии успеха без контроля, зелёный отчёт теряет убедительность.
Именно эти связи отличают фабрику разработки от набора удобных промптов. Общий цикл от брифа до поставки разобран в материале об агентной разработке полного цикла; здесь основной фокус — подготовка большой существующей системы к такому циклу.
Начните с продуктового контекста, а не с описания классов
Мостовой отдельно возвращается к тому, что агенту нужно объяснить продукт. Без этого модель способна предлагать технически изощрённые решения для несуществующей нагрузки или, наоборот, не замечать ограничение, критичное для пользователей.
Подготовьте краткое описание системы: кто ей пользуется, какая операция приносит ценность, какие ошибки недопустимы и какие характеристики реально важны. Для внутреннего инструмента небольшой команды и публичного сервиса с пиковыми нагрузками инженерные компромиссы будут различаться.
Вместо задачи «отрефакторить обработку остатков» полезнее задать намерение: «При оформлении заказа клиент должен видеть количество, доступное для отгрузки с выбранного склада. Товар в резерве и карантине не должен увеличивать это количество. Существующий обмен с учётной системой необходимо сохранить».
Это ещё не готовая спецификация, но уже информация, по которой можно задавать правильные уточняющие вопросы. Агент понимает потребителя результата и ограничения. Конкретные правила резерва, времени обновления и конкурентных операций нужно получить из системы и подтвердить у владельца процесса, а не достроить по общим знаниям модели.
Результат этапа — короткое продуктовое описание, на которое можно сослаться из задачи и документации. Оно должно помогать выбирать решение, а не повторять маркетинговое описание компании.
AGENTS.md и progressive disclosure: как дать карту большой кодовой базы
В докладе предлагается использовать инструкции как навигационные указатели: верхний уровень объясняет устройство проекта, локальные файлы уточняют правила подсистем. Такой подход помогает не загружать в контекст все инструкции монорепозитория сразу.
Progressive disclosure — постепенное раскрытие информации по необходимости. Сначала агент читает карту и индекс, затем открывает документы и исходники, относящиеся к задаче. В большой системе это полезнее единого гигантского файла, где правила платёжного модуля перемешаны с инструкциями для мобильного интерфейса.
AGENTS.md — распространённый формат инструкций для coding agents. При этом область действия, порядок обнаружения и поддержка вложенных файлов зависят от инструмента. Сверяйтесь с описанием AGENTS.md и документацией выбранного агента. Для Claude Code отдельные правила загрузки и импорта описаны в документации управления памятью и инструкциями. Не стоит считать, что все агенты одинаково обрабатывают любой файл Markdown.
Предлагаемая структура документации для учебного репозитория:
AGENTS.md
docs/index.md
docs/product.md
docs/domain/stock.md
docs/architecture/decisions.md
docs/workflows/bug-fix.md
services/catalog/AGENTS.md
services/inventory/AGENTS.md
В корневом файле достаточно маршрутов: как собрать проект, где находятся правила предметной области, какие проверки обязательны и куда идти за локальными ограничениями. В файле подсистемы — её назначение, границы, особенности тестирования и ссылки на нужные документы.
Не переносите в инструкции каждую деталь реализации. Если информация достоверно извлекается из кода, важнее научить агента находить её. Отдельно сохраняйте то, что код объясняет плохо: причины решений, терминологию, запреты и неочевидные зависимости.
Признак готовности — агент на типовом вопросе находит нужную подсистему и обязательные правила без последовательного чтения всего репозитория. Это предлагаемый критерий проверки навигации, а не заявленный результат нашего теста.
Тезаурус проекта: почему словаря терминов недостаточно
Один из самых практичных тезисов Мостового — необходимость работать с языком системы. Простого списка «термин — определение» может не хватить. Нужно показывать синонимы, близкие, но неравные понятия, область действия и связь бизнес-слова с техническими сущностями.
Допустим, в проекте встречаются stock, balance, available, reserved. Поиск по слову stock не сообщает, какой показатель должен увидеть покупатель. В одном контексте это физическое количество, в другом — доступное к продаже, в третьем — остаток по данным внешней системы.
В учебном примере тезаурус можно организовать так:
| Понятие | Смысл в выбранном процессе | С чем нельзя путать |
|---|---|---|
| Физический остаток | Учтённое количество товара на складе | Доступное к отгрузке количество |
| Резерв | Количество, удерживаемое по правилам подтверждённых операций | Любое намерение пользователя купить товар |
| Доступный остаток | Количество, которое процесс разрешает предложить к отгрузке | Просто значение поля с похожим именем |
| Карантин | Выделенная категория, недоступная для обычной отгрузки по принятому правилу | Резерв конкретного заказа |
Это вымышленные определения для иллюстрации. В вашей системе резерв может иметь несколько состояний, а доступность — зависеть от канала продаж, склада и времени. Готовую таблицу нельзя назначить истиной проекта без проверки.
В опубликованных материалах CodeAlive-AI есть навык ubiquitous-language, посвящённый согласованности доменного языка, тезаурусу и анализу неоднозначностей. Это подтверждает наличие описанного инструмента, но не означает, что его установка автоматически разрешит все противоречия предметной области. Описание ubiquitous-language.
Неявные знания: что извлекать из Git, задач, обсуждений и встреч
Tacit knowledge, или неявные знания, — то, что команда учитывает в работе, но не выразила в удобном проверяемом документе. Например: «эту запись нельзя удалять до завершения ночной выгрузки» или «странный флаг нужен для старого клиента, который ещё не мигрировал».
В докладе предлагается собирать такие знания из кода, истории изменений, задач, pull request, обсуждений и транскриптов встреч. Источники дополняют друг друга. Код показывает реализованное поведение, обсуждение — намерение, а история — причину появления обходного решения.
Полезная запись не ограничивается пересказом. Для неё нужны содержание правила, область действия, ссылка на источник и статус подтверждения. Отдельно отмечайте, когда правило действовало: историческое решение не обязательно остаётся верным после миграции.
Если Git говорит одно, документация — другое, а эксперт — третье, агент должен вынести расхождение на уточнение. Ему не следует молча выбирать наиболее правдоподобную версию и превращать её в новую норму. Конфликт источников — полезный результат исследования, а не повод скрыть неопределённость.
Результат этапа — набор проверяемых утверждений и вопросов к владельцам процессов. Доступ к рабочим чатам и встречам выдаётся в пределах установленного компанией режима данных; наличие подходящего коннектора само по себе не даёт права читать любые обсуждения.
Как не превратить сгенерированную документацию во второй источник ошибок
Важная оговорка спикеров: собранные агентом знания нужно проверить с людьми, которые понимают предметную область. Автоматический текст не становится авторитетным только потому, что он аккуратно оформлен и находится рядом с исходниками.
Разделяйте черновик, подтверждённое правило и устаревший материал. Для спорного утверждения сохраняйте основание и вопрос, который мешает подтвердить его. После обсуждения фиксируйте решение, а не только итоговую формулировку без истории происхождения.
Опасная ситуация — замкнутое самоцитирование: агент ошибся в описании, следующий агент прочитал описание как факт и начал под него менять систему. Против этого помогают ссылки на первичные артефакты, понятная ответственность за документ и явный статус проверки.
Обновление документации следует связать с изменениями продукта. Если поменялось определение резерва, затронуты не только классы, но и тезаурус, тестовые данные и пользовательские правила. Если документ лишь дублирует список методов, дешевле ссылаться на актуальный код, чем поддерживать отдельную копию списка.
Для перехода к агентной разработке важна не максимальная масса документов, а управляемая достоверность. Индекс должен помогать найти действующее правило и отличить его от гипотезы.
Missing change: как найти место, которое агент забыл изменить
Missing change — неполное изменение: основная часть задачи сделана, но связанный участок остался в старом состоянии. Причина может находиться рядом в репозитории или в другом сервисе: изменили контракт ответа, но забыли потребителя, обновили расчёт, но не пересмотрели кеширование.
В докладе предлагается отдельный исследовательский проход до реализации. Его задача — найти входы и выходы процесса, потребителей результата, фоновые операции, тесты и связанные данные. Исследование после написания кода полезно тоже, но оно уже начинается под влиянием выбранного решения и может пропустить альтернативный путь.
Для сложной задачи исследование можно разделить: одна рабочая ветка анализа изучает доменные правила, другая — потребителей API, третья — фоновые задания и обмены. Сведение результатов должно убрать повторы, проверить противоречия и показать, какие области остались неизвестными. Само количество субагентов ничего не гарантирует; стоимость и качество такой организации требуют оценки. Это подробно обсуждается в разборе команд ИИ-агентов.
Полезный результат исследования — карта влияния изменения. В ней должно быть видно не только «какие файлы редактировать», но и «какие взаимодействия проверить» и «какие предположения ещё не подтверждены». Тогда план реализации опирается на систему, а не только на первый найденный метод.
Граф вызовов, семантический поиск и эволюционные связи решают разные задачи
Граф вызовов показывает известные инструменту отношения между элементами кода. Семантический поиск помогает найти фрагменты по смыслу запроса. Эволюционная связанность, или change coupling, показывает, какие части исторически менялись совместно, даже если прямой вызов между ними неочевиден. Такой смысл change coupling описывает CodeScene.
История совместных изменений может подсказать пару «схема данных — миграция» или «контракт — адаптер старого клиента». Но это подсказка, а не доказательство обязательной связи. Массовое форматирование, перенос файлов и большой смешанный коммит способны создать шум. Историческую связь нужно подтвердить содержанием изменений.
Статические связи тоже неполны. Важные взаимодействия могут проходить через события, очереди, соглашения об именах, внешние API и конфигурацию. Поэтому один красивый граф не заменяет понимание бизнес-процесса.
Мостовой обсуждает пользу контекстных движков и собственные замеры исследования кодовой базы. Здесь нужно учитывать его связь с разработкой контекстного продукта: это авторская оценка и опыт заинтересованного участника, а не наш независимый сравнительный тест. В самом выступлении отдельно отмечено, что замеры поиска контекста не равны end-to-end оценке решённых задач.
Не превращайте приведённые в разговоре размеры репозиториев в правило «после такого числа строк обязательно нужен GraphRAG». Польза зависит от устройства кода, запросов, инструкций и качества базовой навигации. Сначала устраните очевидные пробелы, затем проверяйте добавленный инструмент на своей работе.
Постановка задачи: намерение, ограничения и наблюдаемый результат
Для агента недостаточно сообщения «исправь остатки» или «сделай как в соседнем модуле». Входная задача должна описывать наблюдаемую проблему, желательное поведение, ограничения и способ проверки. Подробный план реализации при этом не всегда нужен заранее: его агент может предложить после исследования.
В учебной задаче с каталогом вход можно сформулировать так: клиент видит товар доступным, хотя всё количество уже зарезервировано. Требуется согласовать отображаемую доступность с подтверждённым правилом учёта, сохранить совместимость действующего API и не менять порядок резервирования. Проверка должна воспроизводить исходную проблему и подтверждать поведение после изменения.
Полезно отделять требование от гипотезы о решении. «Не показывать зарезервированное количество как доступное» — требование. «Вычесть поле X в методе Y» — гипотеза, которая может оказаться неверной, если поле имеет другую семантику или расчёт выполняется ещё в одном месте.
У задачи должны быть границы остановки. Например, если исследование обнаружило необходимость изменить финансовый контракт или выполнить разрушительную миграцию, агент поднимает вопрос, а не расширяет полномочия из желания завершить работу. Такое правило является частью процесса исполнения, а не отказом от автоматизации.
Результат постановки — вход, по которому можно отличить завершённую задачу от красивого отчёта. Для исправления дефекта это включает исходное проявление, ожидаемое поведение и проверяемое отсутствие определённых регрессий.
Контур верификации: от статических правил до сквозного поведения
Верификация — центральная часть агентной разработки. Проверять нужно не только синтаксис и отдельную функцию, но и поведение в связанной системе. В докладе для этого используется идея Testing Trophy: статические проверки, модульные, интеграционные и сквозные тесты выполняют разные роли. Исходная модель Testing Trophy описана у Кента Доддса.
Для Enterprise особенно важны стыки. Два сервиса могут корректно проходить собственные тесты и не работать вместе из-за несовпадающих контрактов, конфигурации, прав, маршрутов или трактовки данных.
| Проверка | Что способна обнаружить | Что остаётся за её границами |
|---|---|---|
| Типы, линтеры, статические анализаторы | Несогласованные типы и часть нарушений правил | Соответствие бизнес-результата намерению |
| Модульные тесты | Ошибки локального поведения | Реальные взаимодействия сервисов |
| Контрактные проверки | Несовместимость формата и обязательств сторон | Полную работоспособность развёрнутой системы |
| Интеграционные тесты | Ошибки взаимодействия компонентов | Все пользовательские маршруты |
| Сквозные сценарии | Поведение цепочки в выбранной среде | Все варианты нагрузок и внешних условий |
| Визуальная проверка | Перекрытия, обрезанный текст, явные дефекты интерфейса | Корректность скрытых данных и всех действий |
| Smoke после поставки | Базовую жизнеспособность развернутой версии | Полный регресс и долговременную устойчивость |
Таблица — распределение задач, а не обещание полноты каждого инструмента. Если один уровень поймал ошибку раньше, агенту дешевле исправить её до длительного сквозного прогона. Но быстрый уровень не должен подменять тот, который проверяет изменённое взаимодействие.
Обязательные проверки определяются риском изменения. Правка текста интерфейса и изменение резервирования товара не обязаны иметь одинаковый набор прогонов. При этом основание выбора должно быть понятным и машиночитаемым, чтобы агент не придумывал его каждый раз заново.
AI QA и визуальные тесты: сценарий нужен до обхода интерфейса
Агент может открыть приложение, пройти действия и изучить скриншот. В докладе это рассматривается как дополнительный слой проверки, особенно там, где код и обычные тесты не показывают визуальную проблему. Доступные способы браузерной автоматизации описывает, например, проект agent-browser.
Полезный визуальный сценарий задаёт роль пользователя, состояние данных, последовательность действий и ожидаемые признаки. Для страницы остатков это может быть выбранный склад, товар с резервом, допустимый текст статуса и отсутствие наложения элементов. Скриншот фиксируется вместе с условиями, при которых его получили.
Если агент сам придумал сценарий после реализации и проверил только удобный путь, такая проверка способна подтвердить лишь его собственное предположение. Поэтому критичные условия лучше определить до изменения и сверить независимо от автора патча.
Визуальный судья тоже может ошибаться: не заметить элемент за пределами кадра, неверно истолковать иконку, принять заглушку за реальный результат. Нужны проверка состояния данных и, где возможно, детерминированные утверждения. Красивый скриншот не подтверждает, что резерв действительно учтён в расчёте.
Для повторяющихся маршрутов сохраняйте устойчивые сценарии. Исследовательский обход полезен дополнительно, когда агент ищет неожиданные последствия, но не должен быть единственным доказательством работоспособности.
Тяжёлые проверки: зачем агенту CI и выделенные окружения
Большая сборка, интеграционный прогон или тестирование настольного приложения могут быть неудобны на машине разработчика. В докладе обсуждаются два маршрута: существующий CI и выделенная виртуальная машина, куда агент передаёт тяжёлую работу.
Здесь важен не сам способ запуска, а воспроизводимость. Для результата нужно знать ревизию кода, конфигурацию среды, выбранный набор тестов и итоговый статус. Агент должен отличать провал проверки от ситуации, когда проверка вообще не началась из-за отсутствующей зависимости или доступа.
У удалённого запуска полезны явный идентификатор работы, получение статуса, доступ к ограниченному фрагменту журнала и отмена. Не следует превращать длительную команду в немую операцию, о которой агент знает только «ещё выполняется».
Тестовая среда должна подходить задаче. Макет очереди, локальная база и реальные сетевые политики выявляют разные классы дефектов. Если проверка выполнена на упрощённом окружении, это ограничение сохраняется в результате, а не исчезает при слове «успешно».
Результат этапа — запуск, который можно повторить и связать с конкретным изменением. Он помогает замкнуть обратную связь, но сам по себе ещё не является разрешением поставки в production.
Инфраструктурный фундамент: IaC, среды, резервирование и доставка
Ключников подчёркивает, что часть препятствий существовала задолго до ИИ: неповторяемые стенды, ручные настройки, неясный процесс поставки и трудный доступ к диагностике. Агент ускоряет выполнение операций, но не устраняет организационный хаос автоматически.
Infrastructure as Code, IaC, описывает инфраструктуру в форме, которую можно хранить, проверять и воспроизводить. В выступлении упоминается Pulumi; для общей архитектуры важнее принцип управляемого описания и жизненного цикла, чем конкретный инструмент.
Нужно различать желаемую конфигурацию, сохранённое состояние инструмента и фактически работающие ресурсы. Они могут разойтись из-за ручной правки, внешнего действия или незавершённой операции. Поэтому утверждение «всё описано кодом — drift невозможен» слишком сильное. Официальная документация Pulumi отдельно описывает обнаружение и согласование drift.
Для агентной работы полезны раздельные среды, воспроизводимое создание ресурсов, управляемая доставка, восстановление и наблюдаемость. Сначала определите, где разрешены эксперименты и какие данные там используются. Тестовый контур с копией production-секретов не становится безопасным от названия dev.
В GitOps-схеме инструмент доставки сопоставляет желаемое состояние с реальным. Но автоматическая синхронизация, удаление ресурсов и self-heal имеют отдельные настройки. Например, Argo CD документирует эти механизмы раздельно. Их нельзя считать одинаково включёнными и одинаково допустимыми для любой среды.
Результат этапа — понятный путь от изменения описания до работающего ресурса и способа возврата. Агент должен пользоваться этим путём, а не создавать параллельную инфраструктуру, о которой не знает команда.
Где нужен LLM, а где лучше детерминированный инструмент
В докладе проведена полезная граница: вариативное исследование и выбор гипотез можно поручать модели, а повторяющиеся операции стоит оформлять как инструменты и workflow. Если агент каждый раз заново пишет клиент API, чтобы получить статус одного сервиса, процесс теряет предсказуемость.
Хорошие кандидаты на детерминированный слой — получение статуса поставки, поиск логов по идентификатору, запуск утверждённого smoke, чтение доступной схемы или получение результата конкретной CI-работы. У операции есть вход, ограниченная область действия, результат и понятная ошибка.
LLM остаётся там, где нужно сопоставить несколько сигналов, сформировать гипотезу, выбрать следующий диагностический шаг или предложить изменение. Она использует инструменты, но не обязана каждый раз изобретать механизм их вызова.
Техническая оболочка может быть CLI, MCP или API. Ключников описывает свой вариант CLI со скиллами, но не объявляет этот вариант единственно возможным. Сравнение интерфейсов вынесено в материал о CLI, Skills, API и Code Mode. Для фабрики важно качество действий и ответов, а не модность транспорта.
Как выглядит интерфейс, которым агент действительно может пользоваться
Просто обернуть существующий API недостаточно. Интерфейс должен помогать выбрать нужную операцию, ограничивать ненужный объём и отличать достоверный результат от неполной выборки.
Спикер приводит пример логов: вместо огромного файла агенту нужна подходящая выборка с возможностью продолжения. В ответе полезны среда, сервис, временной диапазон, признаки фильтрации и сведения о том, что осталось за границами результата. Скрыто усечённый ответ опасен тем, что выглядит полным.
Предлагаемый контракт чтения диагностических данных может возвращать такие поля:
{
  "operation": "read_service_errors",
  "environment": "stage",
  "service": "inventory",
  "status": "completed",
  "scope": "errors linked to the requested operation",
  "result_complete": false,
  "has_more": true,
  "continuation_available": true,
  "sensitive_fields_removed": true
}
Это учебный эскиз ответа, а не существующий API или фактически выполненный запрос. Конкретные фильтры, формат продолжения и проверка удаления чувствительных полей требуют реализации. Значение sensitive_fields_removed не является доказательством само по себе: соответствующее свойство должно обеспечиваться инструментом и проверяться.
Для изменяющих действий дополнительно нужны ограничения среды, повторяемость при сетевой ошибке и ясный статус. Если запрос создания ресурса завершился тайм-аутом, нельзя автоматически считать, что ресурс не создан, и повторять операцию без выяснения состояния.
Описания инструментов тоже проверяются на реальных задачах. Понятное человеку имя не гарантирует, что агент выберет инструмент в нужный момент. В то же время увеличение числа инструментов не означает обязательного ухудшения: важны различимость, структура и поведение в выбранной конфигурации.
Права агентов: разработчик, наблюдатель, оператор и поставка
Разделяйте возможность модели предложить действие и право системы исполнить его. Скилл с текстом «не ходи в production» может объяснять правило, но фактический запрет должен поддерживаться учётной записью, инструментом, сетью и средой исполнения.
Предлагаемое разделение ролей:
| Роль | Разрешённая работа | Что не следует включать по умолчанию |
|---|---|---|
| Исследователь | Чтение разрешённого кода и документации | Изменение инфраструктуры и доступ ко всем секретам |
| Разработчик | Подготовка изменений и проверки в выделенном контуре | Прямая поставка в критичную среду |
| Наблюдатель | Чтение разрешённой телеметрии и создание диагностической задачи | Неограниченная автоматическая починка |
| Оператор тестового контура | Управляемые операции в конкретной среде | Такие же права во всех окружениях |
| Исполнитель поставки | Утверждённые операции delivery по политике | Самостоятельное расширение набора разрешённых действий |
Это вариант проектирования, а не готовая настройка ролей. В Kubernetes механизмы привязки прав к ролям и учётным записям описаны в документации RBAC. Реальная конфигурация должна соответствовать используемой платформе и полномочиям команды.
В транскрипте отдельно обсуждаются секреты. Инструмент может использовать ключ внутри доверенного слоя, не возвращая сам ключ в контекст модели. Но это не решает проблему чрезмерных полномочий операции: скрытый ключ с правом удалить всё окружение остаётся опасным.
Ограничивайте доступ к секретам и проверяйте, где они появляются в журналах и ошибках. Рекомендации Kubernetes отдельно рассматривают минимизацию доступа к Secrets. Инструкция агенту не должна быть единственной защитой данных.
Наблюдаемость: как агенту найти причину до изменения кода
В распределённой системе ошибка пользователя редко содержит всю необходимую информацию. Проблема может проявиться в интерфейсе, возникнуть в очереди и закрепиться в фоновом обработчике. Если агент видит только исходники, он вынужден угадывать путь конкретного сбоя.
Observability, или наблюдаемость, помогает связать симптомы с работой компонентов. Для агентной разработки особенно полезна возможность получить ограниченный набор логов, статусов и трассировок вокруг одной операции. Distributed trace описывает прохождение запроса через связанные участки исполнения; его состав и идентификаторы объясняет OpenTelemetry.
Порядок диагностики может выглядеть так: найти проблемную операцию, уточнить среду и версию, получить связанный trace, сопоставить ошибки компонентов, сформулировать гипотезу и только затем открывать конкретный участок кода. При необходимости агент возвращается за дополнительными данными.
Пример из обсуждения инфраструктуры — сервис транскрибации с несколькими связанными компонентами. Для методического разбора представим загрузку файла, очередь, обработчик и сохранение результата. Каждый компонент способен пройти локальный тест, но весь процесс остановится, если обработчик читает другую очередь или не имеет права записать результат. Это иллюстративная схема, не проверенный нами клиентский кейс.
Тогда полезное исправление начинается не с переписывания распознавания речи, а с выяснения, на каком переходе пропала операция. Агенту нужны и контекст процесса, и фактические сигналы окружения. Иначе он может изменить корректный код, пытаясь компенсировать ошибочную конфигурацию.
Трассы приложения и история действий агента — разные данные
В докладе обсуждаются два вида наблюдения, которые полезно не смешивать. Трассы приложения показывают, как исполняется бизнес-операция. История действий агента показывает, что он читал, какие инструменты вызывал, где получил ошибку и когда человек его поправил.
Вторая история помогает улучшать сам процесс разработки. Если агент регулярно делает одну последовательность запросов, её можно превратить в инструмент. Если он постоянно ошибается в выборе среды, стоит проверить интерфейс и ограничения, а не только дописывать длинный запрет в промпт.
Для анализа сохраняйте достаточно сведений, чтобы восстановить путь, но не собирайте секреты и лишние чувствительные данные ради полноты. Возможность экспорта, формат и содержание агентной телеметрии зависят от продукта и настроек. Нельзя считать, что любой coding agent автоматически отдаёт одинаковые OpenTelemetry-трассы.
Наблюдение должно завершаться изменением процесса: повторяющаяся ошибка превращается в уточнённую инструкцию, более подходящее действие или проверку. Если журналы только копятся и не используются, сама по себе централизованная коллекция не улучшает фабрику.
Workflow для багфикса, новой функции и рефакторинга
Ключников предлагает выделять повторяющиеся блоки работы и собирать из них понятные workflow. Для типового запроса маршрут можно задать жёстче, для исследовательской задачи — оставить пространство выбора между разрешёнными действиями.
Предлагаемый workflow исправления дефекта:
- Уточнить симптом, среду, версию и границы разрешённого воздействия.
- Получить диагностические данные и воспроизвести проблему либо явно отметить, что воспроизведение не удалось.
- Найти связанный бизнес-процесс, правила и область влияния изменения.
- Предложить причину и минимально достаточный план исправления.
- Изменить реализацию и нужные проверки, сохранив исходные критерии задачи.
- Пройти локальные и связанные интеграционные проверки, затем контролируемую проверку в подходящей среде.
- Сохранить фактический результат, ограничения, артефакты и вопрос о следующем разрешённом переходе.
Для новой функции добавляются уточнение намерения и выбор решения. Для рефакторинга основной вопрос другой: какое наблюдаемое поведение должно сохраниться и какое техническое свойство должно измениться. Если это не сформулировать, «улучшение архитектуры» превращается в субъективную перестройку.
Workflow полезно описывать через вход, ожидаемый выход, допустимые действия и условия остановки каждого блока. Тогда его можно переиспользовать и оценивать. Название файла SKILL.md само по себе не делает процесс повторяемым.
Собственный eval: оценивайте решённую задачу, а не совпадение патча
Eval — организованная проверка системы на задачах с определёнными условиями и критериями. Для агентной разработки он нужен не только при смене модели: полезно проверять новые инструкции, инструменты и способы организации работы.
В обсуждении предлагается брать исторические задачи. Для каждой восстановите исходное состояние проекта, текст запроса, доступный на тот момент контекст и ожидаемое поведение. Затем проверьте, способен ли агент получить приемлемый результат из этого входа.
Не подмешивайте будущее решение в исходный контекст. Коммит с исправлением, поздний комментарий в задаче или обновлённый документ могут превратить исследование в поиск готового ответа. Если это не контролировать, оценка будет выглядеть лучше реальной работы.
Эталонный человеческий diff не обязан быть единственным допустимым результатом. Агент может решить задачу иначе, а прежняя правка могла быть лишь временным обходом. Проверять следует обязательное поведение, ограничения и последствия, а не буквальное совпадение строк.
При этом нельзя позволять исполнителю незаметно ослаблять условия успеха. Разделите средства разработки и независимые критерии оценки. Отдельный набор сценариев, о котором говорит StrongDM, — один из вариантов такого разделения; устройство проверочного контура всё равно требует инженерной работы.
Неудачные задачи особенно полезны для улучшения. Разберите, что не получилось: не найден контекст, неправильно понято требование, недоступен инструмент, выбран неверный путь диагностики или реализация действительно ошибочна. Разные причины требуют разных исправлений фабрики.
Судьи на LLM, повторяемость и показатели качества
Модель-судья полезна там, где результат трудно выразить одним детерминированным утверждением. Но она тоже может ошибаться, предпочитать более убедительную формулировку и не видеть нарушения скрытого ограничения. В докладе обсуждается необходимость разбирать расхождения оценок, а не объявлять одну модель абсолютным эталоном.
Для проверяемых свойств используйте обычные тесты и проверки данных. Для смысловой оценки задайте рубрику и сравните с решениями компетентных людей на выбранных примерах. Спорный результат должен оставаться спорным до разбора, а не превращаться в красивую среднюю цифру.
Повторяйте прогоны в сопоставимых условиях: агентные траектории недетерминированы. Одна удачная попытка не подтверждает стабильность. Одновременно фиксируйте версию модели, инструменты, инструкции, входную ревизию, лимиты и условия среды.
Полезные показатели для внутреннего eval:
| Показатель | Что считать | Почему одного показателя мало |
|---|---|---|
| Принятые результаты | Задачи, прошедшие заданные критерии, относительно всех выбранных задач | Нужен понятный состав выборки |
| Полная стоимость | Расходы на попытки, проверки и исправления | Дешёвая попытка может оказаться бесполезной |
| Время до принятого результата | Весь путь, включая ожидание проверок и участие человека | Быстрая генерация не равна быстрой поставке |
| Вмешательства человека | Причины и действия оператора | Само количество не показывает тяжесть вмешательства |
| Регрессии | Нарушенные ранее работающие свойства | Успех новой функции может скрыть ущерб старой |
| Соблюдение границ | Отказы и попытки запрещённых действий | Качественный код не компенсирует нарушение полномочий |
Это предлагаемые определения, не результаты редакционного замера. Порог приемлемости зависит от продукта. Сравнивать стоимость имеет смысл для принятой работы, учитывая неудачные попытки и время специалистов, а не только цену одного вызова модели.
Как ограничить циклы исправления и не получить бесконечный ремонт
Обратная связь необходима, но сама по себе не обеспечивает сходимость. Агент может многократно исправлять один симптом, менять тесты под новую реализацию или ходить между несколькими гипотезами без накопления знания.
У рабочего цикла должны быть ограничение ресурсов и условия остановки. Например: проверка многократно недоступна; причины провалов не меняются; обнаружен неизвестный контракт; требуется действие вне полномочий; исправление расширяет область влияния за пределы задачи. Конкретные лимиты устанавливает владелец процесса.
При остановке нужен содержательный результат: что проверено, какая гипотеза осталась, какие артефакты собраны и какое решение требуется. Передача человеку должна экономить повторное исследование, а не состоять из сообщения «не получилось».
Не всякое ручное вмешательство является недостатком фабрики. Уточнение конфликтующего бизнес-правила у владельца процесса — правильный переход. Бесконечное самостоятельное угадывание такого правила хуже явно зафиксированного вопроса.
Технический долг: правила должны исполняться во время изменения
В обсуждении дрейф архитектуры рассматривается как продолжающийся процесс. Если проверять систему только после накопления большого объёма изменений, агентная скорость генерации способна увеличить масштаб последующего разбора.
Часть требований стоит выразить формально: допустимые зависимости модулей, контракты, типы, тестируемые инварианты. Архитектурные тесты помогают обнаруживать запрещённые связи. Мутационное тестирование может дополнительно показать слабость тестов, но требует ресурсов и осмысленного применения; оно не обязано выполняться целиком после каждой мелкой правки.
Оставшиеся требования проверяются по описанным правилам и суждению специалиста. Например, «не вводить второй конкурирующий способ доступа к данным без принятого решения» трудно полностью свести к одному линтеру. Здесь нужны понятная политика и контекст существующей архитектуры.
Мостовой сравнивает стремление к минимальному патчу и более сбалансированный инженерный подход. Ponytail и code-that-fits-in-your-head — опубликованные инструменты, но предпочтение спикера не является сравнительным доказательством эффективности. Второй опирается на книгу Марка Симанна *Code That Fits in Your Head* и авторские дополнения для агентной разработки.
Минимальное изменение не всегда лучшее: оно может закрепить плохую границу. Масштабный рефакторинг тоже не становится полезным от объёма. Сравнивайте последствия для конкретной задачи: понятность, проверяемость, совместимость и последующую стоимость изменения.
ADR и история решений: зачем сохранять причину «странного» кода
ADR, Architecture Decision Record, фиксирует контекст, принятое решение и последствия. Это помогает отличить случайную сложность от осознанного компромисса. Первоначальный подход описан у Майкла Найгарда.
Для агента запись особенно полезна там, где реализация внешне выглядит неидеально. Без причины он может удалить обходной механизм, который защищает старую интеграцию, или снова предложить уже отвергнутый вариант.
Полезный ADR отвечает на вопросы: какая проблема решалась, какие ограничения действовали, какие варианты сравнивали, почему выбрали текущий путь и когда решение нужно пересмотреть. Ссылка на код и обсуждение позволяет проверить связь решения с реализацией.
Если команда меняет архитектурный принцип, определите границу миграции. Локальное исключение не должно незаметно становиться ещё одним равноправным стандартом. Но и автоматическое переписывание всей кодовой базы ради единообразия не следует из самого наличия агентов: нужен план совместимости и проверяемые этапы.
В финале доклада упоминается и fpf-problem-solving как вспомогательный инструмент рассуждения над сложными решениями. Публикация навыка есть в репозитории. Это дополнительный метод работы с вариантами, а не обязательный компонент Dark Factory и не замена ответственности за архитектурный выбор.
Legacy: когда нужна миграция, а когда лучше улучшить работу с текущей системой
Устаревшая технология и неудобный человеку код ещё не доказывают, что систему нужно переписывать. В обсуждении приводится противоположная мысль: сначала проверить, способны ли агенты решать ограниченные задачи в существующей системе, получив контекст и подходящую верификацию.
Причина миграции должна быть связана с потребностью продукта: требуемым масштабированием, невозможностью поддерживать зависимости, ограничениями надёжности, изменяемости или эксплуатации. Фраза «так сейчас не пишут» не описывает экономический и технический результат.
Если миграция нужна, начните с восстановления фактического поведения. В коде может отсутствовать полная картина длинного процесса: часть шагов выполняют другие сервисы и люди. Нужны владельцы, данные, события, исключения и временные условия.
После этого зафиксируйте критичное поведение тестами и контрактами. Выделяйте границы постепенно, обеспечивая совместимость старого и нового пути. Логи помогают исследованию, но отсутствие события в логах не доказывает отсутствие соответствующего поведения.
Для изменения данных особенно важно отличать обратимость кода от обратимости состояния. Возврат прежней версии приложения не отменяет выполненную миграцию автоматически. Резервная копия тоже не равна безопасному откату: после её создания могли появиться новые записи и внешние последствия. Для такого перехода требуется отдельный согласованный план.
Задача агента здесь — помочь исследовать, подготовить и проверить управляемый этап. Решение о переходе критичного процесса не должно выводиться из того, что модель уверенно объяснила старый код.
Как распространять скиллы в команде и не заморозить плохую практику
В транскрипте проводится полезное различие между общими правилами организации и локальными заготовками. Единый способ подключения к утверждённому API можно распространять централизованно. Личный workflow, который экспериментально меняется каждый день, не стоит навязывать всей компании как готовый стандарт.
Для общего набора нужны владелец, версия, область применения и порядок изменения. Обновление инструкции способно повлиять на поведение агентов не меньше, чем обновление инструмента. Поэтому полезно понимать, какая версия использовалась в конкретном запуске и как вернуться к предыдущей.
Разделите обязательные политики, проверенные командные процессы и экспериментальные шаблоны. У шаблона должен быть ясный статус: его адаптируют под задачу, а не принимают как подтверждённую практику для любой системы.
Git, пакет, плагин или внутренний каталог решают вопрос доставки, но не качества. Необходимо проверить, что нужный агент обнаруживает навык, понимает условия применения и не получает конфликтующие инструкции из нескольких источников.
Результат этапа — управляемая библиотека процессов. Её ценность определяется тем, что она улучшает работу на задачах, а не количеством установленных файлов.
Дорожная карта перехода: какие результаты получать по этапам
Необязательно строить всю платформу перед первым полезным применением агента. Но расширять автономность следует по готовности конкретных условий. Следующий порядок — предлагаемый маршрут для существующего проекта, без универсальных сроков и обещаний окупаемости.
Этап 1. Выбрать процесс и установить границу воздействия
Назовите владельца, тип входных задач, нужный результат и запрещённые действия. Отделите чтение и объяснение от изменения кода, инфраструктуры и данных. Итог — ограниченный участок работы, который команда действительно готова исследовать с агентом.
Этап 2. Сделать контекст доступным и проверяемым
Подготовьте карту проекта, определения ключевых терминов, инварианты и решения. Разберите существенные противоречия с владельцами. Итог — не «вся документация готова», а возможность найти действующее правило для выбранного процесса и проверить его источник.
Этап 3. Обеспечить исполнение и обратную связь
Поднимите подходящее окружение, настройте доступ к сборке, тестам и диагностике. Агент должен видеть фактический статус проверки и различать инфраструктурный сбой с ошибкой изменения. Итог — воспроизводимый путь проверки для выбранных задач.
Этап 4. Оформить повторяющиеся действия
Выделите инструменты и workflow, выдайте ограниченные права, обеспечьте понятные ответы и остановку. Итог — агент не пишет заново одни и те же служебные скрипты и не получает лишних полномочий ради удобства.
Этап 5. Проверить конфигурацию на исторических и новых задачах
Восстановите корректные входные состояния, задайте критерии и разберите результаты. Учитывайте участие человека и стоимость неуспешных попыток. Итог — аргументированное решение о том, какой класс задач конфигурация действительно поддерживает.
Этап 6. Расширять автономность с отдельным решением для каждого риска
Автоматизация подготовки PR не означает готовности автоматизировать миграции production. Для следующей зоны заранее проверьте ограничения, диагностику, отмену и восстановление. Итог — расширенная, но по-прежнему определённая область самостоятельной работы.
После каждого этапа возвращайтесь к реальным сбоям и улучшайте слабый слой. Если агент не видит нужных логов, смена модели может оказаться дороже исправления диагностического инструмента. Если ошибочно само бизнес-правило, дополнительный тест на то же правило лишь закрепит ошибку.
Сквозной пример: изменение доступного остатка в существующем продукте
Рассмотрим вымышленную систему интернет-магазина. Каталог показывает доступность товара, отдельный сервис управляет резервом, а учётная система присылает обновления. Есть фоновая обработка и старый клиент API. Ситуация создана для объяснения подхода и не описывает проект заказчика.
Запрос: покупатель видит товар доступным, хотя его нельзя отгрузить. Владелец процесса хочет исправление без изменения порядка резервирования и без поломки старого клиента.
Сначала исследователь собирает правила. Выясняется, что физический остаток отличается от доступного, а часть количества находится в отдельном состоянии, которое нельзя предлагать покупателю. Тезаурус связывает слова с понятиями системы; спорные трактовки подтверждает владелец склада. Агент не назначает формулу по привычному смыслу имени поля.
Затем строится карта влияния. Расчёт используется не только карточкой товара: данные проходят через API, кеш и обмен. История совместных правок подсказывает адаптер старого клиента. Это повод открыть код и тесты, а не автоматически редактировать все найденные файлы.
До реализации задаются сценарии: обычный доступный товар, полностью зарезервированный товар, состояние недоступности по складскому правилу и задержка обновления. Отдельно сохраняется совместимость действующего контракта. Конкретная допустимая задержка должна прийти из требований, а не из случайно выбранного числа в примере.
Разработчик вносит согласованное изменение и выполняет быстрые проверки. Интеграционный прогон проверяет цепочку расчёта и передачи данных, а в stage проверяется поведение развёрнутых компонентов. Если результат не обновился, агент получает связанные события и логи, чтобы отличить неверную формулу от неправильной конфигурации кеша или обмена.
При обнаружении необходимости изменить схему данных процесс выходит на отдельное решение. Не следует расширять задачу молча: обещание «просто исправить отображение» могло скрывать изменение общей модели доступности. Вопрос возвращается владельцу с собранными основаниями.
После успешной проверки остаются код, фактические результаты прогонов, принятые определения, при необходимости ADR и ограничения. Переход в следующую среду выполняется по её политике. Так выглядит полезная агентная автономность: самостоятельное исследование и проверка внутри границ, которые команда способна объяснить.
Как понять, что проект ещё не готов к большей автономности
Оценивайте не абстрактный процент зрелости, а препятствия конкретного перехода. Агент может быть полезен для поиска и объяснения даже там, где самостоятельное изменение пока недопустимо.
О расширении полномочий рано говорить, если команда не умеет определить хороший результат, воспроизвести проверку или назвать владельца критичного правила. Другие сильные сигналы — отсутствие управляемой среды, недоступность диагностики и невозможность выяснить, что реально произошло после неудачной команды.
Если контекст есть только в памяти одного специалиста, начните с его извлечения. Если инструкции противоречат друг другу, разрешите конфликт. Если каждый релиз требует ручной операции с неизвестными условиями, сначала опишите и проверьте её. Такие действия полезны и для людей, и для агентов.
Ключников отдельно оговаривает чувствительность production-операций и миграций. Этот нюанс важнее привлекательного образа «поставили задачу и ушли». Критичность системы определяется последствиями ошибки, а не тем, насколько хорошо модель справилась с демонстрацией.
Частые вопросы о Dark Factory в Enterprise
Можно ли обойтись без GraphRAG и контекстного движка?
Да, если доступная навигация, поиск и документация позволяют качественно решать выбранные задачи. GraphRAG, то есть использование графовых представлений в поиске и сборке контекста, — возможное дополнение. Его пользу нужно измерять, а не выводить из размера репозитория.
Достаточно ли написать хороший AGENTS.md?
Нет. Он может объяснить, где искать правила и как работать, но не создаёт отсутствующие тесты, права, окружения и данные. Инструкция полезна, когда направляет к реально существующим возможностям.
Нужно ли людям читать весь код, который пишет агент?
Единого ответа для всех классов изменений нет. Организация определяет политику по риску и доказательствам проверки. В докладе в итоге сохраняется роль инженера, способного оценить существенное решение, особенно если речь идёт об архитектуре и последствиях для продукта.
Можно ли доверить одному агенту код и его проверку?
Он может выполнять оба вида работы, но критерии не должны незаметно подстраиваться под его реализацию. Используйте независимые сценарии и проверки подходящего типа. Отдельный агент-рецензент тоже остаётся моделью и сам по себе не создаёт независимую гарантию.
Что делать, если новая модель делает часть инструментов ненужной?
Повторить оценку конфигурации. Уберите инструмент в контролируемом сравнении и посмотрите на качество, стоимость и время принятой работы. Неявные бизнес-знания при этом не становятся ненужными только потому, что модель усилилась.
Обязательно ли переводить всё в микросервисы?
Нет. Выбор архитектуры должен опираться на требования продукта и эксплуатации. Понятный модульный монолит может быть удобнее плохо наблюдаемой сети сервисов. Агентная разработка не отменяет цену распределённых взаимодействий.
Можно ли передать агенту production-секреты, если запретить их показывать?
Текстовый запрет не заменяет контроль доступа. Предпочтительнее ограниченная операция в доверенном инструменте, минимальные права и контроль вывода. При этом надо оценивать и полномочия операции, и риск появления секрета в журналах.
Что считать успехом первого внедрения?
Повторяемое выполнение ограниченного класса задач с понятными качеством, стоимостью, участием человека и соблюдением границ. Единичная впечатляющая демонстрация или уменьшение числа написанных человеком строк не описывают весь результат.
Источники и границы этого руководства
Основа — предоставленный пользователем транскрипт доклада и последующей дискуссии. Оригинальная запись опубликована на канале AI-Driven Development; название и авторство дополнительно сверены по метаданным YouTube. Аудио и каждый момент видеозаписи мы отдельно не пересверяли, поэтому не приводим восстановленные по догадке таймкоды и спорные названия моделей из автоматического распознавания.
Идеи о контексте, проверках и инфраструктуре пересказаны и систематизированы. Схемы ролей, дорожная карта, эскиз ответа инструмента и сквозной складской пример — предлагаемые редакционные конструкции. Они не выдаются за готовую платформу спикеров или доказанный результат их клиента.
Перечень опубликованных практик и навыков можно посмотреть в репозитории CodeAlive-AI. Документация AGENTS.md, Claude Code, OpenTelemetry, Pulumi, Argo CD и Kubernetes использована для уточнения технических границ. Первичные материалы сверены 12 ноября 2026 года. Реализации, поддержка функций и значения настроек могут меняться; применимость конкретного решения проверяется в выбранном стеке.
Числа из текущего описания Real-SWE относятся только к его заявленному набору. Мы не воспроизводили этот benchmark, не сравнивали инструменты спикеров и не измеряли окупаемость Dark Factory. Пересказ доклада не означает, что его авторы одобрили это руководство или услуги студии.
Как AI студия Владимира Ломтева помогает подготовить процесс к ИИ-агентам
AI студия Владимира Ломтева может провести аудит выбранного процесса, подготовить данные и корпоративные знания, разработать и протестировать MVP агентной автоматизации, интегрировать его с бизнес-системами и интерфейсами. Это работы по конкретной задаче, а не обещание превратить любой Enterprise в полностью автономную фабрику.
Начать стоит с одного процесса: описать, как он работает сейчас, какие источники нужны, какие ограничения действуют и что считается пригодным результатом. Так можно определить, какие части работы уже готовы к автоматизации и где сначала потребуется подготовка. Обсудить задачу.
Итог: Dark Factory начинается с управляемого процесса
Для существующего Enterprise переход к агентной разработке складывается из нескольких взаимосвязанных работ: сделать знания доступными, обеспечить проверку результата, подготовить инфраструктурные действия и определить границы полномочий. Сильная модель помогает внутри этой системы, но не подменяет её.
Первый практический шаг — выбрать ограниченный процесс и пройти его путь целиком: от требования и контекста до проверки и фактического состояния среды. По результату станет видно, чего не хватает именно вашему проекту: определения термина, теста на стыке, диагностического инструмента или управляемой операции поставки.
Расширяйте автономность там, где появился проверяемый результат и понятный следующий уровень риска. Тогда Dark Factory становится направлением инженерного развития, которое можно оценивать по принятой работе, а не только привлекательным названием.