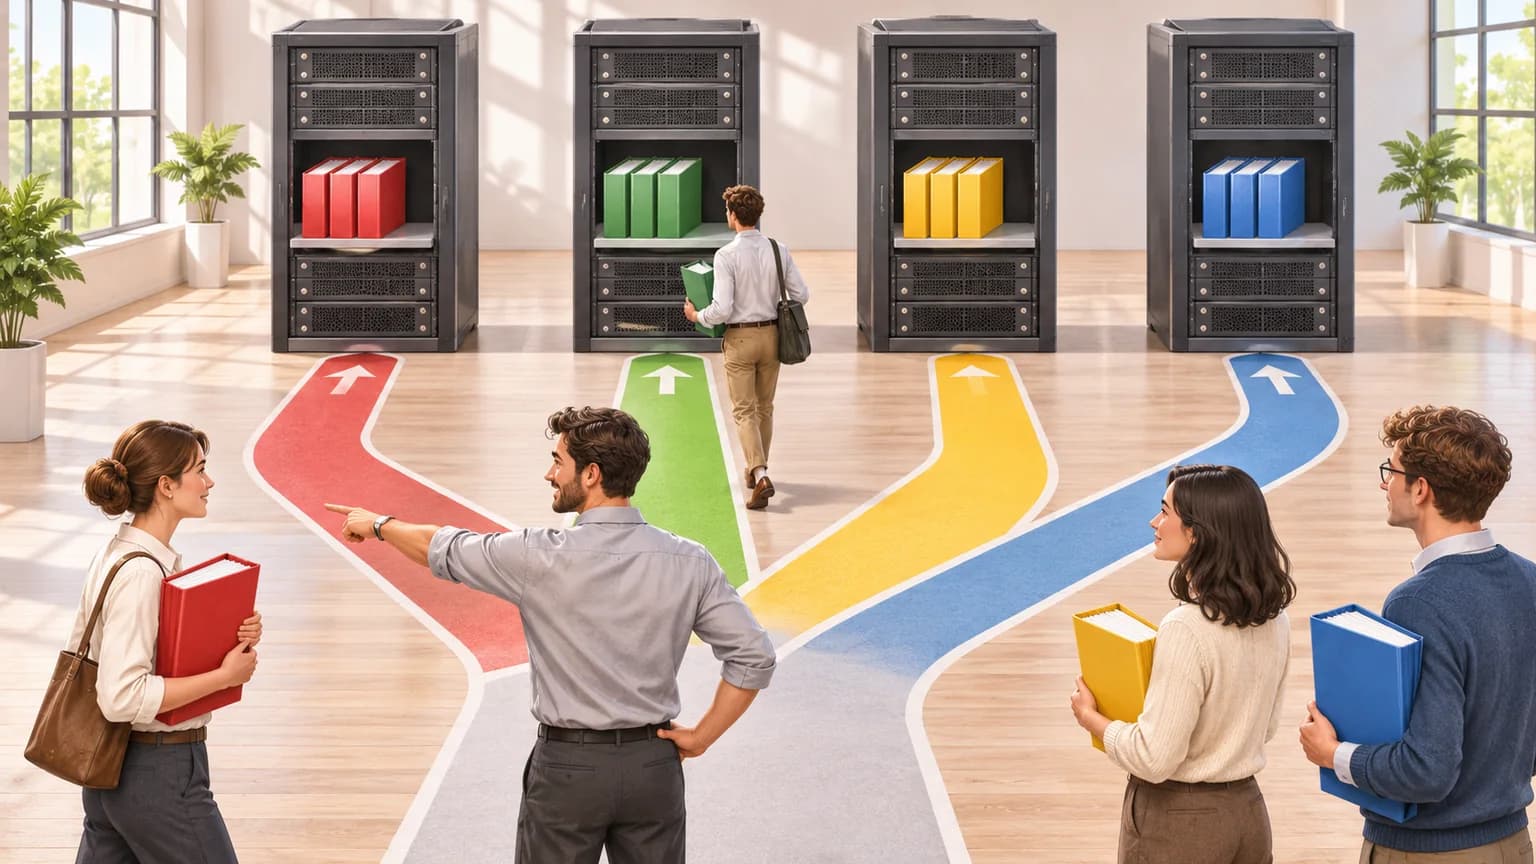
Когда модель работает в нескольких репликах, обычный балансировщик раскидывает запросы по кругу и разрушает пользу prefix caching: следующий ход диалога попадает на реплику, где его истории в кэше нет. Маршрутизация с учётом KV-кэша отправляет запрос туда, где уже лежит самый длинный совпадающий префикс, и уходит на менее загруженную реплику, когда кэш-реплика перегружена. Такую логику дают SGLang Model Gateway, llm-d, NVIDIA Dynamo и шлюзы на основе Gateway API Inference Extension.
Материал подготовила AI студия Владимира Ломтева 16 ноября 2026 года для команд, у которых LLM обслуживают две и больше реплики vLLM или SGLang. Описание механизмов и флагов сверено с документацией проектов; у Dynamo мы опирались на страницу маршрутизатора версии 0.8.1 и рекомендуем сверить её с документацией вашей версии. Собственных замеров не проводили, расчёты ниже условные.
Содержание
- Почему круговой балансировщик теряет кэш
- Три способа направлять запросы
- Как совместить кэш и нагрузку
- Запуск на SGLang: пример из документации
- Запуск в Kubernetes: llm-d и Gateway API Inference Extension
- Горячие точки и как их избежать
- Как измерить эффект
- Когда это не нужно
- Частые вопросы
Почему круговой балансировщик теряет кэш
Prefix caching в движке экономит prefill, если начало нового запроса совпадает с тем, что уже обработано на этой же реплике. Подробно механизм разобран в статье о KV-cache и prefix caching. Кэш каждой реплики лежит в её видеопамяти, и соседняя реплика им воспользоваться не может.
Условный пример. Есть четыре одинаковые реплики и балансировщик round-robin. Пользователь ведёт диалог из десяти ходов. Каждый следующий ход несёт всю предыдущую историю, но попадает на ту же реплику, что и предыдущий, примерно в одном случае из четырёх, то есть с вероятностью около 25%. В остальных трёх случаях история проходит prefill заново. Чем длиннее история и чем больше реплик, тем больше GPU тратится на повторную работу.
С общими системными промптами похожая картина. Если у всех запросов первые 3000 токенов одинаковы, каждая из четырёх реплик держит свою копию этого префикса. Это не страшно, пока память есть, но при нехватке префикс вытесняется и пересчитывается по очереди на каждой реплике.
Три способа направлять запросы
| Способ | Как работает | Плюсы | Минусы |
|---|---|---|---|
| Привязка к сессии | Хеш от идентификатора пользователя или диалога выбирает реплику | Просто, работает на любом балансировщике | Не учитывает общие префиксы и нагрузку, возможны перекосы |
| Приблизительная маршрутизация по префиксу | Маршрутизатор ведёт собственный индекс того, что куда отправлял | Не требует изменений в движке | Индекс расходится с реальным кэшем после вытеснений |
| Точная маршрутизация по событиям KV | Движок публикует события о создании и вытеснении блоков, маршрутизатор строит индекс | Знает реальное состояние кэша | Нужны события из движка, токенизация и отдельная инфраструктура |
Привязка к сессии
Самый простой вариант: балансировщик Nginx, Envoy или ваш шлюз хеширует session_id и всегда отправляет диалог на одну реплику. Для чатов с длинной историей это уже даёт большую часть выигрыша. Слабые места два: популярный клиент или агент может перегрузить одну реплику, а при выходе реплики из строя все её сессии переедут и потеряют кэш.
Приблизительный индекс
Маршрутизатор запоминает, какие префиксы куда отправил, и сравнивает с ними новые запросы. В документации llm-d такой оценщик описан как лёгкий и без внешних зависимостей: он делит промпт на блоки фиксированного размера, по умолчанию 64 токена, приближённо считая их символами, и даёт оценку по доле совпавших блоков. Там же отмечено, что этот индекс может расходиться с реальным состоянием серверов.
Точный индекс по событиям KV
Движок сам сообщает, какие блоки он создал и вытеснил. В точном режиме llm-d использует идентификаторы токенов и события от серверов модели через ZeroMQ и по ним строит глобальный индекс. Пока событие о новом блоке не пришло, следующий запрос с тем же префиксом мог бы уйти на другую реплику; для этого случая есть спекулятивное индексирование, которое добавляет временную запись сразу после решения о маршруте.
Как совместить кэш и нагрузку
Если отправлять всё туда, где кэш лучше, одна реплика станет горячей, а остальные будут простаивать. Поэтому все инструменты сочетают попадание в кэш с оценкой загрузки, и каждый делает это по-своему.
NVIDIA Dynamo. На странице KV-маршрутизатора Dynamo 0.8.1 стоимость реплики считается как kv_overlap_score_weight × блоки, которые нужно будет пересчитать + активные блоки, и выбирается реплика с меньшей стоимостью. Вес по умолчанию 1.0: выше — важнее сократить prefill и время до первого токена, ниже — важнее скорость генерации. --router-temperature по умолчанию 0.0 даёт детерминированный выбор лучшей реплики, значения больше нуля включают вероятностный выбор и сглаживают перекосы.
SGLang Model Gateway. По документации шлюза политика cache_aware держит дерево префиксов каждой реплики, построенное по KV-событиям, и отправляет запрос на реплику с самым длинным совпадением, если оно не меньше порога. Если такой реплики нет или она упёрлась в лимит допуска, срабатывает power_of_two: выбрать две случайные реплики и отдать запрос менее загруженной. Режим --affinity-mode balanced позволяет уводить запросы с перегруженной кэш-реплики.
llm-d. В руководстве по точной маршрутизации фильтр prefix-cache-affinity-filter держит группу запросов на прогретых репликах, пока их нагрузка ниже откалиброванного порога peakPrefillThroughput. Когда прогретые реплики насыщены, фильтр переключается на наименее загруженные, а token-load-scorer выбирает реплику с наименьшей нагрузкой по токенам в обработке.
Запуск на SGLang: пример из документации
Каждая реплика публикует события KV и сведения о загрузке:
python -m sglang.launch_server \
  --model-path meta-llama/Meta-Llama-3.1-8B-Instruct \
  --kv-events-config '{"publisher":"zmq","endpoint":"tcp://*:5557","topic":"kv"}' \
  --load-publish-endpoint auto \
  --port 8000
Маршрутизатор подключается к репликам с политикой cache_aware:
sgl-router \
  --model-id meta-llama/Meta-Llama-3.1-8B-Instruct \
  --worker-urls http://node1:8000 http://node2:8000 \
  --chat-routing reorg \
  --policy cache_aware \
  --host 0.0.0.0 --port 30000
Готовность проверяют запросом curl http://localhost:30000/readiness, пока он не вернёт HTTP 200. Если маршрутизатор слушает все интерфейсы, закройте порт сетевыми правилами или поставьте перед ним шлюз с аутентификацией.
Запуск в Kubernetes: llm-d и Gateway API Inference Extension
Gateway API Inference Extension — официальный проект Kubernetes, который превращает шлюзы с поддержкой ext-proc и Gateway API, например Envoy Gateway, kgateway и GKE Gateway, в шлюзы для инференса. Набор реплик описывается ресурсом InferencePool, а выбор конкретной реплики делает Endpoint Picker, который получает метрики серверов модели. Среди сигналов для маршрутизации проект называет состояние prefix cache и наличие LoRA-адаптеров. Для продакшена документация предлагает готовый Endpoint Picker, например маршрутизатор llm-d.
В llm-d для точного режима каждый сервер vLLM запускается с --kv-events-config, где указаны издатель zmq, адрес и тема с IP и портом пода. Руководство перечисляет ограничения, о которых стоит знать заранее:
- одна реплика маршрутизатора — учёт нагрузки в
token-load-scorerлокален для процесса, и несколько активных маршрутизаторов видели бы только часть нагрузки; - индекс не отказоустойчив — маршрутизатор, запущенный позже реплик, не знает о префиксах, закэшированных до окна повтора событий;
- попадания не публикуются — vLLM сообщает о блоке, только когда вычисляет его заново, поэтому попадания в кэш индекс не обновляют;
- токенизация нагружает CPU реплик и конкурирует с обслуживанием.
Горячие точки и как их избежать
Маршрутизация по кэшу усиливает перекосы, если у трафика есть сильный общий префикс. Например, корпоративный ассистент с одним длинным системным промптом и десятками отделов: все запросы будут тянуться к реплике, где этот промпт уже лежит.
Что помогает:
- ограничивать долю нагрузки, которую может получить кэш-реплика, через параметры балансировки инструмента;
- добавлять случайность в выбор, как
--router-temperatureв Dynamo; - держать короткий общий префикс прогретым на всех репликах, а маршрутизировать по более длинной уникальной части — истории диалога или документам;
- проверять распределение запросов и загрузку по репликам в мониторинге, а не только суммарную пропускную способность.
Как измерить эффект
vLLM публикует счётчики, по которым видно, работает ли кэш. По списку метрик vllm:prefix_cache_queries считает запрошенные токены, а vllm:prefix_cache_hits — токены, найденные в кэше. Доля попаданий на реплике:
sum by (instance) (rate(vllm:prefix_cache_hits_total[10m]))
/
sum by (instance) (rate(vllm:prefix_cache_queries_total[10m]))
Суффикс _total в Prometheus может отличаться в зависимости от версии, проверьте вывод /metrics. Порядок эксперимента:
- Запишите базовую линию с текущим балансировщиком: долю попаданий, p50 и p95 времени до первого токена, загрузку каждой реплики.
- Подайте нагрузку, похожую на реальную: многоходовые диалоги с паузами, общие системные промпты, агентские цепочки. Методика описана в статье о нагрузочном тесте локальной LLM.
- Включите привязку к сессии и повторите тест.
- Включите маршрутизацию по кэшу и повторите тест.
- Сравните не только среднее время до первого токена, но и разброс загрузки между репликами и хвост задержки.
Когда это не нужно
- Одна реплика: маршрутизировать некуда, достаточно prefix caching в движке.
- Короткие независимые запросы без общей части: попаданий почти не будет.
- Длинные ответы при коротких промптах: узкое место в генерации, а не в prefill.
- Нет мониторинга: без метрик попаданий и загрузки вы не узнаете, помогла ли настройка.
Частые вопросы
Чем это отличается от выгрузки KV-кэша в общее хранилище? Маршрутизация отправляет запрос туда, где кэш уже есть. Общее хранилище позволяет реплике загрузить чужой кэш. Их можно сочетать; выгрузка разобрана в статье о выгрузке KV-кэша в RAM и на NVMe.
Хватит ли привязки к сессии в Nginx? Для чатов с длинной историей и десятков пользователей часто хватает. Точная маршрутизация окупается, когда реплик много, общих префиксов много, а нагрузка неравномерна.
Нужен ли Kubernetes? Для llm-d и Gateway API Inference Extension — да. SGLang Model Gateway и Dynamo можно запускать и вне Kubernetes.
Что делать при отказе реплики? Её сессии уйдут на другие реплики и пройдут prefill заново. Заложите это в запас мощности и проверьте сценарий отказа на тесте.
Как AI студия Владимира Ломтева помогает с маршрутизацией между репликами
AI студия Владимира Ломтева разворачивает LLM на серверах компании и интегрирует их с корпоративными системами. Для нескольких реплик это означает:
- оценить по метрикам, сколько prefill теряется из-за текущей балансировки;
- выбрать схему: привязку к сессии, маршрутизатор SGLang, llm-d или Dynamo — под ваш движок и инфраструктуру;
- провести сравнительный нагрузочный тест на реальных диалогах до и после изменения;
- настроить мониторинг попаданий в кэш и загрузки реплик.
Первый шаг — выбрать один сервис с несколькими репликами, записать текущее время до первого токена и долю попаданий в кэш и решить, какое улучшение будет считаться успехом. Обсудить задачу.
Итог: начните с привязки к сессии
Маршрутизация по KV-кэшу возвращает пользу prefix caching, которую разрушает круговой балансировщик. Начните с привязки диалога к реплике, измерьте долю попаданий и время до первого токена, и переходите к точной маршрутизации по событиям KV, когда реплик много, а общих префиксов и перекосов нагрузки достаточно, чтобы окупить дополнительную инфраструктуру.