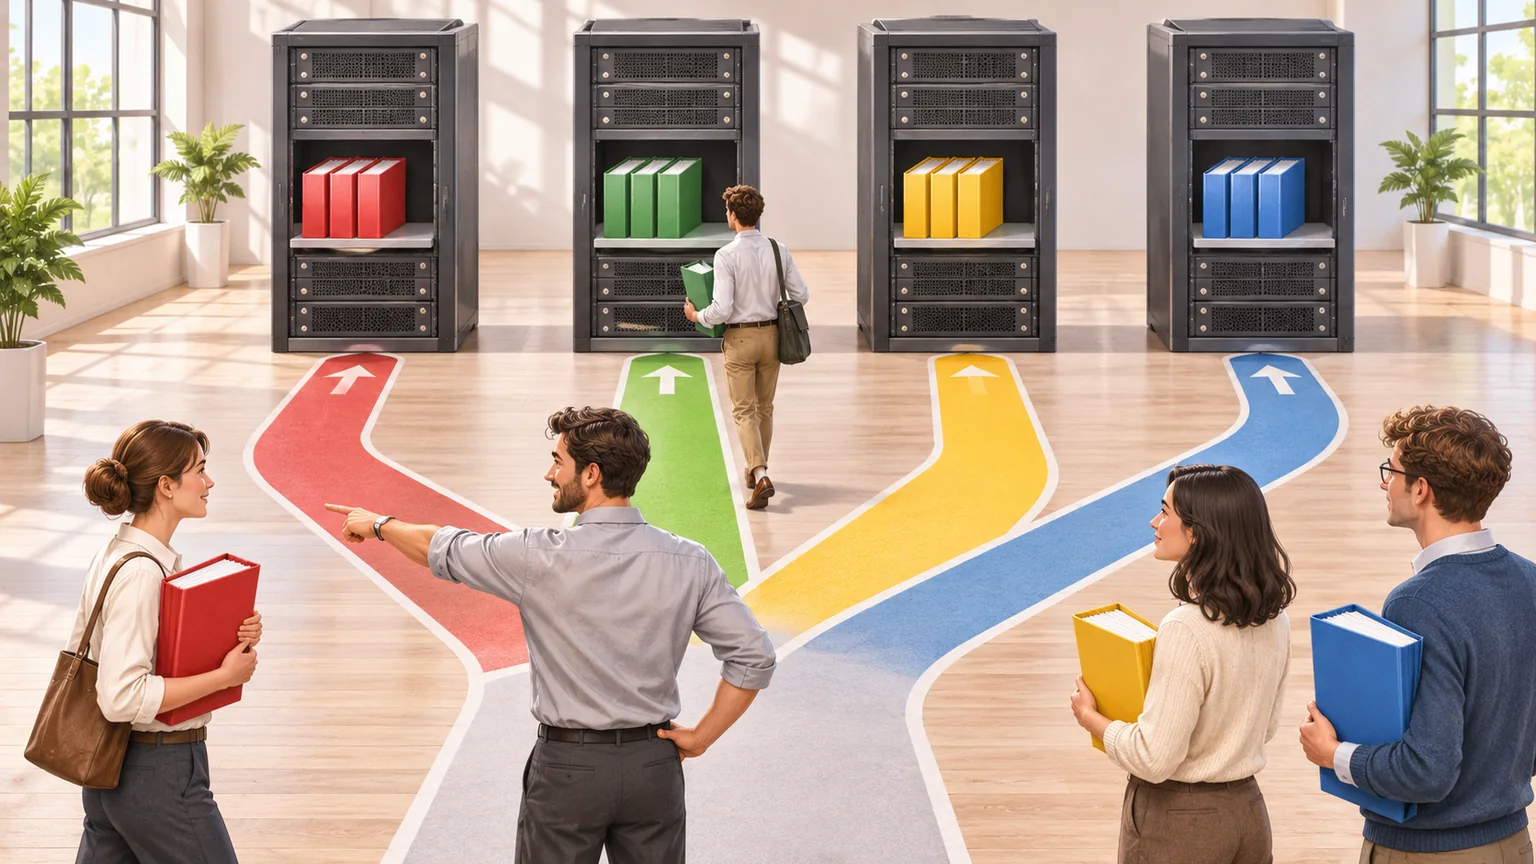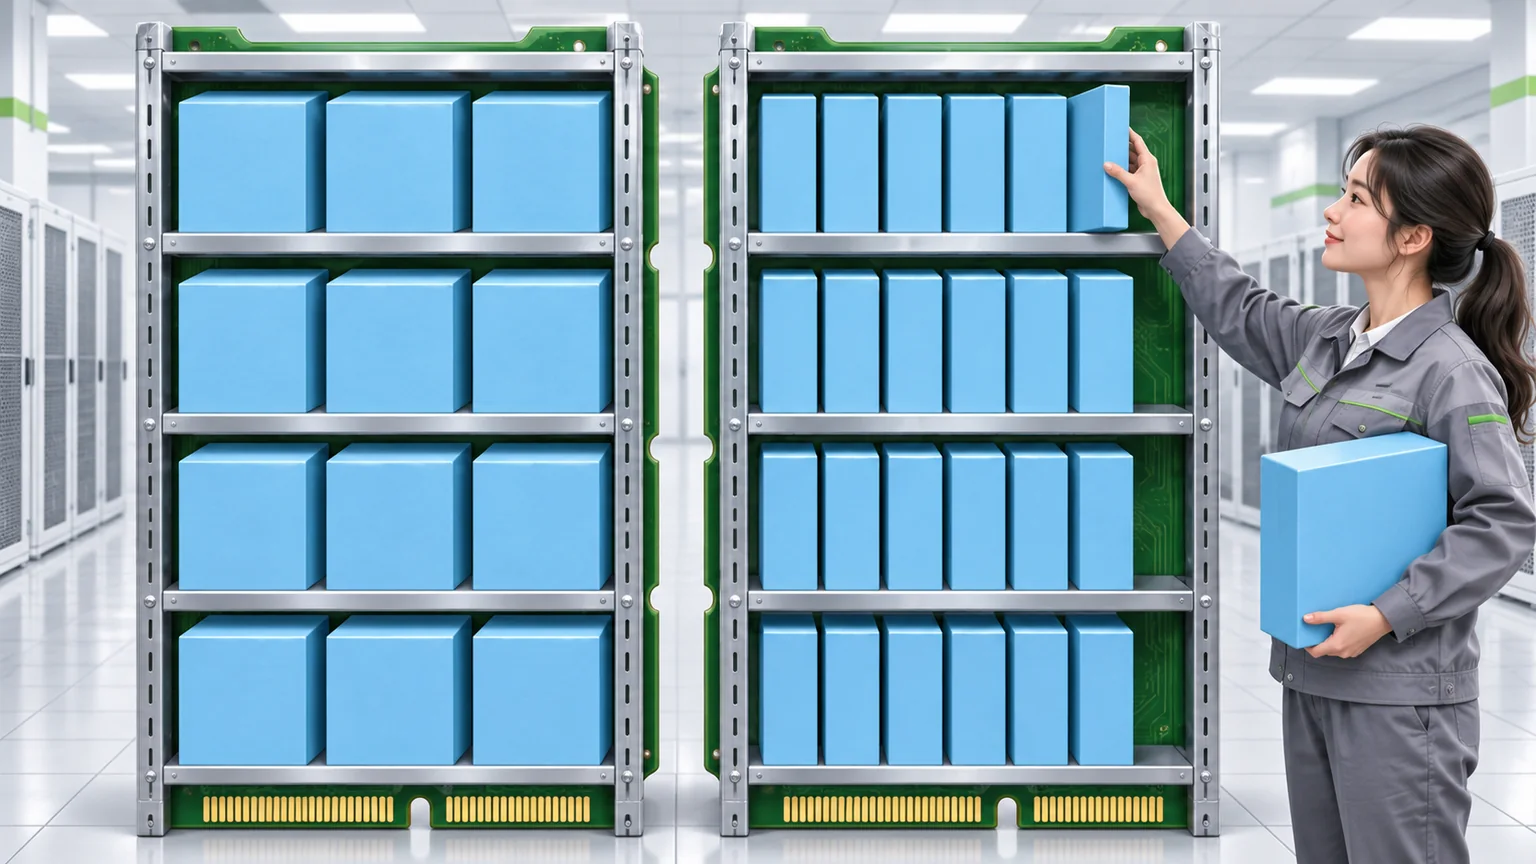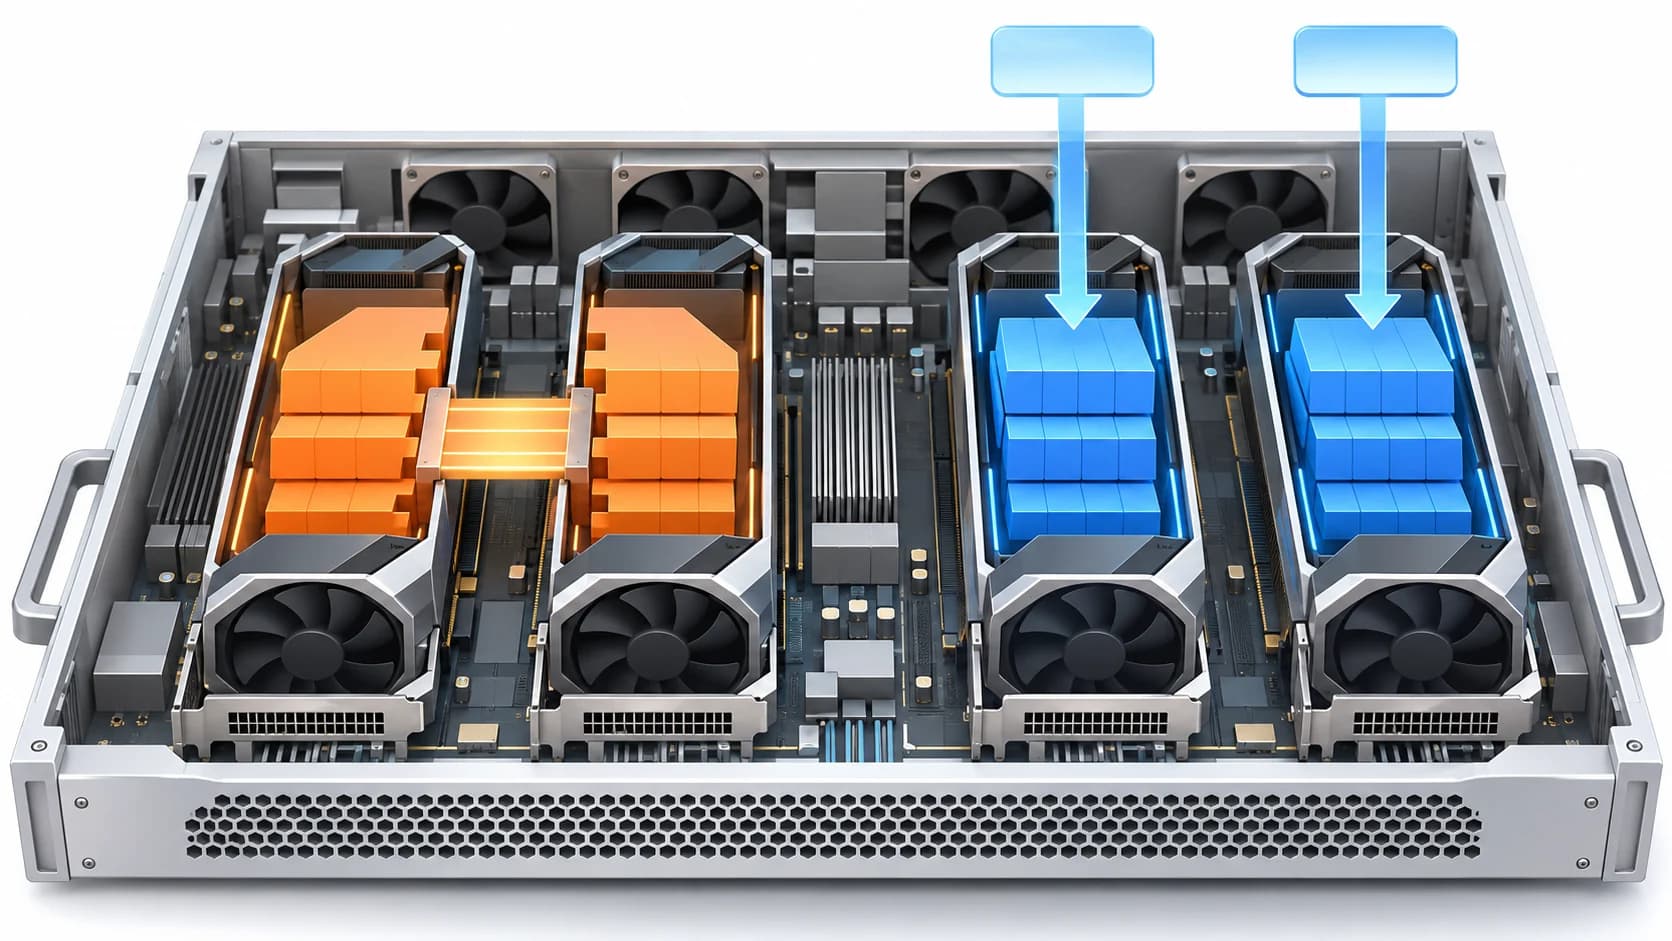
Несколько GPU используют по двум разным причинам: чтобы разместить одну модель или чтобы обслуживать больше независимых запросов. Для первой задачи исследуют разделение вычислений и слоёв, для второй — дополнительные экземпляры. Выбор влияет на память, обмен, задержку и восстановление, поэтому сумма VRAM и количество ускорителей не дают готового ответа.
Материал подготовила AI студия Владимира Ломтева 14 ноября 2026 года для разработчиков и команд инфраструктуры. Это порядок выбора и проверки схемы, основанный на документации движков. Собственные multi-GPU замеры не проводились, линейное ускорение не обещается. Примеры ограничены текстовыми LLM; конкретная поддержка модели и топологии проверяется в закреплённой версии runtime.
Содержание
- Сначала определить причину масштабирования
- Основные схемы
- Как работает tensor parallelism
- Когда нужны реплики
- Pipeline parallelism и его ограничения
- MoE и expert parallelism
- Почему важны NVLink, PCIe и сеть
- Как подготовить минимальный эксперимент
- Что измерять при сравнении схем
- Частые причины слабого масштабирования
- Восстановление и обновление
- Карточка выбора multi-GPU схемы
- Частые вопросы
Сначала определить причину масштабирования
Если веса и необходимое состояние не помещаются на одно устройство, нужно найти способ распределить исполнение или выбрать другой артефакт. Если модель помещается, но очередь слишком большая, задача может решаться дополнительными репликами. Если задержка вызвана внешним поиском, добавление GPU не устранит узкое место приложения.
Запишите, какое ограничение наблюдалось фактически: OOM, рост очереди, слишком долгий prefill или медленный decode. Привяжите его к длинам входа и выхода и согласованному SLO. Без этой исходной точки сложно понять, помогло ли усложнение архитектуры.
Общая карта подходов есть в руководстве vLLM Parallelism and Scaling. Документация описывает варианты, но не заменяет измерение вашей модели на выбранном межсоединении.
Основные схемы
| Схема | Что распределяется | Когда рассматривать |
|---|---|---|
| Tensor parallelism | Части операций и тензоров модели | Размещение и совместное исполнение одной копии |
| Pipeline parallelism | Стадии или группы слоёв | Разделение по устройствам или узлам при поддержке runtime |
| Независимые реплики | Полные копии модели | Рост общего объёма независимой работы |
| Expert parallelism | Эксперты MoE | Поддерживаемые MoE-архитектуры |
| Разделение фаз | Prefill и decode | Управление разными профилями нагрузки после измерений |
Эти способы могут сочетаться, но поддержка сочетаний зависит от движка. Не начинайте с максимально сложной комбинации. Сначала нужен понятный минимальный вариант, который можно воспроизвести и восстановить.
Как работает tensor parallelism
При tensor parallelism части вычислений одного слоя выполняются на нескольких ускорителях. Для получения согласованного результата устройства обмениваются данными. Поэтому характеристика межсоединения становится частью производительности, а не дополнительной деталью сервера.
Разделение может помочь разместить веса и обработать одну модель совместно. Но оно добавляет коммуникационные операции. Для небольшой модели, уже помещающейся на одном GPU, эти расходы могут оказаться заметными относительно полезной работы. Это гипотеза для проверки, а не универсальный запрет.
Память на каждом устройстве не обязательно равна общему размеру, делённому на число GPU. Возможны реплицируемые данные, особенности архитектуры и дополнительные буферы. Планируйте ресурс по оценкам runtime и фактическим пикам, а не только арифметике весов.
Когда нужны реплики
Реплика — отдельный экземпляр модели, принимающий свою работу. Если запросы независимы и модель помещается на устройство, реплики позволяют распределить поток. Входной маршрутизатор должен учитывать готовность, ограничения и очереди экземпляров.
Не считайте простое чередование адресов достаточным балансировщиком для любого сценария. Запросы разной длины могут создавать неравномерную работу. Повторяющийся контекст также может влиять на эффективность кэша и маршрутизации.
Отказ одной реплики требует правила для незавершённых операций. Повтор генерации может быть допустим, а повтор внешнего действия агента — создавать дубли. Обработка повторов и идентификаторы операций относятся к приложению, а не решаются автоматически дополнительной GPU-копией.
Pipeline parallelism и его ограничения
Pipeline parallelism распределяет последовательные стадии модели. Выход одной стадии передаётся следующей. При нескольких частях работы pipeline может перекрывать вычисления, но конкретная эффективность зависит от планирования и баланса стадий.
Если одна стадия значительно медленнее остальных, она ограничивает общий поток. Небольшое количество работы может не заполнять pipeline достаточно хорошо. Для каждой схемы измеряйте не только суммарную генерацию, но и задержку отдельного запроса.
Поддержка pipeline, комбинаций с tensor parallelism и multi-node запуска различается между runtime. Проверяйте документацию нужной версии и конкретной архитектуры. Ручное разнесение файлов модели по серверам не создаёт работающий pipeline.
MoE и expert parallelism
В MoE часть вычислений направляется выбранным экспертам. Число активируемых параметров помогает понимать вычислительный профиль, но не заменяет общий объём весов и требования к их размещению. При распределении экспертов появляется соответствующий обмен.
Не сравнивайте MoE и плотную модель только по числу активных параметров. Учитывайте архитектуру, шаблон запросов, размещение состояния и фактическую реализацию runtime. Технические особенности могут изменить баланс памяти и коммуникаций.
Сценарии expert parallelism и связанные настройки описываются в документации SGLang и соответствующих разделах выбранного движка. Для производственного решения фиксируйте конкретную поддерживаемую конфигурацию, а не только название механизма.
Почему важны NVLink, PCIe и сеть
Межсоединения отличаются по пропускной способности, задержке и топологии. Само наличие нескольких GPU не означает одинакового пути обмена между каждой парой. Результат зависит от конкретной платформы и настроек.
Для NVIDIA полезна первичная проверка:
nvidia-smi
nvidia-smi topo -m
Эти команды помогают увидеть устройства и топологию, но не заменяют тест коммуникаций. В распределённом окружении дополнительно проверяют сеть и поддерживаемые коллективные операции. Официальный набор NVIDIA NCCL tests может использоваться в подходящей разрешённой среде; параметры и интерпретацию выбирают по документации.
Сравнивайте планируемую схему с фактическим сервером. Два GPU на одной плате, несколько устройств в разных слотах и несколько сетевых узлов — разные конфигурации. Переносить цифры между ними без проверки нельзя.
Как подготовить минимальный эксперимент
Зафиксируйте одну модель и контрольный поток. Начните с базового режима, который уже работает. Если модель не помещается на одном GPU, база может быть другим допустимым вариантом размещения; это нужно явно раскрыть, а не изображать одинаковые условия.
Для проверки синтаксиса выбранного vLLM используйте:
vllm serve --helpФлаг --tensor-parallel-size относится к размеру соответствующего разделения. Его значение должно соответствовать доступным устройствам и поддерживаемой схеме. Конкретную команду формируют после выбора модели, контекста и образа; универсальная строка для любого multi-GPU сервера скрыла бы важные условия.
После запуска проверьте фактическое размещение и журналы. Затем выполните короткий запрос, длинный вход и несколько параллельных обращений. Не переходите сразу к максимальной нагрузке: сначала нужно подтвердить корректность маршрута.
Что измерять при сравнении схем
Для одинакового потока сохраните TTFT, полную задержку, выходной throughput, ошибки, память на каждом GPU и поведение очереди. Укажите количество клиентов, длины входов и выходов и правила кэша. Отдельно запишите стоимость выделенного ресурса в выбранной системе учёта.
Можно сравнить две схемы: одна копия модели на нескольких устройствах и несколько копий на доступных устройствах, если обе совместимы с артефактом. Цель — найти вариант, выполняющий задачу при заданном SLO. Не объявляйте победителя только по лучшей единичной генерации.
Для процедуры измерений используйте vLLM Benchmark CLI. Если меняется число экземпляров, убедитесь, что клиент действительно распределяет работу по ним и не упирается в один адрес или ограничение шлюза.
Частые причины слабого масштабирования
Небольшая нагрузка может не давать устройствам достаточно полезной работы. Длинные и короткие запросы в одном потоке способны создавать дисбаланс. Коммуникации могут занимать существенную часть шага. Также возможны неподходящий backend, неверная топология и недостаточная память на отдельном устройстве.
Отдельно проверьте клиентскую сторону. Если генератор отправляет один запрос и ждёт завершения, дополнительные реплики могут простаивать. Если балансировщик держит весь поток на одном экземпляре, панель общей доступной памяти не объяснит проблему.
Не исключайте качество из сравнения. Смена точности или формата ради размещения меняет условия. Артефакт, который стал удобнее распределять, должен заново пройти контрольные задачи. Базовые различия форматов разобраны в практической статье о квантовании.
Восстановление и обновление
У схемы с разделённой моделью отказ одного участника может затронуть всю соответствующую копию. У независимых реплик возможны другие границы отказа. Это нужно проверить в тестовой среде и учитывать при планировании доступности.
Опишите порядок выключения, перезапуска и возврата трафика. Готовность процесса и готовность модели — разные состояния. Если запросы начинают поступать до завершения загрузки, клиент увидит ошибки, даже когда все контейнеры формально запущены.
Для обновления сохраняйте совместимые артефакты и конфигурации. Контрольный набор и нагрузочный тест повторяют после существенной смены runtime, модели или топологии. Общий план системы вокруг модели показан в разборе собственной LLM в компании.
Карточка выбора multi-GPU схемы
Причина масштабирования и целевое SLO:
Модель, revision, формат:
Движок, версия, тип параллелизма:
Число GPU и топология обмена:
Память каждого устройства:
Вход, выход и частота запросов:
TTFT, полная задержка, throughput, ошибки:
Проверка качества:
Граница отказа и восстановление:
Стоимость ресурса и решение:
Скопируйте карточку для каждого кандидата. Если исходные условия различаются, внесите их в вывод. Это позволяет принять решение о конфигурации, а не спорить об абстрактной полезности нескольких GPU.
Механизмы, которые стоят за настройками сервера, разобраны в гиде по движкам и ускорению инференса. До выбора оборудования полезно пройти сравнение собственного инференса и API.
Частые вопросы
Два GPU всегда вдвое быстрее одного?
Нет. Результат зависит от разделения работы, межсоединения, модели и нагрузки. Возможны выигрыш, небольшой эффект или ухудшение выбранной метрики.
Можно ли складывать VRAM разных карт?
Только в смысле поддерживаемой схемы размещения, а не как универсальную общую память. Разный объём и скорость устройств могут создавать ограничения и дисбаланс.
Что выбрать для большого количества коротких запросов?
Если модель помещается, проверьте независимые реплики и распределение потока. Затем сравните их с разделённой копией по вашему SLO и качеству.
Когда нужен multi-node?
Когда задача действительно превышает возможности выбранного узла и поддерживаемый распределённый вариант проходит приёмку. Сеть и эксплуатационная сложность становятся отдельными частями решения.
Как AI студия Владимира Ломтева помогает выбрать размещение
AI студия Владимира Ломтева может связать развёртывание LLM с подготовкой данных, интеграцией и тестированием. Для масштабирования это означает описать рабочий поток, проверить подходящий вариант исполнения и согласовать критерий запуска в составе системы.
Первый шаг — определить один процесс, его текущую задержку, объём и ограничение, которое требуется снять. Обсудить задачу.
Как выбрать схему для нескольких GPU
Сначала определите, нужно ли разместить одну модель или увеличить объём независимой работы. Затем проверьте совместимость и топологию, измерьте задержку, память и ошибки на одинаковом потоке. Сохраните конфигурацию и процедуру восстановления: масштабирование должно улучшать управляемый рабочий сервис, а не только запускать больше устройств.