Классическое компьютерное зрение удобно для устойчивой задачи с формальным ответом: найти объект, измерить участок, посчитать пересечения линии. Мультимодальная LLM, или VLM, полезна, когда нужно задавать изображению разные вопросы, сопоставлять его с текстовой инструкцией и получать содержательный ответ. Для бизнеса выбор зависит от требуемого результата, времени на решение и цены ошибки. В одном процессе эти подходы можно объединить.
Материал подготовила AI студия Владимира Ломтева 10 ноября 2026 года для руководителей производства, логистики, розничных компаний и ИТ-команд. Сравниваем устройство решений по официальной документации, а не результаты собственного бенчмарка. Примеры ниже учебные: модели на фотографиях предприятия не запускались, точность, задержка и экономический эффект не измерялись.
Содержание
- Что называют классическим компьютерным зрением
- Что меняет компьютерное зрение через LLM
- Сравнение подходов для бизнеса
- Одна операция: проверка комплекта перед отправкой
- Какой подход подходит разным задачам
- Ограничения нового подхода, которые влияют на архитектуру
- Что происходит со стоимостью и данными
- Частые вопросы
Что называют классическим компьютерным зрением
Под словом «классическое» часто смешивают два подхода, которые стоит разделить.
Первый — обработка изображения по явно заданным правилам. Программа выделяет светлые и тёмные области, ищет контуры, проверяет положение и размеры. Например, при фиксированной камере и контрастном фоне можно проверять наличие отверстия в детали. В OpenCV доступны глобальная, адаптивная и автоматическая пороговая обработка по методу Оцу. Это конкретные операции над пикселями; смысл производственного требования задаёт разработчик. Руководство OpenCV.
Второй — специализированная обучаемая модель. Она получает изображение и возвращает результат заранее определённого типа:
- классификатор — метку изображения или вырезанного участка;
- детектор — рамки объектов, классы и оценки уверенности;
- модель сегментации — маски, то есть выделенные области изображения;
- трекер — связь обнаружений одного объекта между кадрами.
Так устроено разделение задач в документации Ultralytics: детекция, сегментация и трекинг. Для подсчёта проходящих коробок недостаточно получить рамки на отдельных кадрах: требуется связать наблюдения и определить событие пересечения.
Здесь «классический» означает специализированный процесс, а не обязательно устаревшую архитектуру. Современные детекторы используют в том числе трансформеры. Сравнение конкретных семейств вынесено в отдельный материал о YOLO, RT-DETR, RF-DETR и D-FINE. В этой статье выбираем уровень решения, а не победителя среди моделей детекции.
Что меняет компьютерное зрение через LLM
Текстовая LLM сама по себе не принимает пиксели. Для работы с изображением нужна мультимодальная модель и поддерживающий её интерфейс. Распространённое обозначение — VLM, vision-language model, модель, связывающая изображение и язык.
Пользователь передаёт фотографию вместе с вопросом: «Какие элементы комплекта видны?», «Чем эта выкладка отличается от инструкции?», «Что написано в указанном блоке?». Ответ формируется в контексте вопроса. В карточке Qwen3-VL описаны работа с изображениями и видео, распознавание текста и пространственная привязка объектов. Это заявленные возможности семейства, а не доказательство качества на конкретной линии или документе. Карточка Qwen3-VL-8B-Instruct.
Главное изменение для владельца процесса — часть требований можно выразить текстом. Вопрос «найди коробку» и вопрос «объясни, почему комплект не соответствует этой инструкции» требуют разного результата. VLM позволяет пробовать такие постановки без отдельного интерфейса для каждого вопроса. Однако изменение промпта ещё не подтверждает, что новая задача решается надёжно.
Выход не ограничен абзацем текста. Некоторые мультимодальные модели возвращают координаты и маски; например, такие режимы описаны в документации Gemini по изображениям. Поэтому противопоставление «детектор умеет находить, LLM умеет только говорить» неверно. Различаются способ задания задачи, ограничения конкретной реализации и свойства результата.
Сравнение подходов для бизнеса
| Критерий | Правила обработки изображения | Специализированная модель CV | Мультимодальная LLM / VLM |
|---|---|---|---|
| Как задают задачу | Порогами, геометрией, последовательностью операций | Типом модели, классами и обучающими примерами | Изображением, вопросом, инструкцией, иногда примерами |
| Типичный результат | Измерение, контур, условие «да/нет» | Метка, рамка, маска, траектория | Описание, извлечённые поля, ответ по инструкции; у части моделей — координаты и маски |
| Изменение требования | Перенастройка алгоритма | Проверка готовой модели, дообучение или смена модели | Изменение запроса и контекста, затем проверка новой постановки; иногда дообучение |
| Что нужно от данных | Управляемые условия съёмки и примеры границ правила | Репрезентативные изображения и подходящая разметка | Примеры для проверки, понятное требование; разметка для адаптации и оценки |
| Основная зона внимания | Чувствительность выбранных признаков к свету и положению | Перенос на новые объекты и условия, пропуски, дубли | Пропущенные детали, неподтверждённые выводы, зависимость ответа от инструкции |
| Развёртывание | Локальный процесс обработки | Локальный сервер, устройство у камеры или облачный сервис | Облачный API либо локальная мультимодальная модель; требования зависят от модели |
| Что считать успехом | Верное измерение или решение при заданных условиях | Корректные объекты и события с допустимой задержкой | Подтверждаемый изображением ответ, пригодный для конкретного действия |
Таблица — редакционное обобщение документации OpenCV, Ultralytics, Qwen и Gemini. Она не ранжирует точность или скорость: сопоставимых собственных измерений нет. Локальная VLM не становится автоматически приватной системой, а облачный детектор не становится автоматически быстрым. Эти свойства определяет весь путь данных, включая передачу, очередь, обработку и хранение.
Промежуточный вариант: поиск объектов по тексту
Между фиксированным списком классов и разговорной VLM есть открытая детекция, или open-vocabulary detection. Пользователь описывает, какие объекты искать, а модель возвращает их расположение. Пример — Grounding DINO, в котором детекция связана с языковым описанием.
Если требуется находить «красную коробку» или «человека в каске», такой инструмент стоит рассматривать отдельно от полноценного визуального собеседника. Поддержка текстового запроса не означает способность объяснить производственную ситуацию. И наоборот, связное объяснение VLM не подтверждает точность всех указанных координат.
Выбирать только между «старым YOLO» и «новой LLM» — слишком узкая постановка. Иногда задача решается правилами, иногда специализированной моделью, иногда детектором с текстовыми запросами.
Одна операция: проверка комплекта перед отправкой
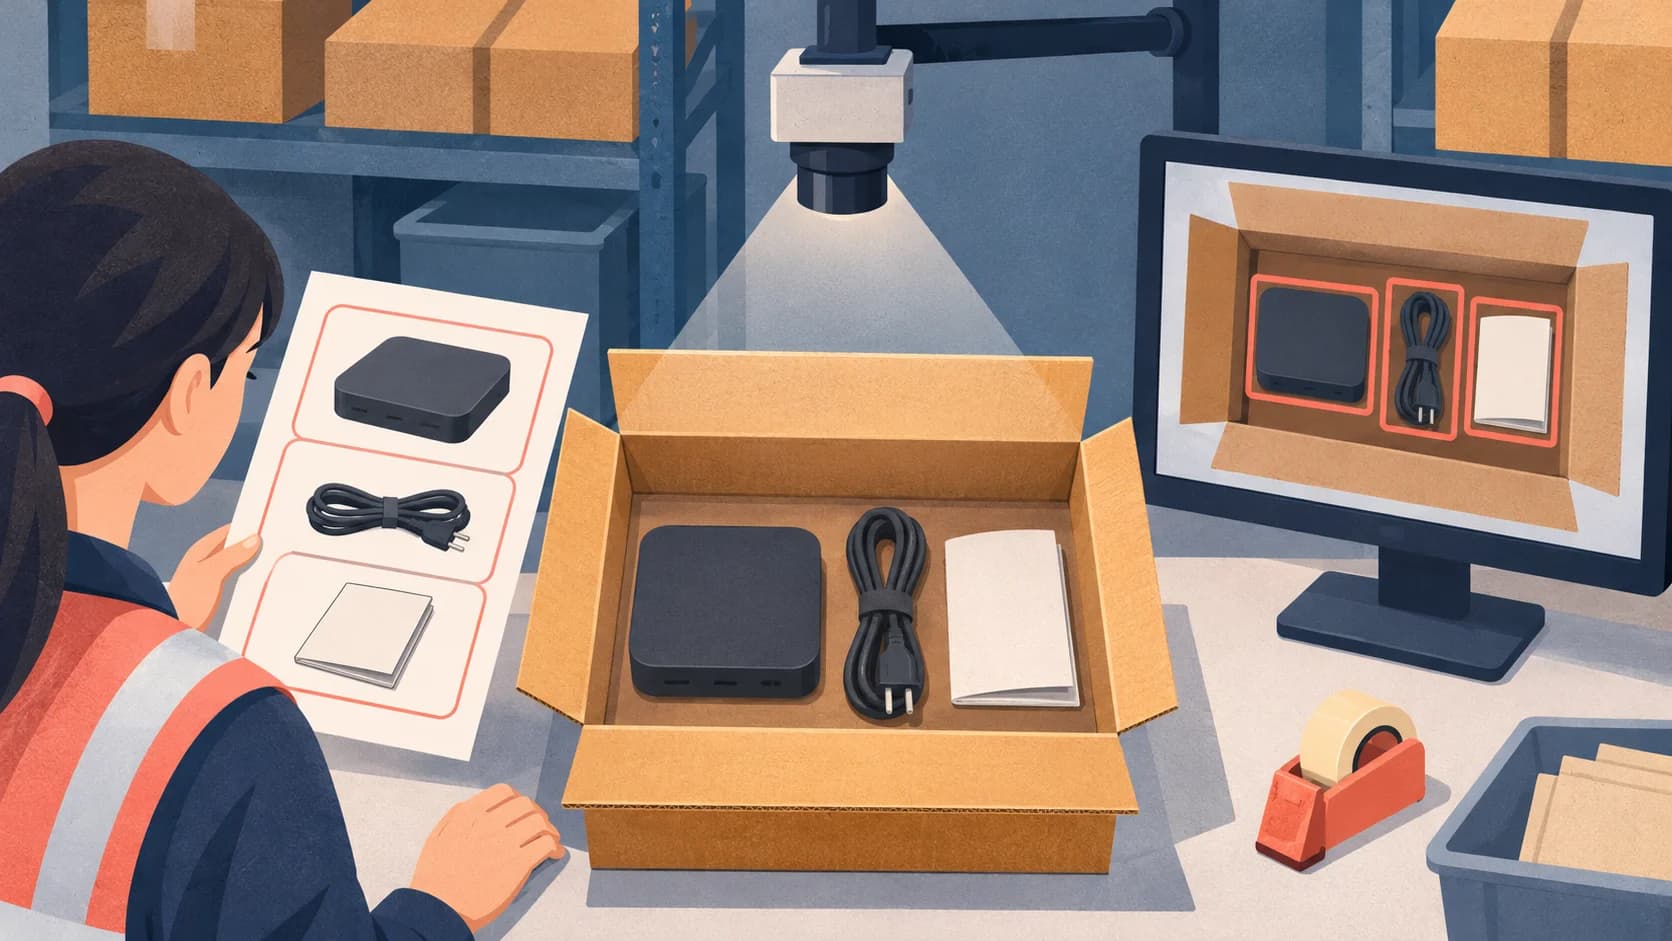
Рассмотрим учебный пример интернет-магазина: перед упаковкой нужно установить, лежат ли в коробке прибор, кабель и инструкция. Требования к разным товарам меняются, а фотографию сохраняют в карточке заказа. Это вымышленный процесс, не описание клиентского внедрения.
Вариант со специализированным зрением
Если комплектация стабильна, а камера видит содержимое сверху, детектор может искать заданные классы. Правило сверяет обнаруженные предметы с ожидаемым составом заказа. Для серийной операции выход понятен: объект найден, не найден или участок не позволяет принять решение.
Проблема появляется, если кабель скрыт под прибором. Отсутствие обнаружения может означать отсутствие предмета, перекрытие или ошибку модели. В таком процессе стоит изменить раскладку для съёмки либо направить случай на дополнительный осмотр. Ни смена архитектуры, ни более длинный запрос не сделают невидимую сторону коробки наблюдаемой.
Вариант с VLM
На вход можно передать фотографию и текст состава конкретного комплекта. Пример запроса для эксперимента:
Ожидаемый комплект: прибор, кабель питания, бумажная инструкция.
Опиши отдельно каждый ожидаемый предмет.
Для каждого выбери состояние:
«виден», «не обнаружен на изображении» или «нельзя определить».
Укажи видимый признак, на котором основан ответ.
Не считай отсутствие видимого предмета доказательством его отсутствия
в коробке. Не делай выводов о работоспособности прибора.
Этот промпт не проверен запуском модели. Его назначение — отделить видимое наблюдение от вывода о комплектности. Даже при соблюдении формата VLM может перепутать инструкцию с упаковочным листом или приписать объекту неразличимое свойство. Проверять нужно предметы и признаки, на которые ссылается ответ, а не только правильность оформления.
Преимущество такой постановки — возможность передать новую текстовую комплектацию. Ограничение — необходимость убедиться, что модель различает нужные предметы и корректно отказывается при плохой видимости. Гибкость формулировки не отменяет этой работы.
Гибридная схема
Для такого процесса можно предложить схему: камера и идентификатор заказа → выделение коробки и предметов → сверка с составом → VLM для неоднозначных случаев → решение оператора. Это проектный вариант, его эффективность здесь не измерена.
Детектор выполняет повторяющуюся работу с объектами. VLM получает исходный снимок, выбранные участки и описание комплекта, чтобы подготовить объяснение исключения. Правила проверяют структуру результата и соответствие заказу. Сотрудник рассматривает случаи, где изображение не даёт достаточного основания.
У гибрида есть собственный риск: если первый этап не заметил предмет и обрезал его, второй этап его тоже не увидит. Поэтому нельзя передавать только удачные обнаружения и считать их полным содержимым коробки. Возможность обратиться к исходному изображению и состояние «нельзя определить» должны быть предусмотрены в процессе.
Какой подход подходит разным задачам
| Задача читателя | Разумная отправная точка | Когда добавлять VLM |
|---|---|---|
| Проверить наличие контрастной метки в фиксированной области | Простое правило или классификатор | Когда требуется объяснять разнообразные исключения; сначала оценить, нужен ли этот слой |
| Локализовать известные дефекты на деталях | Детектор или сегментация с согласованными классами | Для описания спорных снимков и сопоставления с текстом инструкции |
| Считать коробки, проходящие через зону | Детекция, трекинг и правило события | Для разбора выбранных эпизодов, отдельно от основного счётчика |
| Ответить на разные вопросы по фото приёмки | VLM с ограниченной задачей и ручной проверкой | Это основная роль модели; точную геометрию можно вынести в отдельный инструмент |
| Найти объекты по меняющемуся текстовому описанию | Открытая детекция | Когда кроме расположения нужен содержательный ответ по сцене |
| Извлечь сведения из нестандартного документа | Сравнить OCR с обработкой текста и прямой VLM | Когда важны структура страницы, связь подписей, таблиц и изображений |
Это рекомендации по выбору кандидата, а не обещание качества. Для контроля качества на производстве отдельно важны свет, оптика и связь решения с конкретным изделием. Для распознавания документов — правильность полей, арифметика и сопоставление со справочниками. Хорошее общее описание фотографии не заменяет эти результаты.
Ограничения нового подхода, которые влияют на архитектуру
Правдоподобный ответ может содержать выдуманную деталь
VLM может назвать объект, которого нет на снимке. Работа POPE об объектных галлюцинациях посвящена оценке именно такого поведения у исследованных авторами моделей. Она не даёт частоту ошибок всех современных VLM и не позволяет перенести показатель на конкретное предприятие.
Практический вывод: ответ «нарушений нет» следует отличать от результата проверки каждого обязательного признака. При критичном пропуске нужно предусмотреть дополнительное основание для решения: другой ракурс, специализированный инструмент или осмотр человеком. Просьба «будь уверен» не добавляет информации в изображение.
Видео может анализироваться по выборке кадров
В документации Gemini статическая обработка видео по умолчанию описана как извлечение одного кадра в секунду, 1 FPS. Там же указано, что быстрые движения и смены сцен могут теряться между кадрами; существуют настройки частоты и отдельный агентный режим просмотра. Это свойства конкретного интерфейса, не универсальная частота всех VLM. Документация видеообработки Gemini.
Поэтому вопрос «сколько коробок прошло за смену» требует понимать, какие кадры действительно обработаны и как сохранялась идентичность объектов. Пересказ видео и непрерывный счётчик — разные выходы. Более подробный выбор способов просмотра разбирает статья об агентном анализе видео.
Слова и координаты требуют разных проверок
Детекторная рамка, маска дефекта и текст «повреждён верхний левый угол» описывают разные свойства. Если решение требует площади дефекта, нужно определить масштаб и способ измерения. Координаты из VLM тоже требуют проверки системы координат и соответствия изображению. Описание в миллиметрах без калибровки не становится измерением.
Аналогично, корректный JSON подтверждает структуру ответа, но не верность наблюдения. В процессе извлечения данных полезно разделить синтаксическую проверку, проверку допустимых значений и фактическое сопоставление с изображением.
Что происходит со стоимостью и данными
У специализированного решения затраты могут включать съёмку, разметку, обучение и обслуживание. У VLM остаются подготовка изображений и проверка качества; добавляются особенности мультимодальных запросов, контекста, повторов и выбранного размещения. Документация Gemini отдельно описывает передачу изображений и их токенизацию: разрешение и способ обработки влияют на объём входа. Это не готовая оценка счёта для другого сервиса или локальной модели. Работа с изображениями в Gemini.
При массовом потоке полезно сравнивать стоимость завершённой операции: получение кадра, обработку, доработку исключения и исправление ошибки. Дешёвый запрос с большим числом ручных исправлений может дать дорогой процесс. Напротив, дорогая обработка редкого сложного снимка может быть оправдана. Это экономическая логика выбора, а не рассчитанная окупаемость.
Разметка тоже остаётся нужна. Для готовой VLM можно начать без обучения на собственных данных, но нужны изображения с правильными ответами, чтобы оценить пригодность. Для специализированного обучения потребуются метки соответствующего типа. Порядок их подготовки вынесен в инструкцию по разметке данных для компьютерного зрения.
Фотографии сотрудников, клиентов, документов и производственных объектов требуют отдельно определить разрешённый маршрут обработки и доступ. Локальный запуск — способ размещения вычислений; его одного недостаточно, чтобы установить правила хранения, доступа и передачи снимков.
Частые вопросы
Заменят ли LLM обычное компьютерное зрение?
Для всех задач такого вывода нет. Мультимодальные модели расширяют набор вопросов к изображению. Формальные измерения, стабильные массовые события и специализированные датчики сохраняют самостоятельную роль. Выбор делают по требуемому выходу и условиям процесса.
Можно ли обойтись одним промптом без обучения?
Можно попробовать готовую VLM на новой задаче без дообучения. Но промпт не доказывает качество. Для вывода о пригодности нужны примеры с известными ответами, включая перекрытые объекты, плохое освещение и неоднозначные случаи.
VLM обязательно работает в облаке?
Нет. Существуют модели с опубликованными весами, например Qwen3-VL. Возможность локального запуска, требования к оборудованию и допустимое использование проверяют для выбранной версии и программной среды. Открытые веса не означают отсутствие расходов и ограничений.
Что выбрать, если у нас уже работает детектор?
Найдите конкретный неудовлетворённый запрос: объяснение исключений, меняющийся состав комплекта, сопоставление снимка с инструкцией. Если он есть, можно рассмотреть VLM как дополнительный слой. Сам факт появления новой модели не даёт основания заменять работающий счётчик или измеритель.
Как AI студия Владимира Ломтева помогает выбрать архитектуру зрения
AI студия Владимира Ломтева занимается решениями компьютерного зрения и подготовкой данных для автоматизации. Для рассматриваемой задачи работа может включать подготовку изображений и требований к результату, разработку и тестирование выбранной схемы, интеграцию результата с учётной системой или рабочим местом оператора.
Первый шаг — выбрать одну операцию, описать текущий порядок её выполнения, доступные снимки и критерий приемлемого результата. Для проверки комплекта это может быть решение по составу заказа с отдельным маршрутом для случаев, где содержимое не видно. Обсудить задачу.
Итог: выбирайте по требуемому результату
Если нужен формальный сигнал на повторяющейся операции, начните с правил или специализированного компьютерного зрения. Если нужен гибкий ответ по изображению и текстовой инструкции, рассмотрите VLM. Если в одном процессе есть оба требования, разделите функции между инструментами и предусмотрите работу с недостаточными данными.
Для первого обсуждения достаточно сформулировать результат одной операции: рамка дефекта, число пересечений, набор полей или объяснение несоответствия. Такая формулировка помогает сравнивать архитектуры по полезному действию и не путать выразительный ответ с надёжным измерением.