Чтобы подготовить эталон для ИИ-классификатора обращений, создайте в Label Studio проект с текстом и выбором одной категории, импортируйте задачи, разметьте их по общей инструкции и выгрузите результат в JSON. Эталон здесь означает согласованную человеческую разметку: ответ языковой модели нельзя автоматически считать правильной меткой.
Инструкция предназначена руководителю поддержки и аналитику, которые хотят различать причины обращений, а затем обучать или проверять классификатор. Порядок работы основан на официальной документации, сверенной 4 ноября 2026 года. Интерфейс Label Studio и обучение модели в этой работе не запускались. JSON и XML ниже — предлагаемые учебные входные данные, а не выгрузка действующего проекта.
Содержание
- Исходные условия: что подготовить до импорта
- Шаг 1. Опишите категории через решения поддержки
- Шаг 2. Подготовьте JSON с устойчивыми идентификаторами
- Шаг 3. Настройте текст и одиночный выбор категории
- Шаг 4. Импортируйте задачи и разметьте пробную партию
- Шаг 5. Разберите разногласия до большой партии
- Шаг 6. Выгрузите JSON и найдите выбранные значения
- Типичные ошибки и их исправление
Исходные условия: что подготовить до импорта
Нужен доступный проект Label Studio с правом менять конфигурацию и импортировать задачи. Установка сервера, настройка доступа и выбор редакции находятся за рамками инструкции. Для первого прохода используйте вымышленные тексты; реальные обращения загружайте только в согласованную среду с разрешённым составом данных.
Выберите единицу разметки. В примере это одно обращение целиком, а не отдельное предложение и не вся история клиента. Для каждой записи сохраните внутренний идентификатор, исходный текст и версию правил. Так после экспорта можно связать категорию с нужной записью, не сопоставляя тексты по сходству.
Результат этапа — однозначный ответ на вопрос: «Что именно размечает человек?» Если два сообщения одного диалога требуют общей истории, сначала объедините их по принятому правилу. Не поручайте разметчику самостоятельно угадывать недостающий контекст.
Шаг 1. Опишите категории через решения поддержки
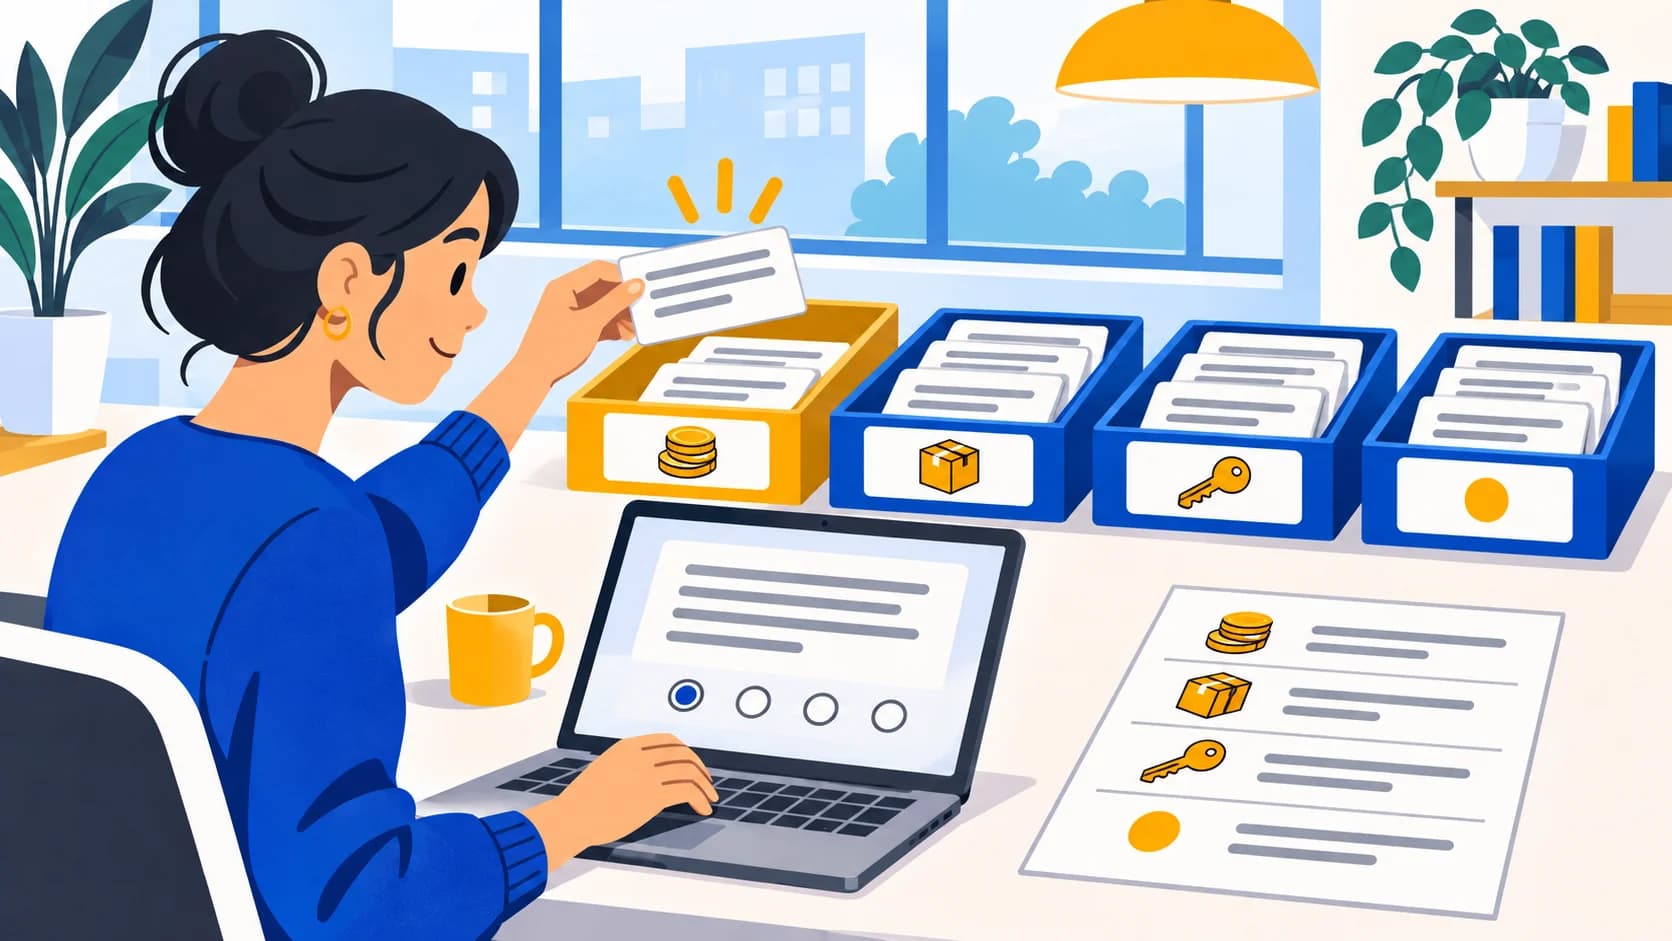
Для примера используем «Оплата», «Доставка», «Доступ» и «Другое». Это предложенная схема, которую нужно адаптировать. Категории должны помогать дальнейшему действию: маршрутизации или анализу причин, а не просто отражать часто встречающиеся слова.
| Категория | Когда выбирать | Пример |
|---|---|---|
| Оплата | Проблема со списанием или возвратом | «Оплату списали повторно» |
| Доставка | Проблема со сроком или получением | «Посылка не пришла» |
| Доступ | Не удаётся войти или пользоваться учётной записью | «Не приходит код входа» |
| Другое | Ни одно правило не подходит | «Хочу предложить сотрудничество» |
Добавьте правило для пересечений. Например, «После оплаты не могу войти» относим к «Доступу», если требуется восстановить вход, а не исправить платёж. Это редакционное решение владельца процесса, а не функция Label Studio.
Результат — инструкция с положительными и пограничными примерами. Если один текст закономерно требует нескольких независимых причин, пересмотрите постановку: одиночный выбор не подходит для многометочной задачи.
Шаг 2. Подготовьте JSON с устойчивыми идентификаторами
Сохраните следующий учебный список в файл tickets.json в UTF-8:
[
  {"data": {"ticket_id": "DEMO-A", "text": "Оплату списали повторно"}},
  {"data": {"ticket_id": "DEMO-B", "text": "Не приходит код входа"}},
  {"data": {"ticket_id": "DEMO-C", "text": "Посылка не пришла"}}
]
В формате импорта Label Studio ключи объекта data связываются с полями конфигурации. В нашем примере текст находится в text; ticket_id нужен для последующей связи с исходной системой. Не используйте текст обращения как единственный идентификатор: одинаковые формулировки встречаются в разных записях.
Результат этапа — корректный список задач с непустыми текстами и разными идентификаторами. До импорта проверьте, что файл не содержит контактов, подписей и вложений, которые не нужны разметчику. Для отдельной задачи очистки данных пригодится FAQ о Presidio перед LLM; он не заменяет правила доступа к системе разметки.
Шаг 3. Настройте текст и одиночный выбор категории
Откройте настройки проекта и раздел Labeling Interface, затем режим Code. Предлагаемая конфигурация:
<View>
  <Text name="ticket" value="$text"/>
  <Choices name="category" toName="ticket" choice="single" required="true">
    <Choice value="Оплата"/>
    <Choice value="Доставка"/>
    <Choice value="Доступ"/>
    <Choice value="Другое"/>
  </Choices>
</View>
$text указывает на поле входной записи. toName="ticket" связывает выбор с объектом Text, а name="category" задаёт имя управляющего элемента. Тип single ограничивает выбор одной категорией; required требует выбора перед сохранением. Эти параметры описаны в документации Choices.
Сохраните конфигурацию. До массовой работы откройте пробную задачу и убедитесь, что виден исходный текст и доступен нужный набор категорий. Пустой текст часто означает несоответствие имени поля и value, а не отсутствие задач.
Результат — сохранённая конфигурация с проверенной привязкой. При изменении существующего проекта учитывайте ограничения на изменение меток, уже используемых в аннотациях; они описаны в настройке интерфейса разметки. Для новой схемы безопаснее заранее продумать версионирование и перенос результатов.
Шаг 4. Импортируйте задачи и разметьте пробную партию
В проекте откройте Import, выберите tickets.json и завершите импорт по подсказкам интерфейса. Затем откройте задачу, выберите категорию и сохраните аннотацию кнопкой Submit. Базовый порядок работы описан в руководстве по разметке.
Для учебного набора ожидаются «Оплата», «Доступ» и «Доставка». Это ожидаемые ответы по предложенным выше правилам, а не измеренное качество разметчиков. Проверьте также отсутствие ответа: обязательный выбор должен мешать случайному сохранению пустой категории.
Результат — несколько завершённых задач, у которых сохранена категория. Если интерфейс позволяет выбрать ответ, но выгрузка его не содержит, разберите сохранение аннотации отдельно: видимая отметка в открытой задаче ещё не доказывает завершённую запись.
Шаг 5. Разберите разногласия до большой партии
Предлагаемый рабочий порядок — дать одну пробную подборку двум людям независимо и сравнить ответы вне системы, если нужные функции согласия недоступны в вашей редакции. Не предполагайте, что любой тариф автоматически предоставляет консенсус, автоматическое назначение и все метрики качества.
Разберите каждый тип расхождений. Разное понимание «Другое» исправляется уточнением правил. Недостающий контекст — изменением входных данных. Две одновременно правильные категории — пересмотром одиночной классификации либо правилом выбора основной причины.
Результат — согласованная версия инструкции и перечень записей, которые нужно пересмотреть. Не исправляйте только метки, оставляя двусмысленное правило: следующий разметчик воспроизведёт ту же ошибку.
Шаг 6. Выгрузите JSON и найдите выбранные значения
Откройте Export и выберите JSON. Сохраните исходную выгрузку целиком: она нужна для проверки структуры и происхождения аннотаций. В описании экспорта различаются данные задачи и результаты аннотаций.
Для данной схемы ищите нужный элемент внутри annotations[].result[]: from_name должен соответствовать category, to_name — ticket, тип — choices, а выбранные значения находятся в value.choices. Структура показана также в официальном разборе формата JSON. Проверьте структуру на реально выгруженном файле вашей версии. Не принимайте первый попавшийся элемент result за категорию: в проекте могут появиться дополнительные управляющие элементы.
При экспорте через интерфейс Community Edition в результат могут попадать и отменённые аннотации; фильтры вкладки не ограничивают такую выгрузку. Это отдельно оговорено в документации экспорта. Поэтому явно определите, какие записи считать завершёнными и допускать к эталону.
Результат — таблица «идентификатор обращения → категория» с сохранённой связью с исходной аннотацией. Если у задачи несколько аннотаций, сначала примените согласованное правило выбора окончательного ответа. Произвольный первый ответ не становится эталоном только из-за своего положения в массиве.
Типичные ошибки и их исправление
| Симптом | Что проверить | Исправление |
|---|---|---|
| В задаче пустой экран текста | Ключ data.text и $text |
Согласовать имя поля |
| Категории выбраны, но результаты не найдены | Сохранение и структура annotations |
Экспортировать завершённую аннотацию и проверить её |
| «Другое» поглощает почти всё | Границы категорий | Добавить понятные правила и примеры |
| Один и тот же текст получает разные метки | Контекст и приоритеты | Разобрать причину расхождения, обновить инструкцию |
Для обучения и проверки модели разделите данные до настройки классификатора и не используйте контрольные ответы для подбора промпта. Эта инструкция создаёт человеческую разметку; автоматическая пакетная разметка Mistral решает другой этап и требует отдельной оценки ошибок.
Как AI студия Владимира Ломтева помогает собрать эталон обращений
AI студия Владимира Ломтева занимается подготовкой данных, интеграцией ИИ с бизнес-системами и тестированием. В этой задаче работа может включать описание категорий и полей, связывание выгрузки с исходными обращениями и сравнение ответов классификатора с согласованной разметкой.
Первый шаг — выбрать один процесс маршрутизации, описать текущий порядок, источники обращений, ограничения доступа и критерий правильной категории. Конкретную схему разметки нужно согласовать до масштабирования; качество будущей модели не гарантируется одним выбором инструмента.
Итог: что должно получиться
Готовый результат — исходные тексты с устойчивыми идентификаторами, версия правил и согласованные категории, которые действительно находятся в выгрузке. Начните с учебного набора, проверьте привязку полей и сохранение аннотаций, затем разберите пограничные случаи. После этого можно расширять разметку и отдельно оценивать ИИ-классификатор на отложенных данных.