Чтобы оценить ИИ, который ищет редкие важные заявки, считайте отдельно найденные события, пропуски и ложные тревоги. Precision показывает, какая доля срабатываний верна, recall — какую долю настоящих событий удалось найти. F1 объединяет эти две величины, но не учитывает стоимость ошибок. Высокая accuracy сама по себе не доказывает, что редкие события обнаруживаются.
Этот FAQ — для руководителя поддержки, аналитика и разработчика, которые выбирают метрику классификатора обращений. Вопросы связаны одной задачей: выделить сообщения, требующие срочного разбора, из обычного потока. Материал подготовлен по официальной документации scikit-learn, проверенной 5 ноября 2026 года. Все числа ниже — вымышленные учебные примеры и арифметические расчёты, а не результаты внедрения. Обучение модели и подбор порога на реальных заявках в рамках статьи не выполнялись.
Содержание
- Почему 99% accuracy могут означать бесполезную модель?
- Что означают TP, FP, FN и TN в обращениях?
- Как посчитать precision и recall на одном примере?
- Когда нужен F1 и чего он не показывает?
- Что выбрать: macro, micro или weighted F1?
- Как порог меняет пропуски и ложные тревоги?
- Заменяет ли average precision выбранный рабочий порог?
- Какие данные запросить, чтобы пересчитать отчёт?
Почему 99% accuracy могут означать бесполезную модель?
Если из 1000 обращений только 10 срочные, алгоритм «всегда обычное» правильно назовёт 990 обращений. Его accuracy равна 990 / 1000 = 99%, хотя он пропустит все срочные сообщения. Это следствие состава выборки, а не доказательство качества распознавания.
Accuracy — доля всех верных ответов. Она полезна как общий показатель, но при редком целевом событии необходимо смотреть ошибки именно по этому событию. В документации scikit-learn о метриках классификации отдельно описаны accuracy, матрица ошибок и показатели по классам.
Практический вопрос к отчёту: сколько настоящих срочных заявок было в проверочном наборе и сколько из них модель нашла? Если в отчёте есть только общий процент правильных ответов, на этот вопрос он не отвечает. Не выбирайте модель лишь потому, что её accuracy выше на несколько пунктов: сначала сопоставьте ошибки по важному классу.
Что означают TP, FP, FN и TN в обращениях?
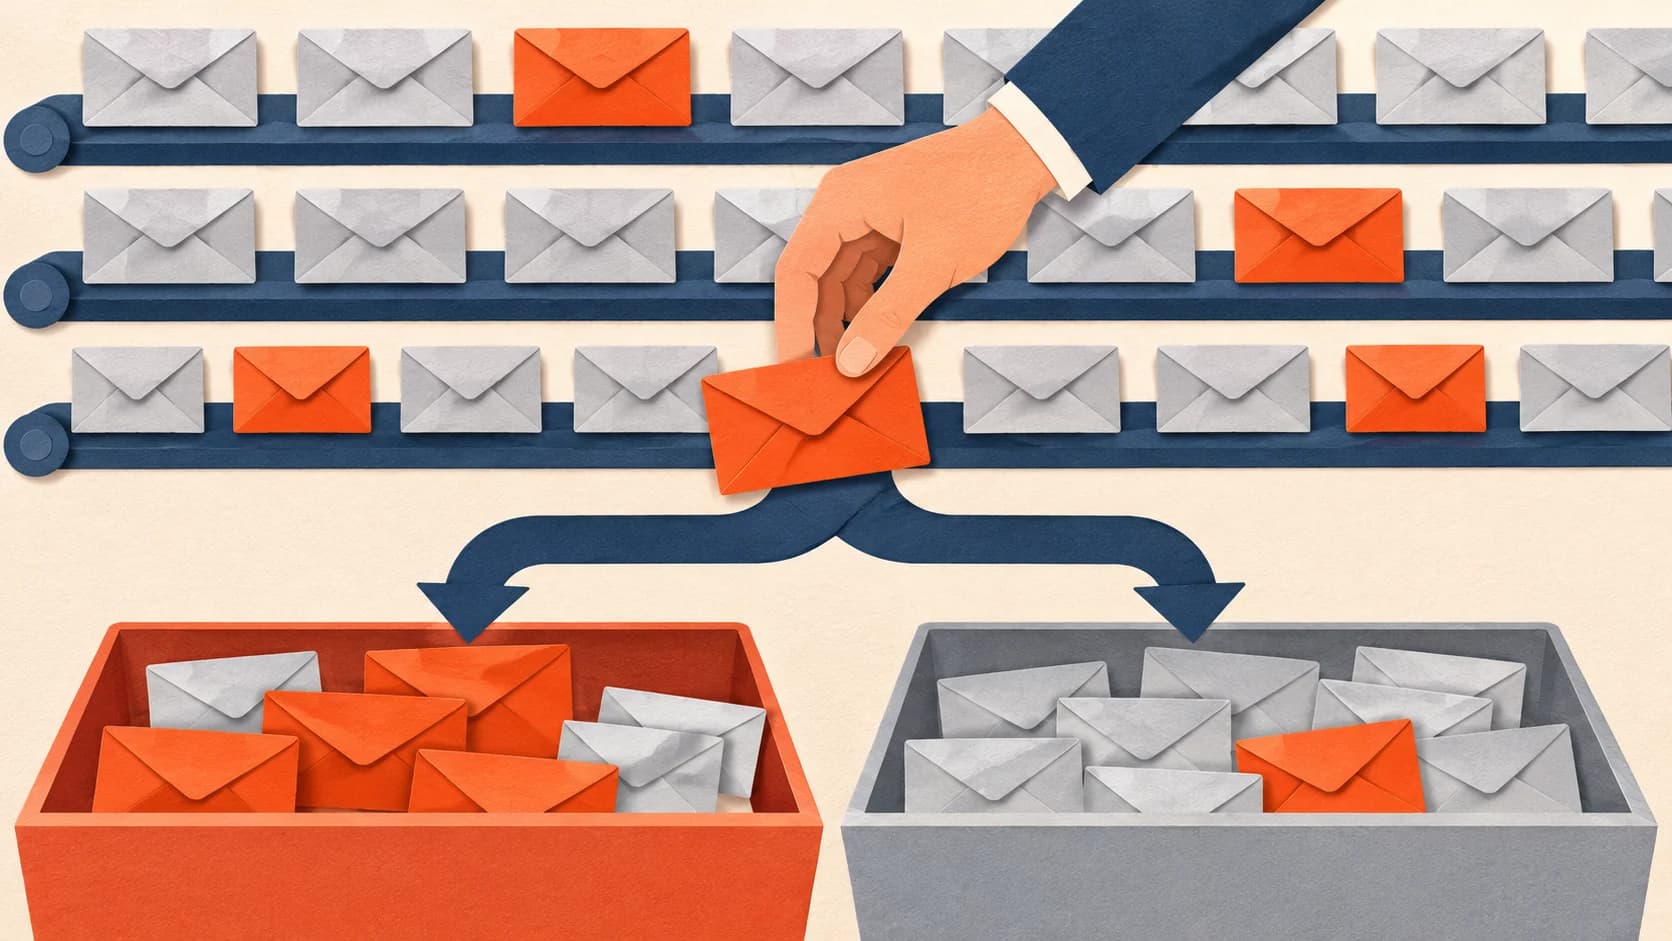
Сначала определите положительный класс. Здесь это «срочное обращение», а не «положительный отзыв». Затем сопоставьте прогноз с эталонной человеческой категорией для каждой заявки.
| Обозначение | Что произошло | Пример |
|---|---|---|
| TP | Срочное обращение найдено | Сообщение о полной остановке сервиса направлено дежурному |
| FP | Обычное обращение названо срочным | Вопрос о настройке попал в срочную очередь |
| FN | Срочное обращение пропущено | Остановка сервиса осталась в обычной очереди |
| TN | Обычное обращение распознано верно | Вопрос о настройке остался в обычной очереди |
В терминах precision_score ложная тревога увеличивает знаменатель precision. В терминах recall_score пропуск увеличивает знаменатель recall. Это разные ошибки и разные вопросы к процессу.
Убедитесь, что эталон и прогноз соединяются по одному идентификатору заявки. Если строки случайно переставлены, числа останутся вычислимыми, но описывать работу классификатора перестанут. Для подготовки человеческих категорий пригодится отдельная инструкция по разметке обращений в Label Studio.
Как посчитать precision и recall на одном примере?
Пусть модель отметила как срочные 20 обращений. Из них 8 действительно срочные, а 12 обычные. В проверочном наборе всего 10 настоящих срочных обращений: два из них модель пропустила. Получаем TP = 8, FP = 12, FN = 2.
- Precision = TP / (TP + FP) = 8 / 20 = 40%.
- Recall = TP / (TP + FN) = 8 / 10 = 80%.
- Нагрузка на срочную очередь в этом примере — 20 обращений, включая 12 ложных тревог.
Precision отвечает руководителю очереди: «Насколько можно доверять срабатываниям?» Recall отвечает владельцу процесса: «Сколько нужных случаев мы теряем?» Знаменатели различаются: у precision это все срабатывания, у recall — все настоящие события. Нельзя сообщать просто «точность 80%», если непонятно, какую величину посчитали.
Если модель никого не назвала срочным, precision имеет нулевой знаменатель. Если в наборе вообще нет срочных обращений, такой знаменатель возникает у recall. scikit-learn предоставляет параметр zero_division; его поведение описано в ссылках выше. В отчёте сохраняйте также абсолютные количества: ноль найденных событий и отсутствие событий в наборе требуют разных выводов.
Когда нужен F1 и чего он не показывает?
F1 — гармоническое среднее precision и recall. Его удобно использовать для сводного сравнения, когда обе стороны важны и выбран именно такой компромисс. По определению f1_score, F1 = 2TP / (2TP + FP + FN).
В нашем примере F1 = 16 / (16 + 12 + 2) = 16 / 30, то есть примерно 53,3%. Простое среднее 40% и 80% составило бы 60%, поэтому подменять одну формулу другой нельзя.
Однако F1 не знает, что для компании опаснее: пропущенная остановка сервиса или лишнее уведомление дежурному. Он также не включает TN в формулу. Два решения с близким F1 могут создавать разную нагрузку на сотрудников. Показывайте рядом precision, recall, FP и FN, а не оставляйте один агрегат.
Для автоматического назначения срочности можно задать минимально допустимый recall и отдельно ограничить число ложных тревог. Это пример постановки задачи, а не универсальная норма. Конкретные границы определяет владелец процесса с учётом последствий пропуска и доступной мощности команды.
Что выбрать: macro, micro или weighted F1?
При нескольких категориях сначала посмотрите показатели каждой категории и её support — число эталонных примеров. Затем выбирайте способ усреднения. Определения и формат таблицы приведены в classification_report.
Macro считает среднее показателей классов с равным весом. Поэтому редкая категория не исчезает из среднего только из-за своего небольшого размера. Weighted взвешивает показатели числом эталонных примеров класса: многочисленная обычная категория сильнее влияет на результат. Micro сначала суммирует ошибки по классам и затем вычисляет метрику.
В обычной многоклассовой классификации с одной меткой на объект и учётом всех классов micro F1 совпадает с accuracy. Это свойство не следует переносить без проверки на многометочную задачу или расчёт лишь по выбранным категориям.
Если цель — не потерять редкие срочные обращения, одного weighted F1 недостаточно. Запросите отдельную строку срочного класса, support и матрицу ошибок. Macro помогает сравнивать классы равноправно, но тоже не заменяет разбор того, какой именно класс просел и сколько примеров за ним стоит.
Как порог меняет пропуски и ложные тревоги?
Порог превращает числовой score модели в решение. Например, «считать срочным при score не ниже 0,7». Здесь 0,7 — условное значение для объяснения, а не рекомендуемая настройка. Score не обязательно является откалиброванной вероятностью: число 0,7 само по себе не означает 70% верных решений.
При неизменных оценках снижение порога расширяет множество срабатываний и не уменьшает recall. Ложных тревог при этом может стать больше. Precision не обязана меняться строго монотонно: она зависит от того, какие объекты добавились в срабатывания. Официальное руководство по настройке порога классификации разделяет обучение оценок и выбор решения на их основе.
Предлагаемый порядок работы: сохраните оценки и эталонные категории на валидационном наборе, сравните несколько порогов по TP, FP и FN, выберите допустимый режим и один раз оцените его на отдельном тестовом наборе. Не подбирайте порог по тесту, который затем используете как независимое доказательство качества.
Если модель выдаёт только текстовую категорию, для такой настройки нужен осмысленный числовой сигнал. Просьба к LLM написать «уверенность от 0 до 1» сама по себе не делает этот сигнал пригодным для выбора порога. Не переносите автоматически порядок работы вероятностного классификатора на произвольную самооценку языковой модели.
Заменяет ли average precision выбранный рабочий порог?
Нет. Average precision, или AP, обобщает показатели precision–recall по разным порогам. Это характеристика ранжирования на конкретном размеченном наборе. Рабочее приложение всё равно должно решить, какие обращения направлять в срочную очередь.
В average_precision_score AP определяется как взвешенная сумма precision, где весом служит прирост recall. Документация отдельно отмечает отличие этого расчёта от площади, полученной трапецеидальной интерполяцией. Поэтому в отчёте называйте конкретную метрику и функцию, а не только расплывчатое «PR AUC».
Для руководителя полезны два слоя: показатель качества ранжирования и последствия выбранного порога. Высокий AP не сообщает, сколько ложных тревог получит дежурный при текущей настройке. Сравнивая отчёты за разные периоды, учитывайте изменение доли срочных обращений и состава потока: одинаковое название метрики ещё не делает наборы сопоставимыми.
Какие данные запросить, чтобы пересчитать отчёт?
Для метрик при фиксированном решении достаточно идентификатора, эталонной категории и предсказанной категории. Для анализа порогов дополнительно нужна числовая оценка именно целевого класса. Полезно сохранить дату обращения, версию модели и правила отнесения к срочным.
Запросите одну строку на единицу оценки. Если единица — заявка, десять сообщений внутри неё не должны незаметно превращаться в десять независимых заявок. Дубликаты и повторные ответы на одно событие меняют веса наблюдений. Выбранное правило группировки необходимо применять одинаково к сравниваемым решениям.
Не заменяйте будущий рабочий поток искусственно сбалансированным набором без пояснения. Такой набор может помочь изучить редкий класс, но доля ложных тревог в реальном потоке будет зависеть от его состава. Сохраняйте раздельно диагностическую выборку и выборку, представляющую ожидаемую эксплуатацию.
Оценка классификатора — лишь часть эксплуатации. В статье о мониторинге LLM и ИИ-агентов разобраны соседние вопросы качества и технических ошибок. Здесь же результат работы — понятный расчёт по категориям и обоснованный выбор метрики, а не обещание готовности всей системы.
Как AI студия Владимира Ломтева помогает с классификацией?
AI студия Владимира Ломтева занимается подготовкой данных, разработкой ИИ-решений, интеграцией и тестированием. Для процесса распределения обращений можно обсудить подготовку эталонных категорий, интеграцию классификатора с очередью и сравнение вариантов на согласованной выборке.
Первый шаг — выбрать один поток обращений, описать текущий способ распределения, источники данных и ограничения. Критерий результата стоит сформулировать через допустимые пропуски срочных заявок и нагрузку на сотрудников. Конкретные значения определяются по данным компании; материал не обещает заранее заданного качества или экономии. Обсудить задачу.
Итог: какая метрика нужна для редких событий?
Для редкого важного класса начните с его support, TP, FP и FN. Precision покажет надёжность срабатываний, recall — полноту поиска, F1 — один из способов их объединить. При нескольких категориях сохраняйте показатели по каждой из них. Порог выбирайте под последствия ошибок на валидационных данных, а окончательную оценку проводите отдельно. Такой отчёт позволяет обсуждать конкретные потери и нагрузку вместо одного красивого процента.