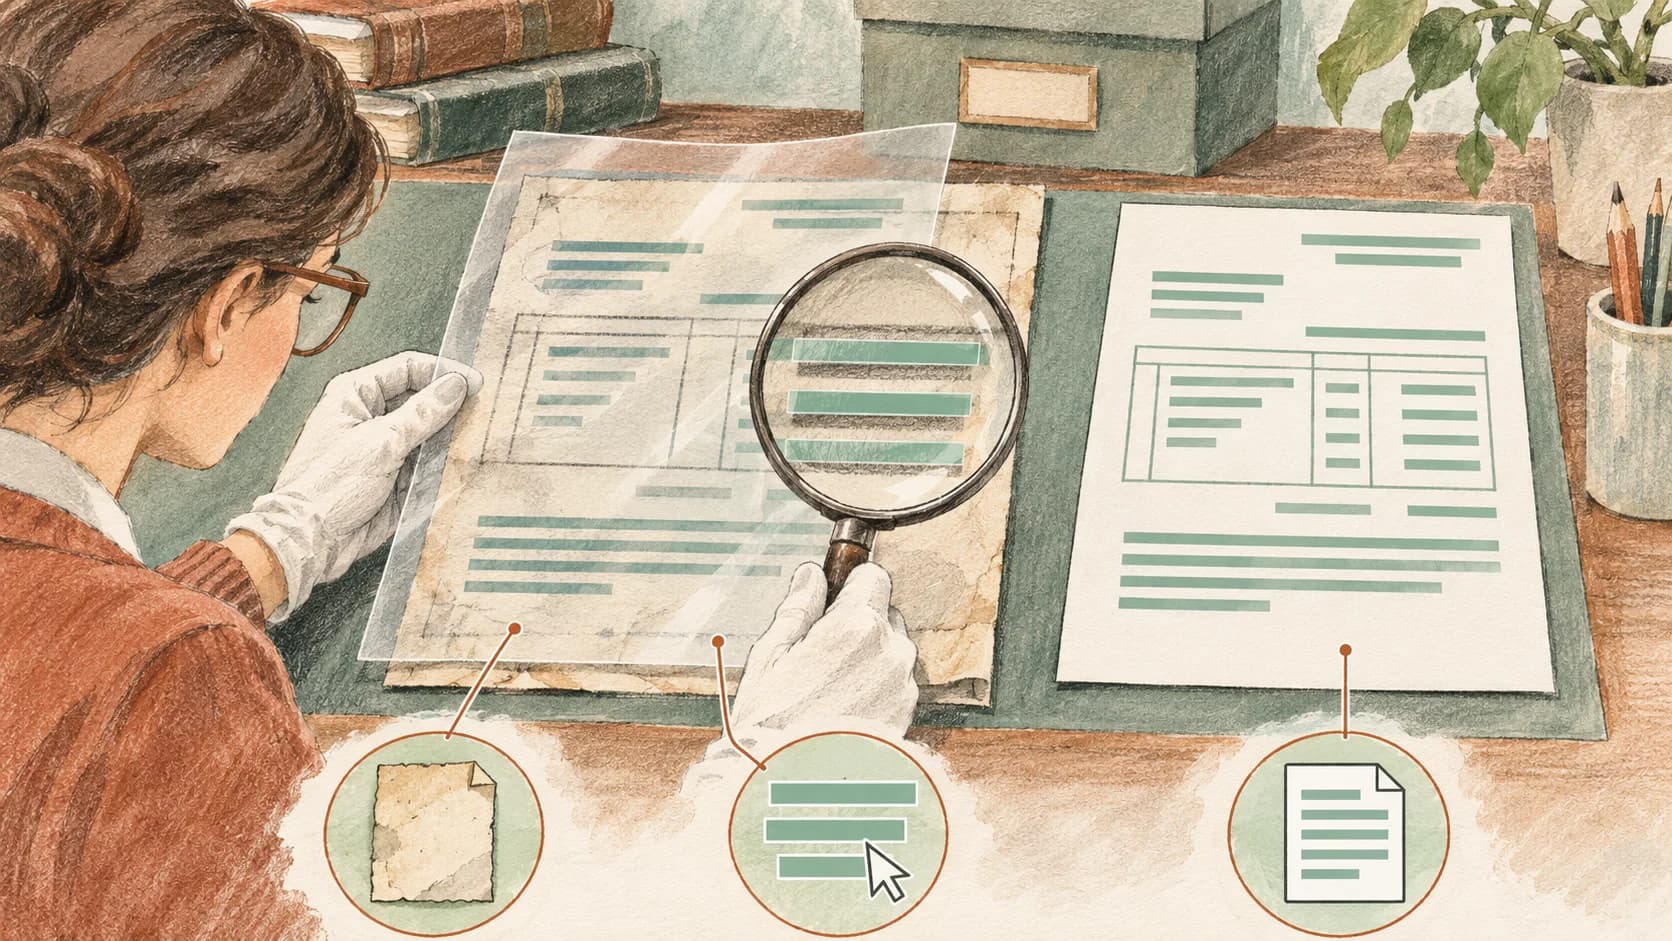
OCRmyPDF добавляет распознанный текст в PDF, чтобы по скану можно было искать и копировать содержимое. Если документ уже содержит текст, сначала нужно понять его происхождение: это полноценная цифровая страница, старый OCR-слой или смесь текста и изображений. От этого зависит выбор между пропуском страницы и повторным распознаванием.
FAQ подготовлен 6 ноября 2026 года для сотрудников документооборота и специалистов интеграций, которым нужен доступный для поиска PDF перед загрузкой в архив или базу знаний. Издатель — AI студия Владимира Ломтева. Ответы основаны на официальной документации OCRmyPDF. Команды ниже — предлагаемые примеры по документации; редакция не запускала их на файлах компании и не измеряла качество распознавания.
Содержание
- Чем поисковый PDF отличается от извлечённых полей документа?
- Что установить и как включить русский язык?
- Что выбрать: skip, redo или force?
- Почему skip не добавил текст в часть страницы?
- Когда нужны rotate-pages и deskew?
- Почему sidecar-файл не содержит весь текст PDF?
- Можно ли обрабатывать подписанные и недоверенные PDF?
- Как понять, что результат пригоден для архива и поиска?
Чем поисковый PDF отличается от извлечённых полей документа?
Поисковый PDF содержит текст, связанный со страницей документа. Это позволяет находить слова и копировать фрагменты, но не означает, что программа поняла назначение каждого числа. Сумма, дата, номер договора и банковские реквизиты требуют отдельного извлечения и проверки.
В описании OCRmyPDF задача инструмента связана с добавлением OCR-слоя к PDF. Рассматривайте такой файл как подготовленный источник для следующего этапа обработки. Поиск слова «итого» ещё не подтверждает правильность итоговой суммы в учётной системе.
Например, сотруднику архива достаточно найти документ по названию поставщика. Для переноса суммы в ERP нужно дополнительно определить поле, связать его с нужным документом и проверить значение. Это две разные цели. Общее устройство распознавания рассмотрено в материале OCR для бизнеса.
Что установить и как включить русский язык?
Нужны OCRmyPDF и зависимости выбранного способа установки, включая OCR-движок. Следуйте официальной инструкции установки для своей ОС: установка одного Python-пакета не должна подменять проверку внешних компонентов.
Для русскоязычного документа укажите -l rus, а для смешанного русского и английского — -l rus+eng. Соответствующие языковые данные должны быть установлены. Руководство по языкам объясняет, что OCRmyPDF не определяет нужный язык автоматически вместо пользователя.
Предлагаемый пример для обычного скана без готового текста:
ocrmypdf -l rus+eng input.pdf searchable.pdfДо запуска сохраните оригинал отдельно. Используйте разные пути входа и выхода и проверьте версию командой ocrmypdf --version. Если программа сообщает об отсутствии языка, исправьте установку языковых данных, а не оценивайте качество на другом языке. Успешное завершение команды означает, что обработка закончилась; читаемость результата всё равно нужно проверить.
Что выбрать: skip, redo или force?
Выбор зависит от существующего содержимого страницы. В разделе о режимах OCR описан параметр --mode; старые флаги сохраняются как совместимые варианты. Сверяйте доступность параметров с установленной версией.
| Состояние PDF | Режим для рассмотрения | Существенное ограничение |
|---|---|---|
| Смешаны сканы и хорошие цифровые страницы | --mode skip |
Страницы с текстом пропускаются целиком |
| Старый невидимый OCR нужно заменить | --mode redo |
Не всякий ошибочный слой распознаётся как невидимый |
| Обычного повторного OCR недостаточно | --mode force |
Содержимое страниц растеризуется |
При skip наличие текста на странице не означает, что распознаны все изображения на ней. Для redo программа анализирует существующий текст и заменяет невидимый OCR, сохраняя видимый текст там, где это предусмотрено механизмом. force превращает содержимое в изображение для нового распознавания, поэтому может изменить важные свойства исходного PDF.
Не начинайте с принудительного режима только ради исчезновения ошибки. Сначала выясните, какие элементы документа нужно сохранить: формы, векторную графику, ссылки или структурную разметку. Для архивной копии и интерактивного документа последствия могут быть разными.
Почему skip не добавил текст в часть страницы?
Потому что пропуск работает на уровне страницы. Если на ней уже найден текст, --mode skip оставляет такую страницу без OCR. Например, цифровой заголовок над изображением скана может стать причиной того, что остальной текст не появится в поиске.
Решение начинается с просмотра конкретной страницы: выделите заголовок и попробуйте выделить основной текст. Это предлагаемый диагностический приём, а не выполненная нами проверка файла. Если проблема связана со старым OCR или смешанным содержимым, изучите режим повторного распознавания в документации, прежде чем обрабатывать весь архив.
Для смешанного пакета полезно сначала сделать рабочую копию с несколькими характерными страницами: чистый скан, цифровая страница и страница с обоими видами содержимого. Один успешно обработанный титульный лист не подтверждает пригодность всех страниц документа.
Когда нужны rotate-pages и deskew?
--rotate-pages предназначен для исправления ориентации страницы, а --deskew — для выравнивания небольшого наклона. В сборнике рецептов OCRmyPDF эти операции различаются. Пример для скана, которому нужны обе коррекции:
ocrmypdf -l rus --rotate-pages --deskew input.pdf searchable.pdfЭто не универсальная команда для всех PDF. Если страница уже содержит текст и выбран режим пропуска, ожидаемая обработка изображений может не выполняться для неё. Сначала определите тип страницы и цель преобразования.
После коррекции проверьте вертикальную ориентацию, края таблиц, мелкие реквизиты и соответствие текста изображению. Автоматическое выравнивание не исправляет отсутствующие части скана. Если номер обрезан на исходном изображении, OCR не должен служить способом его достоверного восстановления.
Почему sidecar-файл не содержит весь текст PDF?
Параметр --sidecar сохраняет текст, полученный при OCR. По документации в него не включается существующий текст страниц, который не проходил распознавание. Поэтому sidecar не следует считать полной текстовой копией смешанного PDF.
ocrmypdf -l rus --mode skip --sidecar recognized.txt input.pdf searchable.pdfВ этом предлагаемом примере recognized.txt нужен для просмотра именно распознанного содержимого. Если часть страниц пропущена, отсутствие их текста в sidecar не означает, что они исчезли из выходного PDF. Проверяйте файл PDF и отдельную текстовую выгрузку как разные результаты.
Для полной передачи текста в базу знаний потребуется отдельное извлечение из итогового PDF и проверка порядка чтения. Если нужна ещё и разбивка общего пакета на счета, акты и договоры, это другая задача: см. FAQ о разделении PDF.
Можно ли обрабатывать подписанные и недоверенные PDF?
Для подписанного документа сохраняйте оригинал. Обработка меняет файл; нельзя обещать сохранение действительности электронной подписи после преобразования. В руководстве по безопасности OCRmyPDF рассматриваются цифровые подписи и работа с потенциально опасными PDF. Не отключайте защитные ограничения автоматически ради успешного завершения команды.
OCRmyPDF также не следует использовать как гарантию очистки недоверенного файла. Для вложений извне нужен изолированный процесс обработки с ограничениями доступа и ресурсов. Локальный запуск сам по себе не означает, что вредоносный документ безопасен для рабочего компьютера.
Это технические ограничения обработки, а не юридическое заключение о статусе конкретного документа. Если для процесса важен подписанный оригинал, результат OCR храните как производную копию и согласуйте порядок её использования с ответственным за документооборот.
Как понять, что результат пригоден для архива и поиска?
Проверьте не только завершение команды, но и те свойства, ради которых выполнялась обработка. Для выбранных страниц найдите несколько известных слов, скопируйте абзац и сравните его с изображением. Отдельно проверьте номера, даты, отрицания и символы в реквизитах: небольшая ошибка здесь может менять смысл.
Затем откройте начало, середину и конец документа, убедитесь в наличии страниц и читаемости важных элементов. Это предлагаемый порядок выборочной проверки, а не гарантия отсутствия ошибок во всём файле. Для массового архива задайте правила отбора страниц и направления сомнительных результатов человеку.
Критерий готовности зависит от цели. Для поиска по архиву важна находимость документов. Для ответов RAG-системы — ещё и корректный текст с привязкой к странице. Для учётной операции требуется самостоятельная проверка извлечённых полей. Поисковый PDF решает только часть этой цепочки.
Как AI студия Владимира Ломтева помогает с обработкой документов
AI студия Владимира Ломтева может связать подготовку документов с корпоративным поиском: организовать обработку входящих файлов, подготовить извлечение текста для базы знаний и проверить передачу результатов в бизнес-систему. Это задачи обработки документов, подготовки данных и интеграции; пригодность конкретного инструмента определяется на материалах процесса.
Первый шаг — выбрать один поток документов, описать исходное качество, источники, ограничения и критерий готового результата. Обсудить задачу.
Итог: выбирайте режим по содержимому страницы
Для скана нужен OCR, для хорошего цифрового текста — сохранение уже доступного содержимого, для неудачного старого распознавания — осознанный выбор повторной обработки. Храните оригинал и проверяйте выходной PDF отдельно от sidecar. Наличие поискового слоя помогает работать с документом, но не подтверждает правильность всех его данных.