Статьи по тегу: локальный инференс LLM

Найдено статей: 11

LLM на нескольких GPU: tensor parallelism и реплики
14.11.2026
LLM на нескольких GPU
LLM на нескольких GPU инструкция
локальный инференс LLM

Как запускать LLM на нескольких GPU: tensor, pipeline и data parallelism, реплики, NVLink и PCIe, память, задержка и проверка масштабирования.

Читать
Мониторинг vLLM: Prometheus, Grafana и метрики GPU
14.11.2026
мониторинг vLLM Prometheus Grafana
мониторинг vLLM Prometheus Grafana инструкция
локальный инференс LLM

Как настроить мониторинг vLLM: сбор /metrics в Prometheus, панели Grafana, очередь, задержки, память GPU, алерты и диагностика деградации.

Читать
LLM без интернета: запуск в полностью закрытом контуре
14.11.2026
LLM в закрытом контуре
LLM в закрытом контуре инструкция
локальный инференс LLM

Как подготовить локальную LLM для закрытого контура: перенос весов и контейнеров, офлайн-зависимости, проверка сети, обновление и откат.

Читать
KV-cache и prefix caching: как ускорить локальную LLM
14.11.2026
KV-cache prefix caching
KV-cache prefix caching инструкция
локальный инференс LLM

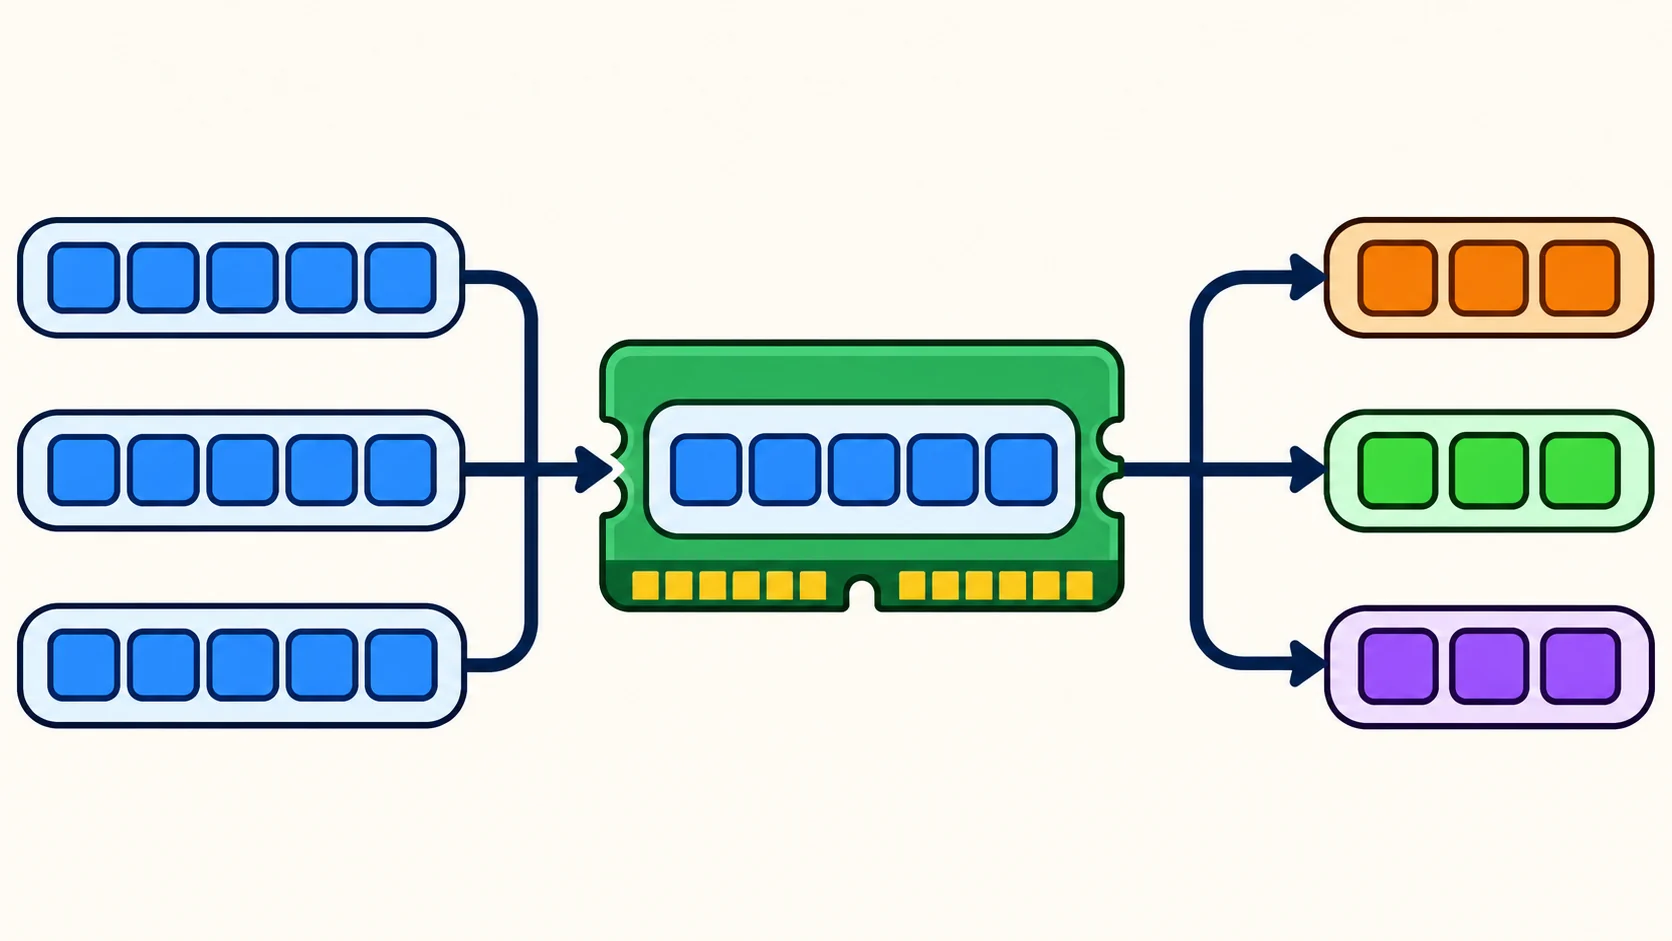
Как работают KV-cache и prefix caching в LLM: память, повторные промпты, порядок контекста, проверка попаданий в кэш и ограничения ускорения.

Читать
LLM не помещается в видеопамять: как исправить OOM
14.11.2026
LLM не помещается в видеопамять
LLM не помещается в видеопамять инструкция
локальный инференс LLM

Что делать, если локальная LLM не помещается в VRAM: диагностика OOM при загрузке и под нагрузкой, контекст, KV-cache, квантизация и offload.

Читать
Нагрузочный тест локальной LLM: задержка и скорость
14.11.2026
нагрузочный тест LLM
нагрузочный тест LLM инструкция
локальный инференс LLM

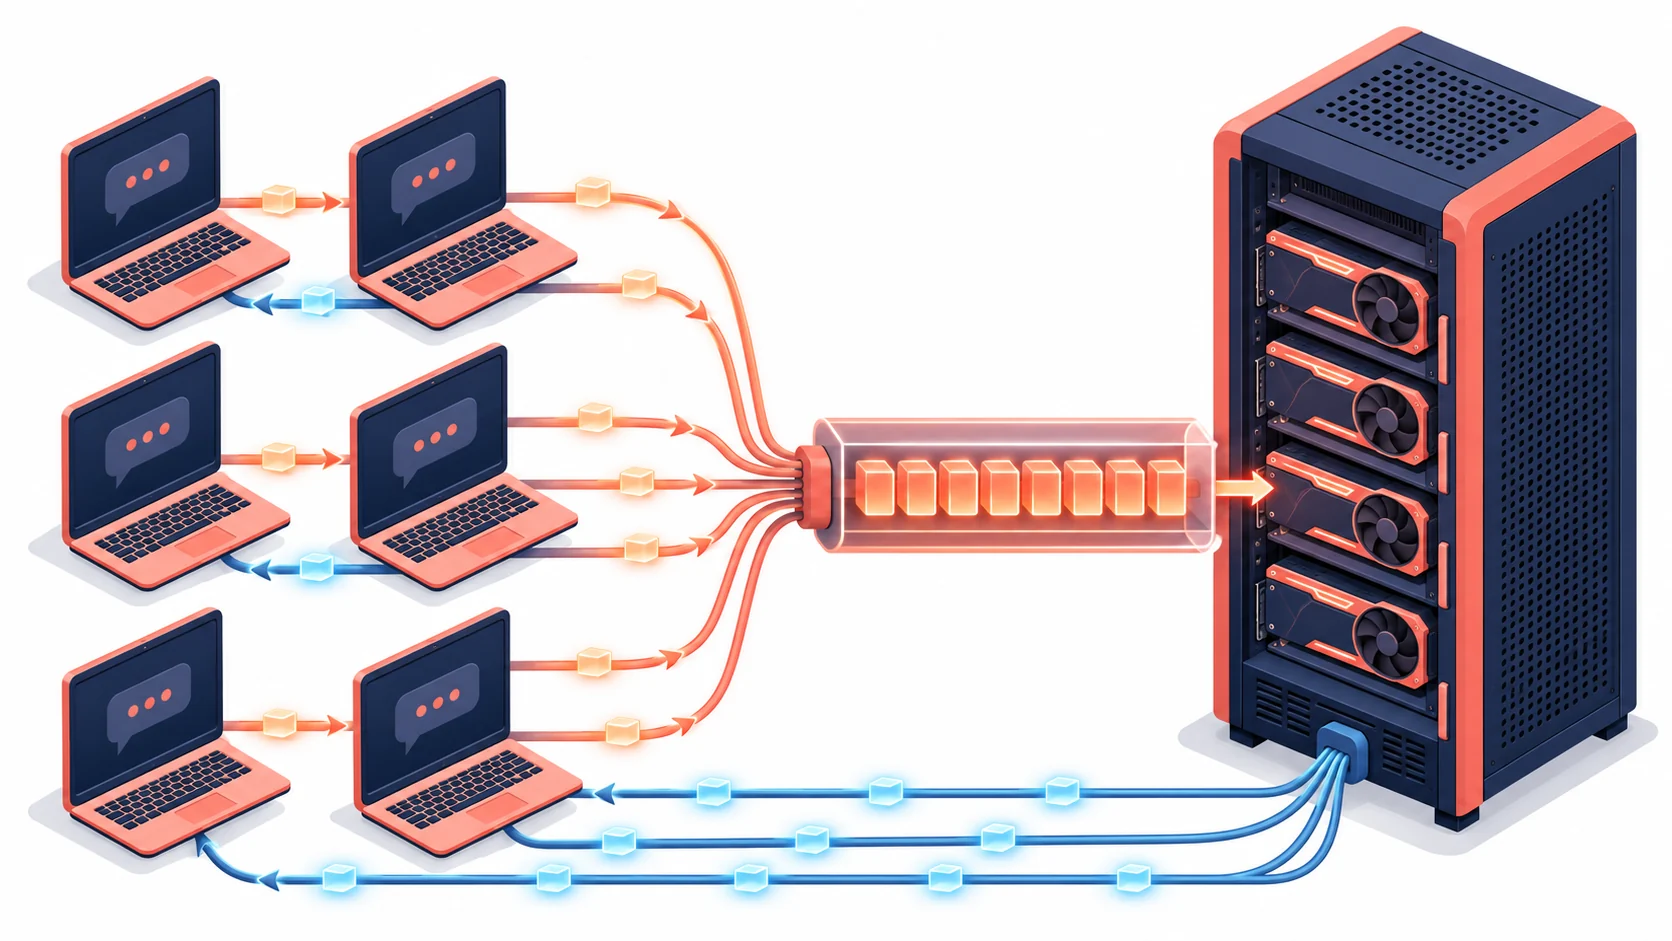
Как провести нагрузочный тест локальной LLM: TTFT, TPOT, p95, throughput, параллельные запросы, холодный и прогретый кэш, критерии приёмки.

Читать
Как запустить vLLM в Docker: GPU-сервер и API
14.11.2026
vLLM Docker запуск
vLLM Docker запуск инструкция
локальный инференс LLM

Развёртывание vLLM в Docker: проверка GPU, загрузка модели, локальный API, настройки контекста, защита доступа и диагностика первого запуска.

Читать
Сколько VRAM нужно для LLM: веса, контекст и нагрузка
14.11.2026
сколько VRAM нужно для LLM
сколько VRAM нужно для LLM инструкция
локальный инференс LLM

Как рассчитать VRAM для локальной LLM: веса модели, KV-cache, длина контекста, параллельные запросы, квантизация и проверка перед покупкой GPU.

Читать
Локальная LLM через Ollama: установка, запуск и API
14.11.2026
локальная LLM Ollama
локальная LLM Ollama инструкция
локальный инференс LLM

Как запустить локальную LLM через Ollama: установка на Windows, macOS и Linux, выбор модели, первый API-запрос, проверка GPU и частые ошибки.

Читать
Свой инференс или API: кому и когда нужен свой сервер
14.11.2026
свой инференс или API
свой инференс или API инструкция
локальный инференс LLM

Когда бизнесу нужен собственный инференс LLM, а когда лучше API: данные, качество, нагрузка, команда, стоимость, готовность к эксплуатации и гибрид.

Читать
Движки инференса LLM и ускорение: подробный гид
14.11.2026
движки инференса LLM ускорение
движки инференса LLM ускорение инструкция
локальный инференс LLM

Как устроены движки инференса LLM и ускорение генерации: prefill, decode, batching, PagedAttention, FlashAttention, квантизация и speculative decoding.

Читать